AI 기초 › 10장
신경망과 역전파
3부(딥러닝)를 시작한다. 06장 로지스틱 회귀는 원 모양 경계를 풀려면 제곱 특성을 사람이 직접 만들어야 했다. 신경망은 그 특성을 스스로 배운다. 이 장은 먼저 PyTorch의 배열인 텐서(tensor)와 자동 미분을 최소한으로 익히고, 퍼셉트론 하나로는 못 푸는 문제를 층을 쌓은 다층 퍼셉트론(MLP, Multi-Layer Perceptron)으로 푼다. 그다음 신경망 학습의 핵심 계산인 역전파(backpropagation)를 NumPy로 직접 구현하고, 수치 미분과 PyTorch 자동 미분(autograd)으로 같은 값이 나오는지 확인한다. 학습 루프를 PyTorch 도구(옵티마이저·DataLoader)로 정리하는 일은 11장에서 한다.
10-1. 이 장의 목표와 완료 기준
섹션 제목: “10-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 텐서를 다룬다 | 텐서를 만들고 shape·dtype을 읽으며, NumPy 배열과 오가는 두 방법(복사·메모리 공유)의 차이를 말한다 |
| 자동 미분을 쓴다 | requires_grad·backward·.grad로 기울기를 구하고, 기울기가 쌓이는 것과 torch.no_grad()가 필요한 이유를 말한다 |
| 층이 필요한 이유를 말한다 | 퍼셉트론이 XOR을 못 푸는 이유와, 은닉층이 입력을 새 특성으로 바꿔 푸는 과정을 보인다 |
| 활성화 함수를 고른다 | 시그모이드·tanh·ReLU의 값과 미분을 계산하고, 활성화 함수가 없으면 층을 쌓아도 선형임을 보인다 |
| 역전파를 구현한다 | 은닉층 1개 MLP의 기울기를 NumPy로 계산해 수치 미분·autograd와 맞춘다 |
| 직접 학습한다 | 경사하강법으로 MLP를 학습해 로지스틱 회귀가 못 푼 원 데이터를 풀고, 초기화가 결과를 바꾸는 경우를 말한다 |
nn 모듈로 옮긴다 |
nn.Sequential의 가중치 모양을 읽고, 직접 만든 MLP와 같은 출력을 내게 한다 |
| 선택 기준표에 줄을 더한다 | 신경망(MLP)을 언제 고르고 학습이 안 될 때 무엇부터 보는지 적는다 |
| 실습 노트북 10을 끝낸다 | 실습/문제/ch10_신경망과_역전파.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 2시간, 실습 1시간 30분.
10-2. 왜 신경망인가
섹션 제목: “10-2. 왜 신경망인가”- 특성을 배운다. 선형 모델은 “특성에 대해 선형”이라서, 휘어진 경계가 필요하면 제곱·곱 특성을 사람이 만들어야 했다(06장). 신경망은 앞쪽 층이 입력을 새 특성으로 바꾸고, 마지막 층이 그 특성으로 06장 로지스틱 회귀를 한다. 어떤 특성을 만들지도 학습이 정한다.
- 원본 데이터에 강하다. 픽셀 하나, 글자 하나에는 뜻이 없다. 층을 여러 개 쌓은 신경망은 그런 원본에서 쓸모 있는 특성을 층층이 만들어 낸다. 이미지(12장), 문장(13·14장), LLM(16장)이 모두 이 위에 있다.
- 표 데이터에서는 아직 트리가 먼저다. 특성 하나하나에 뜻이 있는 표 데이터에서는 7장 트리 앙상블이 대체로 더 빠르고 강하다. 이 장은 신경망의 원리를 익히는 장이고, 작은 2차원 데이터로 그 원리를 눈으로 본다.
- 학습 원리는 04·06장 그대로다. 예측 → 손실 → 기울기 → 경사하강법. 달라지는 것은 기울기 계산이 길어진다는 점 하나이고, 그 계산이 역전파다.
10-3. PyTorch 텐서 최소 입문
섹션 제목: “10-3. PyTorch 텐서 최소 입문”텐서는 NumPy 배열과 거의 같다
섹션 제목: “텐서는 NumPy 배열과 거의 같다”텐서는 PyTorch의 다차원 배열이다. shape·축·브로드캐스팅·행렬곱 규칙이 02장 NumPy와 같고, 축을 axis= 대신 dim=으로 적는다.
import numpy as npimport torch
t = torch.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])print(t.shape, t.ndim, t.dtype)print(t.sum(dim=0), t.mean(dim=1)) # NumPy의 axis= 자리에 dim=print((t @ t.T).shape, (t + torch.tensor([10.0, 20.0, 30.0])).tolist()) # 행렬곱, 브로드캐스팅print(torch.zeros(2, 3).dtype, torch.tensor([1, 2]).dtype, np.array([1.0]).dtype)torch.Size([2, 3]) 2 torch.float32tensor([5., 7., 9.]) tensor([2., 5.])torch.Size([2, 2]) [[11.0, 22.0, 33.0], [14.0, 25.0, 36.0]]torch.float32 torch.int64 float64t.shape는torch.Size([2, 3])로 나오지만 튜플처럼 쓴다(t.shape[0]은 2).- 기본 실수 dtype이 다르다. PyTorch는
float32(4바이트), NumPy는float64(8바이트)다. 신경망은 float32로 계산하는 것이 기본이다. 정수로 만들면int64다.
NumPy와 오가기
섹션 제목: “NumPy와 오가기”a = np.array([1.0, 2.0, 3.0])shared = torch.from_numpy(a) # 메모리 공유, dtype 유지(float64)copied = torch.tensor(a, dtype=torch.float32) # 복사 + float32로a[0] = 100.0print(shared)print(copied)back = copied.numpy()print(type(back).__name__, back.dtype, copied[1].item(), type(copied[1].item()).__name__)tensor([100., 2., 3.], dtype=torch.float64)tensor([1., 2., 3.])ndarray float32 2.0 floattorch.from_numpy는 같은 메모리를 쓴다. 원래 배열을 바꾸면 텐서도 바뀐다. 복사가 없어 빠르지만, 모르고 쓰면 엉뚱한 곳의 값이 바뀐다.torch.tensor(a)는 늘 복사한다.from_numpy는 dtype도 그대로(float64) 가져온다. 10-10절에서 보듯 float32 모델에 float64를 넣으면 오류가 난다. sklearn·pandas에서 온 데이터는torch.tensor(a, dtype=torch.float32)로 바꿔 넣는다..numpy()는 CPU 텐서를 NumPy 배열로 바꾸며 메모리를 공유한다..item()은 원소 하나짜리 텐서에서 파이썬 숫자를 꺼낸다. 손실 값을 기록할 때 쓴다.
requires_grad와 backward: 자동 미분
섹션 제목: “requires_grad와 backward: 자동 미분”텐서를 requires_grad=True로 만들면 PyTorch가 그 텐서로 한 계산을 그래프로 기록한다. 결과(스칼라)에서 backward()를 부르면 기록을 거꾸로 따라가며 미분해, 사용자가 직접 requires_grad=True로 만든 텐서(아래 잎 텐서, 이 예에서는 x)의 .grad에 기울기를 더한다. 계산 도중 생긴 중간 텐서의 .grad는 따로 요청(retain_grad())하지 않으면 채워지지 않는다. 이것이 자동 미분(autograd)이다. 04장에서 식으로 유도하고 수치 미분으로 검산하던 일을 대신 해 준다.
x = torch.tensor(3.0, requires_grad=True)y = x ** 2 + 2 * x                                                  # dy/dx = 2x + 2 = 8print(y.item(), type(y.grad_fn).__name__)y.backward()print(x.grad)
y = x ** 2 + 2 * xy.backward()print(x.grad) # 비우지 않으면 더해진다: 8 + 8x.grad.zero_()print(x.grad)15.0 AddBackward0tensor(8.)tensor(16.)tensor(0.)y.grad_fn은 y를 만든 계산(여기서는 덧셈)의 기록이다.requires_grad=True인 텐서로 미분할 수 있는 계산을 하면 결과가 이 기록을 달고 다닌다(argmax처럼 미분할 수 없는 계산의 결과는 기록이 끊긴다).- 기울기는 쌓인다.
backward()는.grad를 덮어쓰지 않고 더한다. 위 코드에서 두 번째backward()전에y를 다시 계산한 것은, 한 번 역전파한 그래프는 기본적으로 저장값을 지워 다시 쓸 수 없기 때문이다(같은 그래프로 또 부르면 오류가 난다). 학습 루프에서는 스텝마다 기울기를 비워야 한다(.grad.zero_(), 11장에서는optimizer.zero_grad()). 빼먹으면 오류 없이 학습이 망가진다(10-9절). backward()는 스칼라에서 부른다. 손실이 평균 하나로 줄어든 값이라 그대로 된다.
갱신은 기록 밖에서
섹션 제목: “갱신은 기록 밖에서”w = torch.tensor([1.0, 2.0], requires_grad=True)try: w -= 0.1 # 기록 중인 텐서를 제자리에서 수정except RuntimeError as e: print("오류:", e)
with torch.no_grad(): # 이 안의 계산은 기록하지 않는다 w -= 0.1 z = w * 2print(w, z.requires_grad)
try: w.numpy()except RuntimeError as e: print("오류:", e)print(w.detach().numpy())오류: a leaf Variable that requires grad is being used in an in-place operation.tensor([0.9000, 1.9000], requires_grad=True) False오류: Can't call numpy() on Tensor that requires grad. Use tensor.detach().numpy() instead.[0.9 1.9]- 사용자가 직접 만든
requires_grad=True텐서를 잎 텐서(leaf tensor)라 한다. 학습할 매개변수가 잎 텐서다. 경사하강법의 갱신 는 “학습 계산”이 아니므로torch.no_grad()안에서 한다. 그러지 않으면 위처럼 오류가 나거나, 갱신까지 그래프에 기록된다. torch.no_grad()안에서 만든z는 기록이 없다(requires_gradFalse). 검증·추론처럼 미분이 필요 없는 계산도 이 안에서 하면 메모리와 시간을 아낀다(11장).- 기록을 단 텐서는
.numpy()로 바로 못 바꾼다..detach()로 기록에서 떼어 낸 뒤 바꾼다. - 반대로
requires_grad=False인 매개변수는 이후 역전파에서 기울기가 새로 생기지 않는다. 사전학습 모델의 일부만 학습하는 동결(freezing)이 이 원리다(15장). 학습 도중에 동결한다면 이미 남아 있던.grad가 갱신에 쓰이지 않도록None으로 비우거나 그 매개변수를 갱신 대상에서 뺀다.
10-4. 퍼셉트론에서 다층 퍼셉트론으로
섹션 제목: “10-4. 퍼셉트론에서 다층 퍼셉트론으로”퍼셉트론과 XOR
섹션 제목: “퍼셉트론과 XOR”퍼셉트론(perceptron, 1958년)은 선형 점수 가 0 이상이면 1, 아니면 0을 내는 모델이다. 06장 로지스틱 회귀의 시그모이드 자리에 계단 함수(step function)가 있는 셈이다. 틀린 표본을 만날 때마다 로 고치는 단순한 규칙으로 학습한다.
def step(z):    return (np.asarray(z) >= 0).astype(int)
def perceptron(X, y, epochs=8):    w, b, errors = np.zeros(X.shape[1]), 0.0, []    for _ in range(epochs):        n_err = 0        for xi, yi in zip(X, y):            diff = yi - step(xi @ w + b)                            # 맞으면 0, 틀리면 +1 또는 -1            w, b = w + diff * xi, b + diff            n_err += int(diff != 0)        errors.append(n_err)    return w, b, errors
X4 = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])for name, y4 in [("AND", [0, 0, 0, 1]), ("OR", [0, 1, 1, 1]), ("XOR", [0, 1, 1, 0])]: w, b, errors = perceptron(X4, np.array(y4)) print(f"{name}: 에폭별 틀린 수 {errors}, 최종 예측 {step(X4 @ w + b)}")AND: 에폭별 틀린 수 [2, 3, 3, 2, 1, 0, 0, 0], 최종 예측 [0 0 0 1]OR: 에폭별 틀린 수 [2, 2, 1, 0, 0, 0, 0, 0], 최종 예측 [0 1 1 1]XOR: 에폭별 틀린 수 [3, 3, 4, 4, 4, 4, 4, 4], 최종 예측 [1 1 0 0]- 데이터를 한 바퀴 다 보는 것을 에폭(epoch)이라 한다. AND·OR은 몇 에폭 만에 틀린 수가 0이 되고 멈춘다. 직선 하나로 나눌 수 있는 데이터는 이 규칙이 결국 다 맞힌다.
- XOR(둘 중 하나만 1이면 1)은 끝까지 틀린다. (0, 1)·(1, 0)은 1이고 (0, 0)·(1, 1)은 0이라, 어떤 직선을 그어도 한쪽에 두 범주가 섞인다. 06장 원 데이터와 같은 문제다. 층 하나짜리 퍼셉트론의 이런 한계는 1969년 민스키(Minsky)·패퍼트(Papert)의 책 『Perceptrons』로 널리 알려졌고, 층을 쌓은 신경망을 학습시키는 방법(역전파)이 1986년 널리 알려지기 전까지 신경망 연구는 주춤했다(01장 1-4절).
층을 하나 더하면 풀린다
섹션 제목: “층을 하나 더하면 풀린다”퍼셉트론 두 개(OR, AND)의 출력을 새 특성으로 삼고, 그 위에 퍼셉트론 하나를 더 얹는다. 가중치는 손으로 정한다.
W1 = np.array([[1.0, 1.0], [1.0, 1.0]]) # 열 하나가 은닉 유닛 하나b1 = np.array([-0.5, -1.5]) # 유닛 1: OR, 유닛 2: ANDw2, b2 = np.array([1.0, -1.0]), -0.5 # OR이고 AND가 아니면 1H4 = step(X4 @ W1 + b1)print(H4.tolist(), step(H4 @ w2 + b2))[[0, 0], [1, 0], [1, 0], [1, 1]] [0 1 1 0]- 가운데 층을 은닉층(hidden layer), 그 안의 퍼셉트론 하나를 유닛(unit, 뉴런)이라 한다. 은닉층은 네 점을 (0, 0), (1, 0), (1, 0), (1, 1)로 옮긴다. 새 좌표에서는 1인 두 점이 한곳에 모여 직선 하나로 나뉜다.
- 이것이 신경망의 핵심 구조다. 앞 층이 입력을 직선으로 나눌 수 있는 새 특성으로 바꾸고, 마지막 층이 선형 분류를 한다. 층이 여럿인 이 구조를 다층 퍼셉트론(MLP)이라 한다. 입력에서 출력으로 한 방향으로만 계산이 흐르므로 순방향 신경망(feedforward network)이라고도 한다.
- 그런데 위 가중치는 사람이 정했다. 학습으로 정하려면 경사하강법이 필요하고, 계단 함수는 거의 모든 곳에서 미분이 0이라 기울기가 전해지지 않는다. 그래서 계단 대신 미분할 수 있는 활성화 함수(activation function)를 쓴다.
10-5. 활성화 함수
섹션 제목: “10-5. 활성화 함수”활성화 함수가 없으면 층을 쌓아도 선형이다
섹션 제목: “활성화 함수가 없으면 층을 쌓아도 선형이다”선형 층 두 개를 이어 붙이면 라서 선형 층 하나와 같다. 층을 몇 개 쌓아도 직선 경계밖에 못 만든다. 그래서 층 사이에 비선형 함수를 넣는다.
rng = np.random.default_rng(0)A1, A2, Xr = rng.normal(size=(2, 8)), rng.normal(size=(8, 1)), rng.normal(size=(5, 2))print(np.allclose((Xr @ A1) @ A2, Xr @ (A1 @ A2)), (A1 @ A2).shape)True (2, 1)절편을 더해도 마찬가지다(선형식에 선형식을 넣으면 선형식). 활성화 함수는 층마다 이 “합쳐짐”을 끊는다.
세 가지 활성화 함수
섹션 제목: “세 가지 활성화 함수”| 이름 | 식 | 미분 | 출력 범위 |
|---|---|---|---|
| 시그모이드(sigmoid) | , 최대 0.25 | 0 ~ 1 | |
| 쌍곡탄젠트(tanh) | , 최대 1 | −1 ~ 1 | |
| 정류 선형 함수(ReLU, Rectified Linear Unit) | 이면 1, 이면 0 | 0 ~ ∞ |
식으로 쓴 미분을 autograd와 맞춰 본다.
zn = np.linspace(-4, 4, 5)s = 1 / (1 + np.exp(-zn))by_hand = {"sigmoid": s * (1 - s), "tanh": 1 - np.tanh(zn) ** 2, "relu": (zn > 0).astype(float)}
z = torch.tensor(zn, requires_grad=True) # float64 그대로for name, f in [("sigmoid", torch.sigmoid), ("tanh", torch.tanh), ("relu", torch.relu)]: z.grad = None # 앞 함수의 기울기를 지운다 out = f(z) out.sum().backward() # 원소마다 따로 미분한 값이 된다 same = np.allclose(z.grad.numpy(), by_hand[name]) print(f"{name:7s} 값 {out.detach().numpy().round(3)} 미분 {z.grad.numpy().round(3)} 식과 같음 {same}")sigmoid 값 [0.018 0.119 0.5 0.881 0.982] 미분 [0.018 0.105 0.25 0.105 0.018] 식과 같음 Truetanh 값 [-0.999 -0.964 0. 0.964 0.999] 미분 [0.001 0.071 1. 0.071 0.001] 식과 같음 Truerelu 값 [0. 0. 0. 2. 4.] 미분 [0. 0. 0. 1. 1.] 식과 같음 True← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
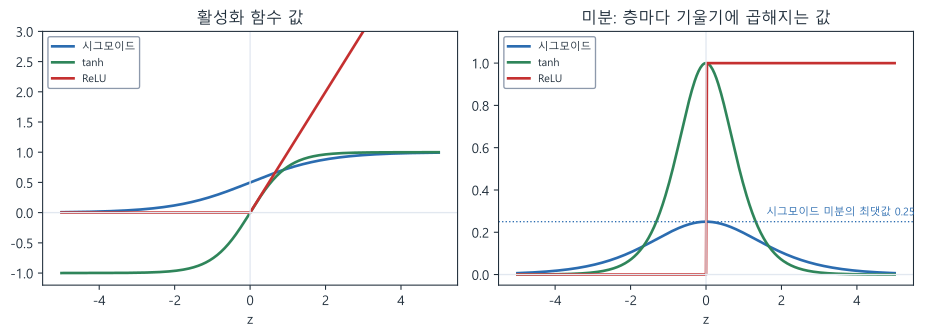
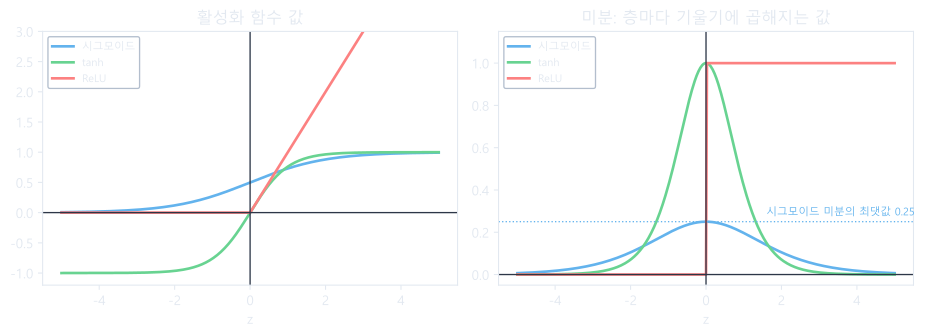
그림 설명. 두 그림 모두 가로축은 (−5~5)다. 왼쪽은 함숫값이다. 시그모이드(파랑)는 0에서 1로 완만하게 오르고, tanh(초록)는 −1에서 1로 더 가파르게 오르며, ReLU(빨강)는 0 이하에서 0, 그 위에서 기울기 1인 직선이다. 오른쪽은 미분이다. 시그모이드 미분은 에서 가장 큰 0.25이고(점선 표시) 양쪽으로 0에 가까워진다. tanh 미분은 에서 1로 솟았다가 양쪽에서 0에 가까워진다. ReLU 미분은 0 이하에서 0, 0 위에서 1인 계단이다.
out.sum().backward(): 출력 원소 하나가 자기 입력 하나에만 달려 있으므로, 합을 미분하면 원소별 미분이 그대로 나온다.- 시그모이드는 06장 출력층의 그 함수다. 미분이 아무리 커도 0.25이고 가 크면 거의 0이다. 은닉층에 쓰면 층을 지날 때마다 기울기가 줄어든다(10-11절 기울기 소실).
- tanh는 시그모이드를 −1~1로 늘린 모양이다(). 0 근처 미분이 1이라 시그모이드보다 기울기가 잘 전해진다. 13장 RNN에서 쓴다.
- ReLU는 음수를 0으로 자르기만 한다. 계산이 싸고, 켜진() 유닛은 기울기 1을 그대로 넘긴다. 은닉층의 기본 선택이다. 에서는 미분이 정의되지 않는데, PyTorch는 0으로 계산한다(위 출력의 가운데 0). 꺼진 유닛()은 기울기가 0이라, 모든 표본에서 꺼지면 그 유닛은 더 학습되지 않는다(죽은 ReLU).
- 출력층의 활성화는 문제가 정한다. 이진 분류는 시그모이드, 다중 분류는 소프트맥스(06장), 회귀는 활성화 없음.
10-6. 순전파: MLP가 예측을 만드는 과정
섹션 제목: “10-6. 순전파: MLP가 예측을 만드는 과정”06장에서 로지스틱 회귀가 정확도 0.433에 그친 원 데이터를 쓴다. 특성은 원래 좌표 2개뿐이고, 제곱 특성은 만들지 않는다. 두 좌표의 크기가 이미 비슷하므로(대략 −1.2 ~ 1.2) 표준화는 생략한다. 표 데이터처럼 단위가 다르면 04장처럼 먼저 표준화한다.
은닉 유닛 h개, ReLU, 출력 시그모이드인 MLP의 계산 순서는 다음과 같다. 입력에서 손실까지 앞으로 계산하는 것을 순전파(forward pass)라 한다.
| 단계 | 식 | 모양 (N개 표본, 특성 d, 은닉 h) |
|---|---|---|
| 은닉 점수 | (N, d) @ (d, h) + (h,) → (N, h) | |
| 은닉 출력 | (N, h) | |
| 출력 점수 | (N, h) @ (h,) + 스칼라 → (N,) | |
| 확률 | (N,) | |
| 손실 | = 평균 로그 손실 | 스칼라 |
from sklearn.datasets import make_circlesfrom sklearn.model_selection import train_test_split
Xc, yc = make_circles(n_samples=300, factor=0.5, noise=0.1, random_state=0)c_tr, c_va, yc_tr, yc_va = train_test_split(Xc, yc, test_size=0.3, stratify=yc, random_state=0)
def sigmoid(z):    return 1 / (1 + np.exp(-z))
def bce(y, p):    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p))
def init_params(d, h, seed):    rng = np.random.default_rng(seed)    return {"W1": rng.normal(0, 1 / np.sqrt(d), (d, h)), "b1": np.zeros(h),            "w2": rng.normal(0, 1 / np.sqrt(h), h), "b2": 0.0}
def forward(X, P):    A = X @ P["W1"] + P["b1"]                                       # (N, h) 은닉 점수    H = np.maximum(A, 0)                                            # (N, h) ReLU    z = H @ P["w2"] + P["b2"]                                       # (N,) 06장 로지스틱 회귀의 z    return {"A": A, "H": H, "z": z, "p": sigmoid(z)}
P = init_params(2, 8, seed=0)cache = forward(c_tr, P)print({k: v.shape for k, v in cache.items()})print("매개변수 수", sum(np.size(v) for v in P.values()), "/ 학습 전 손실", round(bce(yc_tr, cache["p"]), 4)){'A': (210, 8), 'H': (210, 8), 'z': (210,), 'p': (210,)}매개변수 수 33 / 학습 전 손실 0.6846- 매개변수는 2×8 = 16, 8, 8, 1, 모두 33개다.
- 마지막 두 줄(, )은 06장 로지스틱 회귀 그대로다. 입력이 원래 특성 가 아니라 은닉층이 만든 특성 일 뿐이다. “은닉층 = 학습되는 특성 공학, 출력층 = 로지스틱 회귀”로 읽으면 된다.
- 가중치는 0이 아닌 작은 난수로 시작한다. 표준편차 는 층을 지나도 값의 크기가 크게 변하지 않게 고른 값이다. 왜 0으로 시작하면 안 되는지는 10-8절에서 본다. 처음 확률이 대부분 0.5 근처라 학습 전 손실도 근처다. 거꾸로 평균 손실이 라는 것만으로 확률이 0.5 근처라고 단정할 수는 없으므로, 궁금하면 확률 자체를 본다.
forward는 중간값 A·H·z·p를 모두 돌려준다. 역전파가 이 값들을 다시 쓰기 때문이다.
10-7. 역전파를 NumPy로
섹션 제목: “10-7. 역전파를 NumPy로”계산 그래프와 연쇄 법칙
섹션 제목: “계산 그래프와 연쇄 법칙”역전파는 연쇄 법칙(chain rule)을 계산 순서의 반대로 적용하는 방법이다. 작은 식 으로 먼저 해 본다. 계산을 한 단계씩 나누면 , , 이다.
- 순전파: 왼쪽에서 오른쪽으로 , , 의 값을 계산해 둔다.
- 역전파: 오른쪽 끝 에서 시작해, 각 단계의 국소 미분(그 단계 하나의 미분)을 곱하며 왼쪽으로 온다. , , , .
w, x, b, y = 2.0, 3.0, 1.0, 5.0u = w * x + b                                                       # 순전파: 값을 계산해 둔다e = u - yL = e ** 2dL_de = 2 * e                                                       # 역전파: 끝에서부터 국소 미분을 곱한다dL_du = dL_de * 1dL_dw, dL_db = dL_du * x, dL_du * 1print(L, dL_dw, dL_db)
wt, bt = torch.tensor(w, requires_grad=True), torch.tensor(b, requires_grad=True)Lt = (wt * x + bt - y) ** 2Lt.backward()print(Lt.item(), wt.grad.item(), bt.grad.item())4.0 12.0 4.04.0 12.0 4.0- 국소 미분에 순전파 때 계산한 값(, )이 들어간다. 그래서 순전파 값을 저장해 두고 역전파에서 쓴다. 신경망 학습이 메모리를 많이 쓰는 이유 중 하나다.
- 어떤 매개변수의 기울기든 “끝에서 그 매개변수까지 가는 길의 국소 미분을 모두 곱한 것”이고, 길이 여러 개면 길마다의 곱을 더한다(MLP에서는 표본마다, 은닉 유닛마다 길이 갈린다). 앞쪽 층의 매개변수일수록 곱하는 항이 많다. 역전파는 뒤쪽에서 계산한 곱( 같은)을 앞쪽에서 다시 쓰므로, 매개변수가 수백만 개여도 순전파와 비슷한 비용으로 모든 기울기를 한 번에 구한다. 04장의 수치 미분은 매개변수마다 손실을 두 번씩 계산해야 했다.
MLP의 역전파
섹션 제목: “MLP의 역전파”10-6절 표를 아래에서 위로 거슬러 올라간다. 손실이 평균이라 이 붙는다.
| 단계 (순전파) | 역전파로 구하는 것 |
|---|---|
| , = 평균 로그 손실 | (06장, 시그모이드 미분이 약분됨) |
| , , (외적, ) | |
| (는 원소별 곱) | |
| , = 를 표본 축으로 합 |
def backward(X, y, P, c):    N = len(y)    dz = (c["p"] - y) / N                                           # (N,)    g = {"w2": c["H"].T @ dz, "b2": dz.sum()}    dH = np.outer(dz, P["w2"])                                      # (N, h) 외적: dH[i, j] = dz[i] * w2[j]    dA = dH * (c["A"] > 0)                                          # ReLU: 켜진 유닛으로만 기울기가 지나간다    g["W1"] = X.T @ dA                                              # (d, h)    g["b1"] = dA.sum(axis=0)                                        # (h,)    return g
grads = backward(c_tr, yc_tr, P, cache)print({k: np.shape(v) for k, v in grads.items()}){'w2': (8,), 'b2': (), 'W1': (2, 8), 'b1': (8,)}- 기울기의 모양은 매개변수의 모양과 같다. 이 (2, 8)이면 도 (2, 8)이다. 가 (N, 2), 가 (N, 8)일 때 (2, 8)을 만드는 곱은 뿐이다. 식이 헷갈리면 모양부터 맞춰 본다. 다만 모양이 맞는다고 식이 맞는 것은 아니므로 아래처럼 검산한다.
- 선형 층 하나()의 규칙은 늘 같다: , . 위 표의 두 선형 층이 모두 이 규칙이다. 층이 더 많아도 “선형 층 규칙 → 활성화 미분 곱하기”를 되풀이할 뿐이다.
수치 미분으로 검산
섹션 제목: “수치 미분으로 검산”04장처럼 매개변수 하나를 만큼 움직여 손실 차이로 기울기를 잰다. 매개변수 33개마다 손실을 두 번씩 계산한다.
def numerical_grad(X, y, P, name, h=1e-6):    out = np.zeros(np.shape(P[name]))    for idx in np.ndindex(out.shape):                               # b2처럼 0차원이면 idx = ()        Q = {k: np.array(v, dtype=float) for k, v in P.items()}     # 복사본에서만 움직인다        Q[name][idx] += h        up = bce(y, forward(X, Q)["p"])        Q[name][idx] -= 2 * h        down = bce(y, forward(X, Q)["p"])        out[idx] = (up - down) / (2 * h)    return out
for name in P: print(name, np.allclose(grads[name], numerical_grad(c_tr, yc_tr, P, name), rtol=1e-5, atol=1e-8))W1 Trueb1 Truew2 Trueb2 True역전파 코드가 맞다. 새 층이나 손실을 직접 구현하면 이렇게 작은 데이터에서 수치 미분과 비교한다. ReLU처럼 꺾인 점이 있는 함수는 가 정확히 0 근처인 표본에서 수치 미분이 어긋날 수 있다. 그런 표본이 있으면 를 바꿔 다시 본다.
10-8. 직접 학습하기
섹션 제목: “10-8. 직접 학습하기”경사하강법 루프
섹션 제목: “경사하강법 루프”04·06장과 같은 루프다. 순전파 → 손실 기록 → 역전파 → 모든 매개변수 갱신을 되풀이한다. 전체 훈련 데이터를 한 번에 쓰므로 스텝 하나가 에폭 하나다(미니배치는 11장).
from sklearn.linear_model import LogisticRegression
def train(X, y, P, lr=0.5, steps=2000):    P = {k: np.array(v, dtype=float) for k, v in P.items()}         # 원본은 두고 복사본을 학습    history = []    for _ in range(steps):        c = forward(X, P)        history.append(bce(y, c["p"]))        g = backward(X, y, P, c)        for k in P:            P[k] = P[k] - lr * g[k]    return P, history
def accuracy(P, X, y):    return np.mean((forward(X, P)["p"] >= 0.5) == y)
print("로지스틱 회귀(06장):", round(LogisticRegression().fit(c_tr, yc_tr).score(c_va, yc_va), 3))for h in [2, 8]: for seed in [0, 1, 2]: P_h, hist = train(c_tr, yc_tr, init_params(2, h, seed)) print(f"은닉 {h}, seed {seed}: 훈련 손실 {hist[0]:.3f} → {hist[-1]:.3f}, 검증 정확도 {accuracy(P_h, c_va, yc_va):.3f}")로지스틱 회귀(06장): 0.433은닉 2, seed 0: 훈련 손실 0.689 → 0.510, 검증 정확도 0.689은닉 2, seed 1: 훈련 손실 0.719 → 0.523, 검증 정확도 0.689은닉 2, seed 2: 훈련 손실 0.845 → 0.601, 검증 정확도 0.556은닉 8, seed 0: 훈련 손실 0.685 → 0.023, 검증 정확도 0.989은닉 8, seed 1: 훈련 손실 0.702 → 0.019, 검증 정확도 0.989은닉 8, seed 2: 훈련 손실 0.705 → 0.018, 검증 정확도 0.989← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
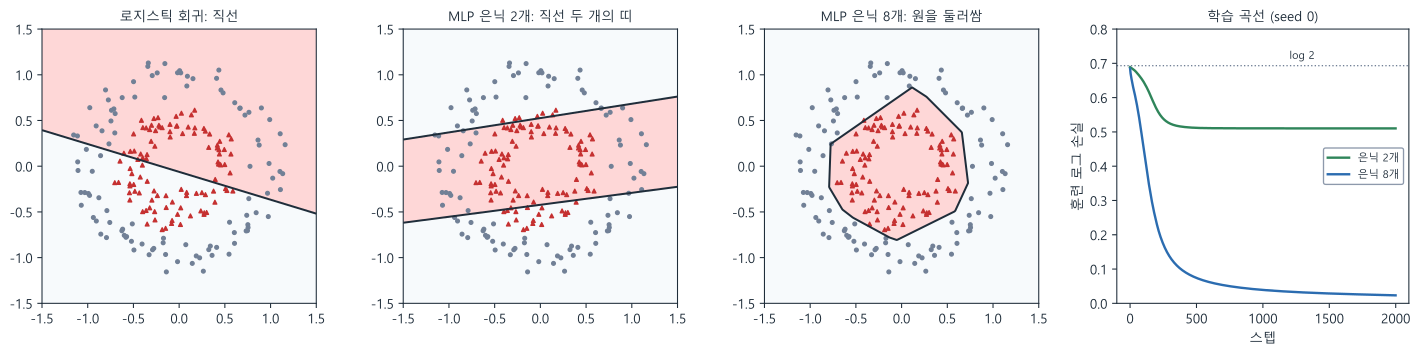
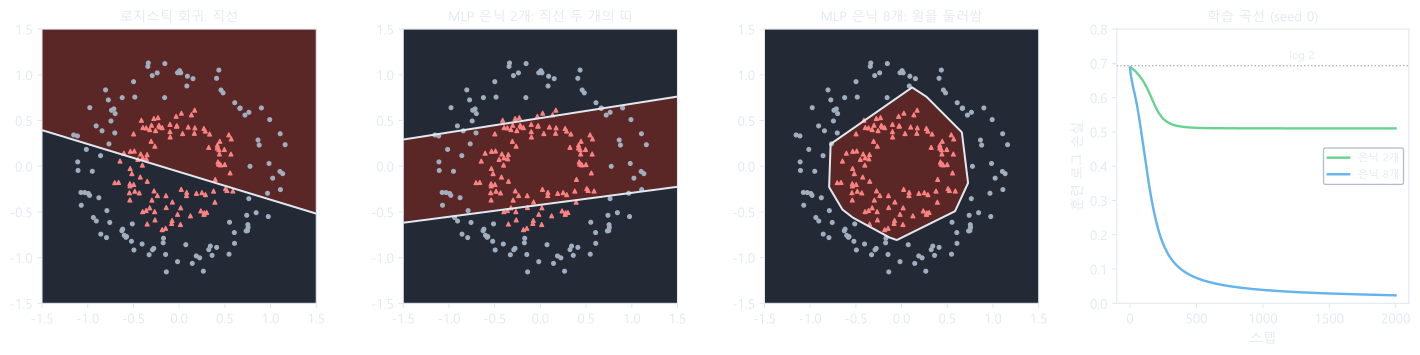
그림 설명. 앞 세 칸은 원 데이터의 훈련 210개(회색 점이 바깥 고리 0, 빨간 삼각형이 안쪽 원 1)와 각 모델이 1로 예측하는 붉은 영역이다. 가로·세로축은 −1.5~1.5다. 로지스틱 회귀는 비스듬한 직선 하나로 평면을 반으로 가른다. 은닉 2개 MLP는 거의 평행한 직선 두 개 사이의 가로 띠를 1로 예측해, 띠 밖 위아래의 바깥 고리 점만 0으로 맞힌다. 은닉 8개 MLP는 안쪽 원을 둘러싸는 여러각형 모양의 경계를 만든다. 넷째 칸은 시드 0의 학습 곡선이다. 가로축 스텝(0~2000), 세로축 훈련 로그 손실(0~0.8)이고 점선이 다. 은닉 2개(초록)는 약 0.69에서 300스텝 무렵 약 0.51로 내려와 평평해지고, 은닉 8개(파랑)는 계속 내려가 2000스텝에서 약 0.02가 된다.
- 은닉 유닛 8개 MLP는 원래 특성 2개만으로 원 데이터를 거의 다 맞힌다. 06장에서 ·를 직접 만들어 얻은 결과(0.978)를 특성 공학 없이 얻었다.
- 은닉 유닛이 2개면 부족하다. ReLU 유닛 하나는 평면을 직선 하나로 접으므로, 유닛 2개로는 원을 둘러싸는 경계를 만들기 어렵다. 그림 가운데처럼 직선 두 개 사이의 띠 모양 경계에 그쳐, 띠 밖 위아래의 바깥 고리 점만 0으로 맞힌다.
- 같은 구조라도 시작 난수(시드)에 따라 결과가 다르다. 신경망의 손실은 06장 로지스틱 회귀와 달리 볼록이 아니어서, 시작점에 따라 다른 곳에 멈춘다. 은닉 2개처럼 여유가 없을수록 차이가 크다. 그래서 신경망 실험에서는 시드를 고정해 결과를 재현하고, 중요한 비교는 시드를 몇 개 바꿔 가며 반복한다.
- 은닉 유닛을 늘리면 경계를 더 자유롭게 만들지만 과적합하기도 쉽다. 은닉 유닛 수도 05장처럼 검증 점수로 고르는 하이퍼파라미터다.
0으로 시작하면 안 되는 이유
섹션 제목: “0으로 시작하면 안 되는 이유”zeros = {"W1": np.zeros((2, 8)), "b1": np.zeros(8), "w2": np.zeros(8), "b2": 0.0}same = {"W1": np.full((2, 8), 0.5), "b1": np.zeros(8), "w2": np.full(8, 0.5), "b2": 0.0}for name, P_init in [("모두 0", zeros), ("모두 같은 값 0.5", same)]: P_s, hist = train(c_tr, yc_tr, P_init) cols_same = np.allclose(P_s["W1"], P_s["W1"][:, :1]) # 은닉 유닛 8개의 가중치가 모두 같은가 print(f"{name}: 훈련 손실 {hist[-1]:.3f}, 검증 정확도 {accuracy(P_s, c_va, yc_va):.3f}, 유닛 가중치 모두 같음 {cols_same}")모두 0: 훈련 손실 0.693, 검증 정확도 0.500, 유닛 가중치 모두 같음 True모두 같은 값 0.5: 훈련 손실 0.603, 검증 정확도 0.689, 유닛 가중치 모두 같음 True- 모두 0: 이라 ReLU의 미분이 0이고(PyTorch와 같은 약속), 이라 도 0이다. 움직일 수 있는 것은 하나뿐인데, 이 데이터는 두 범주가 반반이라 = 평균도 0이다. 아무것도 움직이지 않아 손실이 에 그대로 머문다. 범주 비율이 반반이 아니면 만 움직여 모든 표본에 같은 확률(정답 비율)을 내는 모델에 갇힌다.
- 모두 같은 값: 은닉 유닛 8개가 같은 입력에 같은 가중치라 같은 값을 내고, 같은 기울기를 받아 같이 움직인다. 끝까지 똑같아서 유닛 8개가 사실상 1개다. 이것을 대칭(symmetry) 문제라 한다.
- 그래서 가중치는 서로 다른 작은 난수로 시작한다(절편은 0이어도 된다). PyTorch
nn.Linear는 만들 때 자동으로 난수 초기화를 한다. 초기화 방법(Xavier·He)은 11장에서 소개한다.
10-9. autograd로 확인하고 학습하기
섹션 제목: “10-9. autograd로 확인하고 학습하기”같은 기울기가 나오는가
섹션 제목: “같은 기울기가 나오는가”10-7절의 NumPy 역전파를 PyTorch 자동 미분과 맞춘다. NumPy와 정밀도를 맞추려고 float64로 계산한다.
T = {k: torch.tensor(v, dtype=torch.float64, requires_grad=True) for k, v in P.items()}Xt, yt = torch.tensor(c_tr), torch.tensor(yc_tr, dtype=torch.float64)
def forward_t(X, T):    H = torch.relu(X @ T["W1"] + T["b1"])    return torch.sigmoid(H @ T["w2"] + T["b2"])
def bce_t(y, p):    return -torch.mean(y * torch.log(p) + (1 - y) * torch.log(1 - p))
loss = bce_t(yt, forward_t(Xt, T))loss.backward()print(round(loss.item(), 4), {k: np.allclose(T[k].grad.numpy(), grads[k]) for k in P})0.6846 {'W1': True, 'b1': True, 'w2': True, 'b2': True}backward() 한 줄이 10-7절 backward 함수 전체와 같은 값을 냈다. 우리는 순전파만 쓰고, 역전파는 PyTorch가 기록한 그래프에서 자동으로 만든다. 층을 바꾸거나 더해도 역전파 코드를 다시 쓸 필요가 없다. 그래서 실제 딥러닝은 autograd로 하고, 손으로 쓴 역전파는 원리를 이해하고 검산하는 데 쓴다.
여기서 직접 쓴 bce_t는 원리 확인용이다. 시그모이드 출력이 부동소수점에서 정확히 0이나 1이 되면 때문에 inf·nan이 생긴다(06장 6-5절). 실무에서는 로짓을 받아 안정하게 계산하는 nn.BCEWithLogitsLoss를 쓴다(11장).
autograd로 학습 루프
섹션 제목: “autograd로 학습 루프”def train_torch(X, y, P, lr=0.5, steps=2000, zero_grad=True): T = {k: torch.tensor(v, dtype=torch.float64, requires_grad=True) for k, v in P.items()} for _ in range(steps): loss = bce_t(y, forward_t(X, T)) loss.backward() # 모든 T[k].grad 계산(더해짐) with torch.no_grad(): for t in T.values(): t -= lr * t.grad # 갱신은 기록하지 않는다 if zero_grad: t.grad.zero_() # 다음 스텝 전에 비운다 return T, loss.item()
P0 = init_params(2, 8, seed=0)P_np, hist_np = train(c_tr, yc_tr, P0)T_ok, loss_ok = train_torch(Xt, yt, P0)print("NumPy와 같은 매개변수:", all(np.allclose(T_ok[k].detach().numpy(), P_np[k]) for k in P0), round(loss_ok, 4))T_bad, loss_bad = train_torch(Xt, yt, P0, zero_grad=False)print("기울기를 안 비우면 마지막 손실:", round(loss_bad, 4))NumPy와 같은 매개변수: True 0.0233기울기를 안 비우면 마지막 손실: nan- 같은 초깃값·같은 학습률이면 NumPy 루프와 PyTorch 루프가 같은 매개변수에 도착한다.
zero_()를 빼면 오류 없이 돌지만, 스텝마다 지난 기울기가 모두 더해져 갱신 폭이 점점 커지고 학습이 망가진다. 손실 곡선이 이상하면 가장 먼저 확인할 줄이다. 위의nan은 커진 갱신으로 확률이 0이나 1에 닿아 직접 쓴 로그 손실이 을 계산한 결과다.
- 11장에서는 이 루프의 세 줄(갱신, 비우기, 매개변수 모음)을
torch.optim의 옵티마이저가 맡는다.optimizer.step()이t -= lr * t.grad,optimizer.zero_grad()가t.grad.zero_()에 해당한다.
10-10. nn 모듈로 같은 모델 만들기
섹션 제목: “10-10. nn 모듈로 같은 모델 만들기”PyTorch는 층을 torch.nn에 미리 만들어 두었다. nn.Linear(입력 수, 출력 수)는 가중치와 절편을 가진 선형 층이고, nn.Sequential은 층을 순서대로 잇는다.
from torch import nn
torch.manual_seed(0)model = nn.Sequential(nn.Linear(2, 8), nn.ReLU(), nn.Linear(8, 1))for name, prm in model.named_parameters(): print(name, tuple(prm.shape), prm.dtype, prm.requires_grad)print("매개변수 수", sum(prm.numel() for prm in model.parameters()))0.weight (8, 2) torch.float32 True0.bias (8,) torch.float32 True2.weight (1, 8) torch.float32 True2.bias (1,) torch.float32 True매개변수 수 33- 매개변수 33개로 10-6절 MLP와 같은 구조다.
nn.Linear층을 만들 때 매개변수를 난수로 초기화하며, 이 매개변수들은requires_grad=True라 학습 대상이다. - 가중치 모양이 (출력 수, 입력 수)다.
nn.Linear(2, 8)의 weight는 (8, 2)이고 계산은 다. 이 장의 은 (2, 8)이므로 옮길 때 전치한다. - 마지막 층이 시그모이드 없이 점수 z(로짓)를 낸다. PyTorch는 시그모이드와 로그 손실을 한 번에 안정하게 계산하는
nn.BCEWithLogitsLoss에 z를 넘기는 방식을 쓴다(11장).
10-8절에서 NumPy로 학습한 매개변수를 넣으면 같은 확률이 나와야 한다.
with torch.no_grad():    model[0].weight.copy_(torch.tensor(P_np["W1"].T))               # (2, 8) → (8, 2)    model[0].bias.copy_(torch.tensor(P_np["b1"]))    model[2].weight.copy_(torch.tensor(P_np["w2"]).reshape(1, 8))    model[2].bias.fill_(float(P_np["b2"]))    Xv = torch.tensor(c_va, dtype=torch.float32)    p_nn = torch.sigmoid(model(Xv))print(p_nn.shape, np.allclose(p_nn.squeeze(1).numpy(), forward(c_va, P_np)["p"], atol=1e-5))
try: model(torch.from_numpy(c_va)) # float64를 float32 모델에except RuntimeError as e: print("오류:", e)print("(N, 1) − (N,) 모양:", tuple((p_nn - torch.tensor(yc_va)).shape))torch.Size([90, 1]) True오류: mat1 and mat2 must have the same dtype, but got Double and Float(N, 1) − (N,) 모양: (90, 90)- 같은 계산이므로 float32 반올림 차이 안에서 확률이 같다.
copy_는 float64 값을 매개변수의 dtype(float32)으로 바꿔 넣는다. - dtype이 다르면 오류가 난다. sklearn·NumPy 데이터는 float64이므로
torch.tensor(..., dtype=torch.float32)로 바꿔 넣는다. - 모양 함정. 모델 출력은
(N, 1)이고 정답 배열은 보통(N,)이다. 둘을 빼면 오류 없이 브로드캐스팅되어(N, N)이 된다(02장 규칙). 손실이 이상한 값으로 계산되는데도 학습은 돈다. 출력을squeeze(1)하거나 정답을(N, 1)로 맞춘 뒤 계산한다.
10-11. 깊어지면 생기는 일: 기울기 소실
섹션 제목: “10-11. 깊어지면 생기는 일: 기울기 소실”수학 상자: 연쇄 법칙과 행렬 미분
섹션 제목: “수학 상자: 연쇄 법칙과 행렬 미분”연쇄 법칙. , 이면 이다. 단계가 여러 개면 국소 미분을 모두 곱하고, 한 변수에서 여러 길로 갈라지면 길마다의 곱을 더한다. 역전파는 이 곱을 출력 쪽부터 계산해 앞 층으로 넘기는 순서일 뿐이다.
행렬 미분. 스칼라 손실 과 선형 층 에서 , 이다. 기울기 모양은 늘 그 변수의 모양과 같다. 원소별 함수 는 다.
기울기 소실(vanishing gradient). 앞쪽 층의 기울기는 뒤쪽 층들의 국소 미분을 모두 곱한 것이다. 시그모이드의 미분은 최대 0.25라서, 층마다 0.25 이하가 곱해지면 10층만 지나도 수준까지 작아질 수 있다(가중치 크기도 함께 곱해진다). 그러면 앞쪽 층은 거의 학습되지 않는다. 같은 구조의 10층 신경망에서 층별 가중치 기울기의 크기(노름)를 비교한다.
def layer_grad_norms(act, init):    torch.manual_seed(0)    layers = []    for _ in range(10):        lin = nn.Linear(32, 32)        init(lin.weight)        nn.init.zeros_(lin.bias)        layers += [lin, act()]    net = nn.Sequential(*layers)    net(torch.randn(256, 32)).pow(2).mean().backward()    return [m.weight.grad.norm().item() for m in net if isinstance(m, nn.Linear)]
for name, act, init in [("sigmoid", nn.Sigmoid, nn.init.xavier_normal_), ("tanh", nn.Tanh, nn.init.xavier_normal_), ("relu", nn.ReLU, lambda w: nn.init.kaiming_normal_(w, nonlinearity="relu"))]: g = layer_grad_norms(act, init) print(f"{name:7s} 1층 {g[0]:.1e}, 5층 {g[4]:.1e}, 10층 {g[-1]:.1e}, 1층/10층 {g[0] / g[-1]:.1e}")sigmoid 1층 3.6e-08, 5층 8.3e-05, 10층 1.2e-01, 1층/10층 2.9e-07tanh 1층 2.5e-02, 5층 4.4e-02, 10층 5.4e-02, 1층/10층 4.6e-01relu 1층 5.6e-01, 5층 2.5e+00, 10층 2.0e+00, 1층/10층 2.8e-01- 시그모이드는 첫 층의 기울기가 마지막 층보다 수백만 분의 1로 작다. 같은 학습률이면 첫 층은 사실상 멈춘다.
- tanh(0 근처 미분 1)와 ReLU(켜지면 미분 1)는 활성화 함수에 맞는 초기화와 함께 쓰면 층별 기울기 크기가 비슷하게 유지된다. 은닉층에 시그모이드 대신 ReLU를 쓰는 가장 큰 이유다. 반대로 곱이 1보다 커지면 기울기가 점점 커지는데, 이를 기울기 폭발(exploding gradient)이라 한다. 층마다 곱해지는 값이 1 근처에 머물도록 하는 것이 초기화·정규화 층·잔차 연결 같은 기법의 목적이다(11·12·14장).
- 같은 문제가 시간 방향으로 생기는 것이 13장 RNN의 기울기 소실이다.
10-12. 신경망을 언제 쓰나
섹션 제목: “10-12. 신경망을 언제 쓰나”| 상황 | 신경망(MLP) | 다른 선택 |
|---|---|---|
| 표 데이터, 특성마다 뜻이 있다 | 비교 후보로만. 입력 스케일을 맞추고(표준화 등), 시드·은닉 수에 따라 흔들린다 | 트리 앙상블이 먼저(07·09장) |
| 이미지·소리·문장 원본 | 신경망이 기본. 구조는 데이터에 맞춘다 | CNN(12장), 트랜스포머(14장), 사전학습 모델(15장) |
| 경계가 휘었고 특성이 몇 개뿐 | 작은 MLP로 풀린다 | 제곱·곱 특성 + 로지스틱(06장), 트리(07장) |
| 데이터가 수백 건, 이유를 설명해야 한다 | 맞지 않는다 | 로지스틱 회귀(06장), 트리 하나(07장) |
| 사전학습 모델이 뽑은 특성 위에 분류기를 얹는다 | 작은 MLP 헤드 또는 로지스틱 헤드 | 15장 |
sklearn에도 MLPClassifier가 있어 작은 표 데이터 실험에는 쓸 수 있다. 이 자료는 이미지·문장으로 이어지도록 PyTorch로 간다.
10-13. 선택 기준표에 추가
섹션 제목: “10-13. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 경계가 휘었는데 어떤 특성을 만들지 모른다 | 은닉층 1~2개 MLP(ReLU, 출력은 문제에 맞게), 입력 표준화. 표 데이터면 트리 앙상블과 교차검증으로 비교 | 은닉층이 특성을 배운다. 표 데이터에서는 트리가 대체로 먼저다 | 10 |
| 은닉층 활성화를 고른다 | ReLU 기본, 출력층은 시그모이드(이진)·소프트맥스(다중)·없음(회귀) | 시그모이드 은닉층은 깊어지면 기울기가 사라진다 | 10 |
| 기울기·층을 직접 구현했다 | 작은 데이터에서 수치 미분·autograd와 비교 | 모양이 맞아도 식이 틀릴 수 있다 | 10 |
| 신경망 손실이 안 줄거나 이상하다 | 기울기 비우기 → 초기화(0·같은 값 금지) → 출력·정답 모양 (N, 1)/(N,) → dtype float32 → 학습률·스케일 순으로 확인 |
대부분 오류 없이 조용히 틀린다 | 10 |
| 신경망 결과를 비교한다 | 시드 고정, 중요한 비교는 시드 여러 개로 | 손실이 볼록이 아니라 시작점에 따라 결과가 달라진다 | 10 |
확인 문제
섹션 제목: “확인 문제”10문항. 풀면 결과가 기록되고 복습 일정에 들어간다.
10-14. 실습과 문제
섹션 제목: “10-14. 실습과 문제”실습/문제/ch10_신경망과_역전파.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다. 실습은 원고와 다른 반달 모양 데이터(make_moons)로 같은 과정을 밟는다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 텐서·autograd 참/거짓 |
| 2 | 코드 | NumPy 데이터를 모델 입력 텐서로 바꾸기 |
| 3 | 코드 | 활성화 함수의 미분을 식으로 쓰고 autograd와 비교 |
| 4 | 코드 | tanh 은닉층 MLP의 순전파 |
| 5 | 코드 | 같은 MLP의 역전파(수치 미분·autograd로 점검) |
| 6 | 코드 | 경사하강법 학습 루프 |
| 7 | 코드 | 직접 학습한 매개변수를 nn.Sequential로 옮겨 확률 예측 |
| 8 | 개념 | 신경망·역전파 참/거짓 |
| 9 | 사례 | 손실이 0.693에서 멈춘 신경망 진단 |
| 10 | 사례 | 상황별 모델·설정 고르기 |
10-15. 공식 문서와 참고 자료
섹션 제목: “10-15. 공식 문서와 참고 자료”- 텐서 입문(PyTorch 튜토리얼): https://docs.pytorch.org/tutorials/beginner/basics/tensorqs_tutorial.html
- 자동 미분 입문(PyTorch 튜토리얼): https://docs.pytorch.org/tutorials/beginner/basics/autogradqs_tutorial.html
- autograd 동작 원리(노트): https://docs.pytorch.org/docs/stable/notes/autograd.html
torch.Tensor(dtype 목록 포함): https://docs.pytorch.org/docs/stable/tensors.htmltorch.from_numpy: https://docs.pytorch.org/docs/stable/generated/torch.from_numpy.htmltorch.no_grad: https://docs.pytorch.org/docs/stable/generated/torch.no_grad.htmlnn.Linear: https://docs.pytorch.org/docs/stable/generated/torch.nn.Linear.htmlnn.Sequential: https://docs.pytorch.org/docs/stable/generated/torch.nn.Sequential.htmlnn.ReLU: https://docs.pytorch.org/docs/stable/generated/torch.nn.ReLU.htmltorch.nn.init(Xavier·He 초기화): https://docs.pytorch.org/docs/stable/nn.init.html- 신경망 모델(sklearn 사용자 안내서,
MLPClassifier): https://scikit-learn.org/stable/modules/neural_networks_supervised.html