AI 기초 › 01장
AI의 흐름
AI라는 말은 1950년대부터 쓰였지만, 그 안의 방법은 여러 번 바뀌었다. 바뀔 때마다 이유는 같았다. 앞 방법으로는 풀리지 않는 문제가 쌓였고, 새 방법이 그것을 풀었다. 이 장은 그 흐름을 “무엇이 막혔고 무엇이 풀었나”로 읽고, 같은 문제를 사람이 쓴 규칙과 데이터로 배운 모델로 각각 풀어 비교한다. 마지막에 이 자료 내내 쌓아 갈 선택 기준표를 시작한다. 코드는 00장에서 만든 가상환경에서 실행한다.
1-1. 이 장의 목표와 완료 기준
섹션 제목: “1-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| AI·머신러닝·딥러닝의 관계를 안다 | 셋의 포함 관계와 각각이 “규칙을 어디서 얻는지”를 한 문장씩 말할 수 있다 |
| 흐름의 전환점을 안다 | 규칙 기반 → 머신러닝 → 딥러닝 → 트랜스포머·사전학습 → 대규모 언어 모델(LLM, Large Language Model) 각 단계에서 막힌 것과 푼 것을 짝지을 수 있다 |
| 학습 방식을 구분한다 | 과제를 보고 지도(회귀·분류)·비지도·자기지도 중 무엇인지 고른다 |
| 규칙 기반과 머신러닝을 직접 비교한다 | 같은 데이터에서 규칙과 결정 트리의 정확도를 재고, 어느 쪽이 언제 나은지 설명한다 |
| 선택 기준표를 시작한다 | 이 장에서 추가한 줄을 읽고 상황에 맞는 쪽을 고른다 |
| 실습 노트북 01을 끝낸다 | 실습/문제/ch01_AI의_흐름.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간, 실습 1시간 30분.
1-2. 왜 흐름부터 보나
섹션 제목: “1-2. 왜 흐름부터 보나”지금 쓰이는 방법은 모두 이전 방법의 한계를 메우려고 나왔다. 그래서 각 방법이 무엇을 풀려고 나왔는지 알면 그 방법이 언제 맞고 언제 과한지도 보인다.
- 규칙이 열 줄이면 되는 일에 신경망을 쓰면 데이터·시간·설명 비용만 늘어난다.
- 반대로 사진에서 불량을 찾는 일에 규칙을 쓰면 끝없이 예외를 덧붙이게 된다.
이 자료의 최종 목표인 “상황에 맞는 AI 고르기”는 이 흐름을 거꾸로 읽는 일이다.
1-3. AI·머신러닝·딥러닝
섹션 제목: “1-3. AI·머신러닝·딥러닝”| 용어 | 뜻 | 규칙(판단 기준)은 어디서 오나 |
|---|---|---|
| 인공지능(AI, Artificial Intelligence) | 사람이 지능을 써서 하던 판단을 기계가 하게 하는 분야 전체 | 사람이 쓰거나, 데이터에서 배우거나 |
| 머신러닝(ML, Machine Learning) | AI 가운데 데이터에서 규칙(패턴)을 배우는 방법 | 데이터(고전 머신러닝에서는 입력 특성을 사람이 고른다) |
| 딥러닝(DL, Deep Learning) | 머신러닝 가운데 여러 층의 신경망으로 특성까지 배우는 방법 | 데이터(원시 입력에서 특성까지) |
신경망(neural network)은 입력에 가중치를 곱해 더하는 간단한 계산 단위를 여러 개 연결한 모델이고, 층(layer)은 입력을 차례로 바꾸어 가는 계산 단계 하나다. 층을 여러 번 거치며 원시 입력이 점점 쓸모 있는 특성으로 바뀐다(10장).
포함 관계는 AI ⊃ 머신러닝 ⊃ 딥러닝이다. 규칙 기반 시스템도 AI이지만 머신러닝은 아니다. LLM은 딥러닝 모델(트랜스포머)이므로 셋 모두에 속한다.
이 장부터 계속 쓰는 말:
| 용어 | 뜻 | 붓꽃(iris) 예 |
|---|---|---|
| 표본(sample) | 데이터 한 건 | 꽃 한 송이 |
| 특성(feature) | 표본을 나타내는 입력 값, 보통 X |
꽃잎 길이·너비 등 4개 |
| 라벨(label), 정답 | 맞혀야 할 값, 보통 y |
품종(setosa 등 3종) |
| 모델(model) | 특성을 받아 예측을 내는 함수 | 결정 트리 |
| 학습(training), fit | 데이터로 모델의 내부 값을 정하는 과정 | 분기 기준값 찾기 |
| 추론(inference), predict | 학습이 끝난 모델로 새 표본을 예측 | 새 꽃의 품종 맞히기 |
1-4. 흐름: 무엇이 막혔고 무엇이 풀었나
섹션 제목: “1-4. 흐름: 무엇이 막혔고 무엇이 풀었나”← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
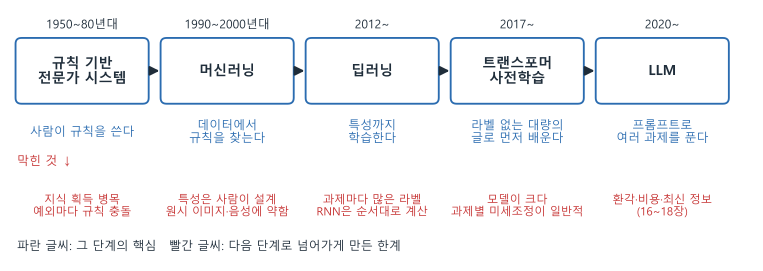
그림 설명. 상자 다섯 개가 왼쪽에서 오른쪽으로 화살표로 이어진다. 위에는 시기(1950~80년대, 1990~2000년대, 2012~, 2017~, 2020~), 상자 아래 첫 줄에는 그 단계의 핵심, 둘째 줄에는 다음 단계로 넘어가게 만든 한계를 적었다. 규칙 기반은 “사람이 규칙을 쓴다”가 핵심이고 지식 획득 병목과 규칙 충돌이 한계다. 머신러닝은 “데이터에서 규칙을 찾는다”이고 특성을 사람이 설계해야 했다. 딥러닝은 “특성까지 학습한다”이고 과제마다 라벨이 많이 필요했다. 트랜스포머·사전학습은 “라벨 없는 대량의 글로 먼저 배운다”이고 과제별 미세조정이 일반적이었다. LLM은 “프롬프트로 여러 과제를 푼다”이고 환각·비용·최신 정보 부족이 남았다.
연도는 대표 사건 기준의 대략값이다. 각 단계는 앞 단계를 없애지 않고 쌓인다. 지금도 규칙 기반 시스템과 고전 머신러닝은 많이 쓰인다.
규칙 기반·전문가 시스템 (1950~80년대)
섹션 제목: “규칙 기반·전문가 시스템 (1950~80년대)”“인공지능(Artificial Intelligence)“이라는 이름은 1955년 다트머스 연구 제안서에 처음 쓰였고, 이듬해(1956년) 열린 다트머스 연구 모임이 이 분야의 출발점으로 꼽힌다. 초기 AI의 주류는 사람이 지식을 규칙으로 적는 방식이었다. 1970~80년대의 전문가 시스템(expert system)은 의사·기술자 같은 전문가의 판단을 “만약 A이고 B이면 C” 형태의 규칙 수백~수천 개로 옮겼다(감염 진단용 MYCIN이 대표 예).
- 잘한 것: 규칙이 분명한 영역에서 바로 쓸 수 있고, 판단 근거를 그대로 보여 준다.
- 막힌 것: 전문가의 감을 규칙으로 옮기기 어려웠고(지식 획득 병목), 예외마다 규칙을 덧붙이다 보니 규칙끼리 충돌했다. 손글씨·사진·음성처럼 말로 규칙을 쓰기 어려운 입력에는 거의 쓸 수 없었다.
머신러닝 (1990~2000년대)
섹션 제목: “머신러닝 (1990~2000년대)”규칙을 사람이 쓰는 대신 정답이 달린 예시에서 규칙을 찾게 했다(이 시기에 널리 쓰인 것은 주로 이런 지도 학습이다, 1-5절). 결정 트리(decision tree), 서포트 벡터 머신(SVM, Support Vector Machine), 랜덤 포레스트(random forest) 같은 방법이 표 데이터·텍스트 분류에서 성과를 냈다. 2부(06~09장)가 이 단계다.
- 푼 것: 규칙 수천 개를 사람이 쓰지 않아도 된다. 데이터가 바뀌면 다시 학습하면 된다.
- 막힌 것: 모델에 넣을 특성은 여전히 사람이 설계했다(특성 공학, feature engineering). 표 데이터는 열이 곧 특성이라 괜찮았지만, 사진의 픽셀 값이나 음성 파형에서 “좋은 특성”을 사람이 만드는 것은 어려웠다.
딥러닝 (2012~)
섹션 제목: “딥러닝 (2012~)”신경망 자체는 오래된 아이디어다(1958년 퍼셉트론, 1986년 역전파 학습법이 널리 알려짐). 오랫동안 큰 신경망은 학습시키기 어려웠는데, 대량의 라벨 데이터 + GPU 계산 + 학습 기법 개선이 겹치면서 상황이 바뀌었다. 2012년 이미지 분류 대회(ImageNet)에서 다층 합성곱 신경망(AlexNet)이 기존 방법과 큰 차이로 1위를 했고, 이후 이미지·음성 분야의 주류가 됐다. 3부(10~15장)가 이 단계다.
- 푼 것: 원시 입력(픽셀)에서 특성까지 스스로 배운다. 사람이 특성을 설계하지 않아도 된다.
- 막힌 것: 과제마다 라벨 데이터가 많이 필요했다. 문장을 다루던 순환 신경망(RNN, Recurrent Neural Network)은 단어를 하나씩 순서대로 계산해 긴 문장에 약하고 병렬 계산이 어려웠다(13장).
트랜스포머와 사전학습 (2017~)
섹션 제목: “트랜스포머와 사전학습 (2017~)”2017년 트랜스포머(Transformer)가 나왔다. 어텐션(attention)으로 문장 안의 모든 위치를 한꺼번에 비교해, 순서대로 계산할 필요 없이 병렬로 학습한다(14장). 단, 이것은 학습할 때의 이야기다. GPT 계열은 각 위치가 뒤쪽 단어를 보지 못하게 가리고 학습하며, 글을 생성할 때는 토큰을 하나씩 이어 쓴다(16장). 여기에 사전학습(pre-training)이 결합했다. 라벨 없는 대량의 글로 “가린 단어 맞히기”(BERT, 2018)나 “다음 단어 맞히기”(GPT 계열) 같은 과제를 먼저 학습하고, 실제 과제는 적은 라벨로 미세조정(fine-tuning)한다(15장). 이미지·음성에도 같은 방식이 퍼졌다.
- 푼 것: 과제마다 라벨을 많이 모으지 않아도 된다. 긴 문맥을 병렬로 처리한다.
- 막힌 것: 모델이 커져 학습 비용이 크고, 과제마다 미세조정한 모델을 따로 만드는 방식이 일반적이었다(GPT-2(2019)는 미세조정 없이 여러 과제를 푸는 가능성을 보였다).
LLM (2020~)
섹션 제목: “LLM (2020~)”모델과 데이터를 크게 키우자, 미세조정 없이 프롬프트(prompt, 모델에 주는 지시·질문·예시 같은 입력 글)에 예시 몇 개만 넣어도(few-shot) 새 과제를 푸는 능력이 나타났다(GPT-3, 2020). 여기에 지시를 따르도록 추가 학습한 대화형 모델(2022년 ChatGPT 등)이 나오면서 하나의 모델로 요약·번역·분류·질의응답을 한다. 4부(16~19장)가 이 단계다.
- 푼 것: 과제별 모델 없이 프롬프트로 여러 과제를 처리한다.
- 남은 문제: 그럴듯하지만 틀린 답(환각, hallucination), 큰 추론 비용과 지연, 학습 이후의 최신 정보 부족. 16~18장의 디코딩 설정·검색 증강 생성(RAG, Retrieval-Augmented Generation)·경량화가 여기에 대한 대응이다.
1-5. 학습 방식의 지도
섹션 제목: “1-5. 학습 방식의 지도”← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
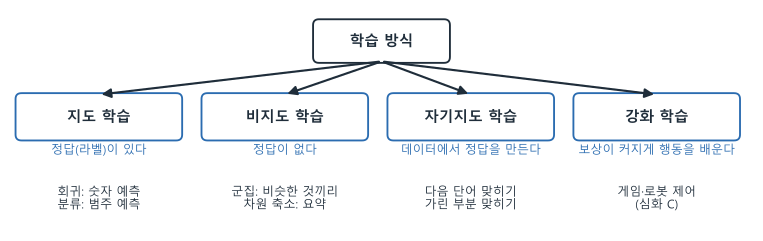
그림 설명. 위의 “학습 방식” 상자에서 네 갈래가 나온다. 지도 학습은 정답(라벨)이 있고 회귀(숫자 예측)와 분류(범주 예측)를 한다. 비지도 학습은 정답이 없고 군집과 차원 축소를 한다. 자기지도 학습은 데이터에서 정답을 만들어 다음 단어나 가린 부분을 맞힌다. 강화 학습은 환경에서 행동하고 보상을 받는 경험으로, 장기적으로 받을 보상이 커지도록 행동 고르는 법을 배운다. 게임·로봇 제어에 쓴다.
머신러닝은 정답이 어디서 오는가에 따라 나눈다. 여기서는 학습 신호의 차이를 보려고 네 방식을 나누지만, 자기지도 학습을 넓은 의미의 비지도 학습에 넣기도 한다.
| 방식 | 데이터 | 대표 과제 | 이 자료 |
|---|---|---|---|
| 지도 학습(supervised) | 특성 X + 정답 y |
회귀(regression): 숫자 예측(집값, 기온). 분류(classification): 범주 예측(스팸 여부, 품종) | 04~07장, 09장 |
| 비지도 학습(unsupervised) | X만 |
군집(clustering): 비슷한 것끼리 묶기. 차원 축소: 특성을 적은 수로 요약 | 08장 |
| 자기지도 학습(self-supervised) | X만, 정답을 X에서 만든다 |
다음 단어 맞히기, 가린 단어 맞히기 | 15~16장 |
| 강화 학습(reinforcement) | 환경에서 한 행동과 그 뒤에 받은 보상 | 게임, 로봇 제어: 장기적으로 받을 보상이 커지도록 행동 고르는 법을 배운다 | 심화 C |
회귀와 분류는 y의 종류로 가른다. 같은 집 데이터라도 “가격(원)“을 맞히면 회귀, “1억 이상인가”를 맞히면 분류다. 숫자로 적혀 있어도 순서·크기에 뜻이 없는 값(우편번호, 품종 번호 0·1·2)을 맞히는 것은 분류다.
자기지도: 정답을 데이터에서 만든다
섹션 제목: “자기지도: 정답을 데이터에서 만든다”LLM 사전학습의 핵심은 라벨 없는 글에서 (앞 문맥, 다음 단어) 쌍을 자동으로 만드는 것이다. 사람이 정답을 달지 않아도 글이 많을수록 학습 예시가 많아진다.
def next_word_pairs(words, k):    """앞 k개 단어 → 다음 단어 쌍을 만든다."""    return [(tuple(words[i - k:i]), words[i]) for i in range(k, len(words))]
words = "오늘 날씨 가 맑아서 산책 을 했다".split()for context, target in next_word_pairs(words, 2): print(context, "→", target)('오늘', '날씨') → 가('날씨', '가') → 맑아서('가', '맑아서') → 산책('맑아서', '산책') → 을('산책', '을') → 했다문장 하나에서 예시 5개가 나왔다. 실제 LLM은 단어 대신 토큰(token) 단위로, 수천억~수조 토큰의 글에서 같은 일을 한다(16장).
비지도: 정답 없이 묶기
섹션 제목: “비지도: 정답 없이 묶기”붓꽃 데이터에서 품종(정답)을 보지 않고 꽃 측정값만으로 3묶음을 만든 뒤, 묶음과 실제 품종을 맞대 본다. k-평균(k-means)은 8장에서 자세히 다룬다. 지금은 “정답 없이도 구조를 찾는다”만 본다. 이 장의 코드에 나오는 NumPy 문법은 02장에서 자세히 배우므로, 여기서는 설명을 따라 뜻만 읽는다. X.shape의 (150, 4)는 표본 150개, 특성 4개라는 뜻이다.
import numpy as npfrom sklearn.datasets import load_irisfrom sklearn.cluster import KMeans
iris = load_iris()X, y = iris.data, iris.targetprint(X.shape, iris.feature_names)
km = KMeans(n_clusters=3, n_init=10, random_state=0).fit(X) # y는 쓰지 않는다table = np.zeros((3, 3), dtype=int)for cluster, species in zip(km.labels_, y): table[cluster, species] += 1print(table) # 행: 묶음 0~2, 열: 실제 품종 setosa·versicolor·virginica(150, 4) ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)'][[ 0 48 14] [50 0 0] [ 0 2 36]]setosa 50송이는 한 묶음(1번)에 정확히 모였다. 나머지 두 품종은 대체로 나뉘었지만 섞인 것이 있다(virginica 14송이가 0번 묶음). 비지도 학습은 묶음에 이름을 붙여 주지 않는다. 묶음 번호 0·1·2가 무슨 뜻인지는 사람이 해석한다. 같은 이유로 묶음 번호는 실행 설정이 바뀌면 달라질 수 있다. 위 표를 읽을 때는 번호가 아니라 한 묶음에 한 품종이 얼마나 몰렸는지를 본다.
1-6. 같은 문제, 두 방법: 규칙 기반 vs 머신러닝
섹션 제목: “1-6. 같은 문제, 두 방법: 규칙 기반 vs 머신러닝”실험 1. 붓꽃 품종: 규칙으로 충분한 경우
섹션 제목: “실험 1. 붓꽃 품종: 규칙으로 충분한 경우”공정하게 비교하려면 규칙을 정할 때도 훈련 데이터만 보고, 평가는 한 번도 보지 않은 테스트 데이터로 한다(나누는 이유와 방법은 5장). 먼저 훈련 데이터에서 품종별 꽃잎 길이·너비 범위를 본다. 아래에서 X_tr[y_tr == k]는 품종이 k인 행만 고르고, part[:, 2]는 그 행들의 2번 열이다. 번호는 0부터 세므로 2번 열은 세 번째 특성인 꽃잎 길이, 3번 열은 꽃잎 너비다.
from sklearn.model_selection import train_test_split
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)print(len(X_tr), len(X_te))for k, name in enumerate(iris.target_names): part = X_tr[y_tr == k] print(f"{name:<11} 꽃잎 길이 {part[:, 2].min()}~{part[:, 2].max()} 너비 {part[:, 3].min()}~{part[:, 3].max()}")105 45setosa 꽃잎 길이 1.0~1.7 너비 0.1~0.6versicolor 꽃잎 길이 3.0~5.1 너비 1.0~1.8virginica 꽃잎 길이 4.5~6.9 너비 1.5~2.5먼저 결과를 예측한다. setosa는 꽃잎 길이로 완전히 갈린다. versicolor와 virginica는 너비가 1.5~1.8에서 겹친다. 이 범위를 보고 사람이 규칙을 썼을 때 테스트 정확도가 몇 %쯤 나올지 예상한 뒤 아래 코드를 실행한다.
def rule_iris(x):    """사람이 쓴 규칙. x = [꽃받침 길이, 꽃받침 너비, 꽃잎 길이, 꽃잎 너비]"""    if x[2] < 2.5:          # 꽃잎이 짧으면        return 0            # setosa    if x[3] < 1.75:         # 꽃잎이 좁으면        return 1            # versicolor    return 2                # virginica
pred = np.array([rule_iris(x) for x in X_te])print("규칙 테스트 정확도:", round((pred == y_te).mean(), 3))규칙 테스트 정확도: 0.956정확도(accuracy)는 맞힌 표본의 비율이다. pred == y_te는 표본마다 맞혔으면 True인 배열이고, True를 1, False를 0으로 보고 평균을 내면 비율이 된다. 테스트 45송이 중 43송이를 맞혀 0.956이다.
이번에는 결정 트리에게 같은 훈련 데이터를 주고 규칙을 찾게 한다. 결정 트리는 “꽃잎 너비 ≤ 0.8인가?”처럼 특성 하나와 기준값으로 된 질문을 차례로 던져 표본을 나누고, 마지막에 도착한 끝 마디(잎)의 품종으로 예측하는 모델이다(7장). 깊이를 2로 제한하면 질문을 두 번까지만 한다. score는 분류 모델의 정확도를 돌려주고, export_text는 학습된 트리를 규칙 모양으로 출력한다.
from sklearn.tree import DecisionTreeClassifier, export_text
tree = DecisionTreeClassifier(max_depth=2, random_state=0).fit(X_tr, y_tr)print("트리 테스트 정확도:", round(tree.score(X_te, y_te), 3))print(export_text(tree, feature_names=iris.feature_names))트리 테스트 정확도: 0.956|--- petal width (cm) <= 0.80| |--- class: 0|--- petal width (cm) > 0.80| |--- petal width (cm) <= 1.75| | |--- class: 1| |--- petal width (cm) > 1.75| | |--- class: 2트리가 찾은 규칙은 사람이 쓴 규칙과 거의 같다(첫 질문만 꽃잎 길이 대신 너비를 썼다). 머신러닝은 사람이 범위를 보고 기준값을 정하던 일을 자동으로 한 것이다. 특성이 몇 개뿐이고 기준이 분명하면 사람이 쓴 규칙으로도 충분하고, 설명하기도 쉽다.
실험 2. 손글씨 숫자: 과제가 커지면 규칙 쓰기가 어려워진다
섹션 제목: “실험 2. 손글씨 숫자: 과제가 커지면 규칙 쓰기가 어려워진다”sklearn에 들어 있는 손글씨 숫자 데이터는 8×8 픽셀 흑백 이미지 1,797장이다. 픽셀 값은 0(흰색)~16(검은색)이다.
from sklearn.datasets import load_digits
digits = load_digits()print(digits.images.shape, digits.data.shape)print(digits.images[digits.target == 0][0].astype(int))(1797, 8, 8) (1797, 64)[[ 0 0 5 13 9 1 0 0] [ 0 0 13 15 10 15 5 0] [ 0 3 15 2 0 11 8 0] [ 0 4 12 0 0 8 8 0] [ 0 5 8 0 0 9 8 0] [ 0 4 11 0 1 12 7 0] [ 0 2 14 5 10 12 0 0] [ 0 0 6 13 10 0 0 0]]0은 가운데가 비어 있다. 1은 가운데에 세로획이 있다. 0과 1만 구분하는 규칙이라면 “가운데 칸(행 2~5, 열 3~4)의 평균 진하기가 기준보다 크면 1”로 쓸 수 있다. 기준값은 훈련 데이터에서 정한다. 아래에서 img_tr[:, 2:6, 3:5]는 모든 이미지에서 행 2~5, 열 3~4를 고른다(번호는 0부터 세고, 2:6처럼 쓰면 끝 번호 6은 빠진다). mean(axis=(1, 2))는 고른 8칸을 이미지마다 평균 내어 값 하나씩을 남긴다.
mask = (digits.target == 0) | (digits.target == 1)img_tr, img_te, d_tr, d_te = train_test_split(    digits.images[mask], digits.target[mask], test_size=0.3, random_state=0, stratify=digits.target[mask])
center_tr = img_tr[:, 2:6, 3:5].mean(axis=(1, 2))           # 이미지마다 가운데 8칸 평균for k in (0, 1):    print(k, np.percentile(center_tr[d_tr == k], [5, 50, 95]).round(1))
def rule_01(img, threshold=6):    return int(img[2:6, 3:5].mean() > threshold)
pred = np.array([rule_01(img) for img in img_te])print("0/1 규칙 테스트 정확도:", round((pred == d_te).mean(), 3))0 [0. 1. 5.3]1 [ 7.2 14.1 16. ]0/1 규칙 테스트 정확도: 0.991출력의 세 값은 숫자별 가운데 진하기의 5백분위수·중앙값·95백분위수다. 훈련 데이터에서 0의 95백분위수는 5.3, 1의 5백분위수는 7.2이므로 그 사이인 6을 기준값으로 골랐다. 두 분포가 완전히 떨어져 있다는 뜻은 아니어서, 가운데가 6보다 진한 0이나 6 이하로 옅은 1은 틀리게 분류된다.
두 숫자는 규칙 한 줄로 99%를 맞힌다. 이제 0~9 열 개를 나누는 규칙을 어떻게 쓸지 생각한다. 3과 8, 4와 9, 1과 7은 획 하나 차이이고, 사람마다 쓰는 위치·기울기가 다르다. 열 개용 규칙은 여기서 만들지 않았다. 대신 같은 10종 과제를 머신러닝 모델 두 개에 맡기고 무엇을 배웠는지 본다.
from sklearn.linear_model import LogisticRegression
Xd_tr, Xd_te, yd_tr, yd_te = train_test_split( digits.data, digits.target, test_size=0.3, random_state=0, stratify=digits.target)logreg = LogisticRegression(max_iter=2000).fit(Xd_tr, yd_tr)deep_tree = DecisionTreeClassifier(random_state=0).fit(Xd_tr, yd_tr)print("로지스틱 회귀 10종 정확도:", round(logreg.score(Xd_te, yd_te), 3))print("결정 트리 10종 정확도:", round(deep_tree.score(Xd_te, yd_te), 3), "/ 규칙(잎) 수:", deep_tree.get_n_leaves())로지스틱 회귀 10종 정확도: 0.961결정 트리 10종 정확도: 0.843 / 규칙(잎) 수: 136- 이번 설정에서 학습한 깊이 제한 없는 결정 트리는 잎(끝 마디)을 136개 만들었고, 정확도는 84%였다. 잎 하나는 “이 조건들을 모두 만족하면 이 숫자”라는 if 규칙 하나에 해당한다. 0/1에서 쓴 규칙 한 줄과 비교하면 10종 과제를 if 규칙으로 표현한 결과가 훨씬 복잡해졌다.
- 로지스틱 회귀(6장)는 if 규칙 대신 64개 픽셀마다 가중치를 학습해 96%를 냈다. 이 가중치는 사람이 읽는 규칙이 아니다. 이 예에서는 정확도가 높은 쪽이 설명하기 어려운 형태였다.
- 이 실험은 사람이 쓴 10종 규칙을 만들지 않았다. 따라서 사람이 쓴 규칙의 정확도나, 사람이 써야 할 규칙의 최소 개수는 측정하지 않았다. 확인한 것은 “0/1은 규칙 한 줄로 99%”, “10종을 학습한 트리는 잎 136개”라는 두 사실까지다. 규칙을 직접 쓰는 일이 어디서 막히는지는 문제 7 뒤 관찰과 1-4절 전문가 시스템의 역사(규칙 충돌, 지식 획득 병목)를 함께 본다.
- 이 데이터는 8×8로 작게 줄이고 가운데 맞춘 이미지다. 실제 사진처럼 크고 위치·조명이 제각각이면 픽셀을 그대로 넣는 방법은 성능이 떨어지기 쉽다. 이 문제를 다루는 것이 딥러닝의 합성곱 신경망(CNN, Convolutional Neural Network)이다(12장).
정리: 언제 무엇이 나은가
섹션 제목: “정리: 언제 무엇이 나은가”| 규칙 기반 | 머신러닝 | |
|---|---|---|
| 필요한 것 | 분명한 판단 기준, 그것을 아는 사람 | 정답이 달린 데이터(지도 학습) |
| 잘 맞는 상황 | 기준이 법·약관·정책으로 정해짐, 특성이 적음, 예외가 드묾 | 입력이 많고 패턴을 말로 쓰기 어려움, 예시는 쌓여 있음 |
| 설명 | 규칙 그대로가 설명 | 모델마다 다름(얕은 트리는 쉽고, 가중치 수천 개는 어려움) |
| 바뀔 때 | 사람이 규칙을 고친다 | 새 데이터로 다시 학습한다 |
| 흔한 실패 | 예외가 쌓여 규칙끼리 충돌 | 데이터가 적거나 치우치면 엉뚱하게 배운다 |
실무에서는 둘을 함께 쓰는 경우가 많다. 법으로 정해진 차단 조건은 규칙으로 확실히 처리하고, 나머지 판단은 모델에 맡긴다. 모델이 틀리면 안 되는 곳에 규칙을 안전장치로 두기도 한다.
1-7. 선택 기준표
섹션 제목: “1-7. 선택 기준표”이 장에서 시작한다. 앞으로 장마다 줄을 더하고, 19장에서 데이터 종류·양·라벨·설명 필요성·지연·비용 기준으로 정리한다.
| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 판단 기준이 법·정책으로 정해져 있고 예외가 드물다 | 규칙 기반 | 데이터·학습 없이 바로 쓰고, 규칙이 곧 설명이다 | 01 |
| 특성이 적고 기준값만 정하면 된다 | 규칙 또는 얕은 결정 트리 | 정확도가 비슷하면 설명하기 쉬운 쪽. 트리로 기준값을 찾고 규칙으로 옮겨도 된다 | 01 |
| 입력이 많아 규칙을 쓰기 어렵고, 정답 달린 예시가 있다 | 지도 학습(머신러닝) | 규칙을 데이터에서 찾는다. 많은 규칙과 기준값을 사람이 직접 쓰는 부담을 줄인다(학습된 모델 자체는 복잡해질 수 있다) | 01 |
| 정답이 없고 비슷한 것끼리 묶고 싶다 | 비지도 학습(군집) | 라벨 없이 구조를 찾는다. 묶음의 뜻은 사람이 해석 | 01 |
| 꼭 지켜야 할 조건 + 나머지는 패턴 판단 | 규칙 + 모델 함께 | 확실한 조건은 규칙으로 보장하고 나머지를 모델에 맡긴다 | 01 |
확인 문제
섹션 제목: “확인 문제”11문항. 풀면 결과가 기록되고 복습 일정에 들어간다.
1-8. 실습과 문제
섹션 제목: “1-8. 실습과 문제”실습/문제/ch01_AI의_흐름.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | AI·머신러닝·딥러닝의 포함 관계 |
| 2 | 개념 | 전환점: 막힌 것과 푼 것 짝짓기 |
| 3 | 개념 | 과제별 학습 방식 고르기(회귀·분류·비지도·자기지도) |
| 4 | 코드 | 자기지도 학습 쌍 만들기 |
| 5 | 코드 | 붓꽃 규칙 분류기 직접 쓰기 |
| 6 | 코드 | 결정 트리로 같은 문제 풀고 규칙 비교 |
| 7 | 코드 | 손글씨 0/1 규칙 분류기 |
| 8 | 사례 | 상황별로 규칙 기반과 머신러닝 고르기 |
| 9 | 사례 | 규칙이 300개로 늘어난 사기 탐지 시스템 |
1-9. 공식 문서와 참고 자료
섹션 제목: “1-9. 공식 문서와 참고 자료”- scikit-learn 지도 학습: https://scikit-learn.org/stable/supervised_learning.html
- scikit-learn 비지도 학습: https://scikit-learn.org/stable/unsupervised_learning.html
- scikit-learn 내장 데이터(iris, digits): https://scikit-learn.org/stable/datasets/toy_dataset.html
- scikit-learn 결정 트리: https://scikit-learn.org/stable/modules/tree.html
- scikit-learn
export_text: https://scikit-learn.org/stable/modules/generated/sklearn.tree.export_text.html - scikit-learn k-평균: https://scikit-learn.org/stable/modules/clustering.html#k-means
- 다트머스 연구 제안서 (McCarthy 외, 1955): https://www-formal.stanford.edu/jmc/history/dartmouth/dartmouth.html
- Google 머신러닝 용어집: https://developers.google.com/machine-learning/glossary
- 트랜스포머 논문 (Vaswani 외, 2017) “Attention Is All You Need”: https://arxiv.org/abs/1706.03762
- BERT 논문 (Devlin 외, 2018): https://arxiv.org/abs/1810.04805
- GPT-3 논문 (Brown 외, 2020) “Language Models are Few-Shot Learners”: https://arxiv.org/abs/2005.14165