AI 기초 › 05장
일반화와 평가
04장에서는 훈련 데이터의 손실을 줄이는 법을 배웠다. 그런데 모델을 만드는 목적은 이미 정답을 아는 데이터를 다시 맞히는 것이 아니라 처음 보는 데이터를 맞히는 것이다. 이 장은 그 실력을 재는 방법을 다룬다. 데이터를 훈련·검증·테스트로 나누고, 분류 모델의 확률과 임계값을 읽고, 상황에 맞는 지표를 고르고, 과적합과 데이터 누수를 알아본다. 여기서 정한 “어떻게 재는가”가 6장부터 나오는 모든 모델을 비교하는 기준이 된다.
5-1. 이 장의 목표와 완료 기준
섹션 제목: “5-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 일반화를 말한다 | 훈련 점수가 좋아도 모델이 좋다고 할 수 없는 이유를 말한다 |
| 데이터를 나눈다 | 훈련·검증·테스트의 역할을 구분하고, stratify로 비율을 지켜 나눈다 |
| 분류 모델의 출력을 읽는다 | predict_proba의 열 순서를 확인하고, 임계값을 바꾸면 예측이 어떻게 바뀌는지 말한다 |
| 분류 지표를 계산한다 | 혼동행렬에서 정확도·정밀도·재현율·F1을 직접 계산하고, AUC가 무엇을 재는지 말한다 |
| 회귀 지표를 고른다 | MAE·RMSE·R²의 차이를 말하고 이상치에 대한 반응을 비교한다 |
| 과적합을 알아본다 | 훈련·검증 오차를 함께 보고 과소적합·적당·과적합을 구분한다 |
| 교차검증을 쓴다 | cross_val_score로 평균과 표준편차를 내고, 모델 비교에 쓴다 |
| 데이터 누수를 막는다 | 전처리를 훈련 데이터에만 맞추고, 교차검증에서는 전처리를 파이프라인 안에 넣는다 |
| 선택 기준표에 줄을 더한다 | 분할·지표·교차검증을 언제 어떻게 고르는지 적는다 |
| 실습 노트북 05를 끝낸다 | 실습/문제/ch05_일반화와_평가.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
5-2. 왜 평가부터 따로 배우나
섹션 제목: “5-2. 왜 평가부터 따로 배우나”- 잘못 재면 잘못 고른다. 6장부터 모델이 여럿 나온다. 무엇이 더 나은지는 평가 숫자로 정하므로, 그 숫자가 틀리면 이후 선택이 모두 틀린다.
- 숫자 하나가 모든 것을 말하지 않는다. 환자 100명 중 1명만 병이 있으면 “모두 정상”이라고 답하는 모델도 정확도 99%다. 무엇을 놓치면 안 되는지에 따라 봐야 할 지표가 다르다.
- 시험(Level3)에서도 지표가 정해져 있다. 제출물은 정해진 지표로 채점되므로, 그 지표를 내 검증 데이터에서 재현해 보고 제출해야 한다.
5-3. 일반화와 데이터 분할
섹션 제목: “5-3. 일반화와 데이터 분할”처음 보는 데이터에서도 잘 맞히는 능력을 일반화(generalization)라 한다. 훈련 데이터로 재면 일반화를 알 수 없다. 모델이 그 데이터를 이미 봤기 때문이다. 그래서 데이터 일부를 학습에 쓰지 않고 떼어 둔다.
| 데이터 | 하는 일 | 쓰는 횟수 |
|---|---|---|
| 훈련(train) | 매개변수(w·b)를 학습한다 |
학습마다 |
| 검증(validation) | 하이퍼파라미터·모델·임계값을 고른다 | 여러 번 |
| 테스트(test) | 다 고른 뒤 마지막 실력을 보고한다 | 한 번 |
테스트를 보고 모델을 고치면 테스트도 “고르는 데 쓴 데이터”가 되어 점수가 낙관적으로 나온다. 고르는 일은 검증에서 끝낸다.
이 장의 분류 예제는 sklearn 내장 유방암 진단 데이터다. 세포 사진에서 잰 특성 30개로 종양이 악성인지 양성인지 맞힌다. 원래 target은 악성 0, 양성 1인데, 이 장은 찾아내야 할 쪽(악성)을 1로 바꿔 쓴다. 지표를 읽기 쉽게 하려고 처음에는 특성 2개(세포핵 질감 mean texture, 윤곽 매끄러움 mean smoothness)만 쓴다. 30개를 다 쓰면 거의 다 맞혀서 지표 차이가 잘 보이지 않는다(5-8절에서 비교한다).
import numpy as npfrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split
bc = load_breast_cancer(as_frame=True)y = (bc.target == 0).astype(int).to_numpy()                         # 악성 1, 양성 0cols = ["mean texture", "mean smoothness"]X = bc.data[cols].to_numpy()print(X.shape, np.bincount(y), round(y.mean(), 3))
X_tmp, X_te, y_tmp, y_te = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)X_tr, X_va, y_tr, y_va = train_test_split(X_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=0)for name, t in [("훈련", y_tr), ("검증", y_va), ("테스트", y_te)]: print(name, len(t), round(t.mean(), 3))(569, 2) [357 212] 0.373훈련 341 0.372검증 114 0.377테스트 114 0.368train_test_split를 두 번 써서 60 : 20 : 20으로 나눴다. 두 번째의test_size=0.25는 남은 80%의 25%, 즉 전체의 20%다.stratify=y는 나눈 뒤에도 악성 비율(약 37%)이 가능한 한 비슷하게 유지되게 한다(위 출력처럼 소수점 아래는 조금 다르다). 분류에서는 기본으로 넣는다. 어떤 범주의 표본이 너무 적으면(예: 1개) 층화 분할이 오류를 낸다. 특히 한쪽 범주가 드물 때 빼면 검증 데이터에 그 범주가 거의 없을 수 있다.
random_state를 고정하면 같은 분할이 재현된다. 숫자를 바꾸면 분할도, 점수도 바뀐다(5-8절).
5-4. 분류 모델의 출력: 확률과 임계값
섹션 제목: “5-4. 분류 모델의 출력: 확률과 임계값”분류 모델로 로지스틱 회귀(logistic regression)를 쓴다. 이름은 회귀지만 분류 모델이고, 내부는 6장에서 다룬다. 지금은 “특성을 받아 악성일 확률을 내는 모델”로만 쓴다. 04장처럼 표준화는 훈련 데이터로 fit한다.
from sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegression
scaler = StandardScaler().fit(X_tr)                                 # 평균·표준편차는 훈련 데이터에서만Z_tr, Z_va = scaler.transform(X_tr), scaler.transform(X_va)clf = LogisticRegression().fit(Z_tr, y_tr)
proba = clf.predict_proba(Z_va) # (N, 2): 범주별 확률print(clf.classes_, proba.shape)print(proba[:4].round(3))p_va = proba[:, 1] # 악성(1)일 확률print(np.array_equal(clf.predict(Z_va), (p_va >= 0.5).astype(int)))[0 1] (114, 2)[[0.971 0.029] [0.905 0.095] [0.142 0.858] [0.908 0.092]]Truepredict_proba는 범주마다 확률을 주고, 행마다 합이 1이다. 열 순서는classes_를 따른다. 여기서는[0 1]이라[:, 1]이 악성 확률이다. 정답을 문자열로 두면 알파벳순이 되므로 열 순서를 꼭 확인한다.
predict는 확률이 0.5를 넘으면 1이라고 답한다. 이 0.5를 임계값(threshold)이라 한다. 위 출력의True는 이 데이터에서predict와p_va >= 0.5가 같았다는 뜻이다. 확률이 정확히 0.5인 표본이 있으면predict는 0,>= 0.5는 1로 갈리지만 실제로는 드물다. 이 장에서는 임계값 규칙을p >= t로 직접 쓴다.
임계값은 학습이 정하지 않는다. 사람이 목적에 맞게 고르는 값이다. 낮추면 악성이라고 답하는 경우가 늘어난다.
for t in [0.2, 0.3, 0.5, 0.7]: pred = (p_va >= t).astype(int) caught = int(((pred == 1) & (y_va == 1)).sum()) # 실제 악성을 악성으로 맞힘 alarms = int(((pred == 1) & (y_va == 0)).sum()) # 실제 양성을 악성이라 함 print(f"임계값 {t}: 악성 예측 {pred.sum():2d}명, 실제 악성 {y_va.sum()}명 중 {caught:2d}명 찾음, 잘못 경보 {alarms:2d}명")임계값 0.2: 악성 예측 68명, 실제 악성 43명 중 40명 찾음, 잘못 경보 28명임계값 0.3: 악성 예측 58명, 실제 악성 43명 중 38명 찾음, 잘못 경보 20명임계값 0.5: 악성 예측 38명, 실제 악성 43명 중 29명 찾음, 잘못 경보 9명임계값 0.7: 악성 예측 24명, 실제 악성 43명 중 21명 찾음, 잘못 경보 3명임계값을 낮추면 악성을 더 많이 찾지만 양성 환자에게 잘못 경보하는 일도 늘어난다. 어느 쪽을 더 피해야 하는지는 데이터가 아니라 문제 상황이 정한다. 이것을 숫자로 재는 것이 다음 절의 지표다.
5-5. 분류 지표
섹션 제목: “5-5. 분류 지표”혼동행렬
섹션 제목: “혼동행렬”예측과 정답을 두 칸씩 교차해 센 표를 혼동행렬(confusion matrix)이라 한다. 찾으려는 쪽(1)을 양성(positive), 나머지를 음성(negative)이라 부른다. 여기서는 악성이 양성이다(의학의 “양성 종양”과 헷갈리지 않게 이 절에서는 범주를 악성·양성 종양 대신 1·0으로 적는다).
| 예측 0 | 예측 1 | |
|---|---|---|
| 정답 0 | TN 참음성(true negative) | FP 거짓양성(false positive): 잘못된 경보 |
| 정답 1 | FN 거짓음성(false negative): 놓침 | TP 참양성(true positive) |
from sklearn.metrics import confusion_matrix
pred = (p_va >= 0.5).astype(int)cm = confusion_matrix(y_va, pred) # 행 = 정답, 열 = 예측print(cm)tn, fp, fn, tp = cm.ravel()print(tn, fp, fn, tp)[[62 9] [14 29]]62 9 14 29sklearn의 confusion_matrix는 행이 정답, 열이 예측이다. 범주 순서는 정답·예측에 나온 값을 정렬한 순서라 이 예제에서는 [0, 1]이고, 한쪽 범주만 나오면 1×1 표가 될 수 있으므로 늘 네 칸을 얻으려면 labels=[0, 1]을 준다. ravel()하면 TN, FP, FN, TP 순이다. 다른 책·도구는 행과 열을 반대로 두기도 하므로 처음 볼 때 확인한다.
정확도·정밀도·재현율·F1
섹션 제목: “정확도·정밀도·재현율·F1”| 지표 | 식 | 질문 |
|---|---|---|
| 정확도(accuracy) | 전체 중 몇 개를 맞혔나 | |
| 정밀도(precision) | 1이라고 한 것 중 진짜 1은 얼마나 | |
| 재현율(recall) | 진짜 1 중 몇 개를 찾았나 | |
| F1 | 정밀도와 재현율을 함께 (조화평균) |
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
acc = (tp + tn) / (tp + tn + fp + fn)prec, rec = tp / (tp + fp), tp / (tp + fn)f1 = 2 * prec * rec / (prec + rec)print("직접 ", round(acc, 3), round(prec, 3), round(rec, 3), round(f1, 3))print("sklearn", round(accuracy_score(y_va, pred), 3), round(precision_score(y_va, pred), 3), round(recall_score(y_va, pred), 3), round(f1_score(y_va, pred), 3))직접 0.798 0.763 0.674 0.716sklearn 0.798 0.763 0.674 0.716분모가 0이면 지표가 정의되지 않는다. 1이라고 예측한 표본이 없으면 정밀도(TP + FP = 0), 정답 1이 없으면 재현율(TP + FN = 0)을 계산할 수 없다. sklearn은 이때 경고와 함께 0을 돌려주며, zero_division=0처럼 처리 방법을 직접 정할 수 있다. 직접 계산할 때도 분모가 0인지 먼저 확인한다. F1은 산술평균이 아니라 조화평균이라, 둘 중 하나가 낮으면 F1도 낮다. 정밀도 1.0·재현율 0.1이면 산술평균은 0.55지만 F1은 약 0.18이다.
정확도의 함정. “모두 0”이라고 답하는 모델을 만들어 본다.
always0 = np.zeros_like(y_va)print("정확도", round(accuracy_score(y_va, always0), 3), "/ 재현율", recall_score(y_va, always0))정확도 0.623 / 재현율 0.0아무것도 배우지 않은 모델의 정확도가 0.6을 넘는다. 이 데이터는 0이 약 63%이기 때문이다. 0이 99%인 데이터라면 정확도 0.99다. 그래서 범주가 불균형하면 정확도만 보지 않고 이런 단순 기준선과 비교하고, 재현율·정밀도·F1을 함께 본다.
임계값과 정밀도·재현율
섹션 제목: “임계값과 정밀도·재현율”for t in [0.2, 0.3, 0.5, 0.7]: pr = (p_va >= t).astype(int) print(t, round(precision_score(y_va, pr), 3), round(recall_score(y_va, pr), 3), round(f1_score(y_va, pr), 3))0.2 0.588 0.93 0.7210.3 0.655 0.884 0.7520.5 0.763 0.674 0.7160.7 0.875 0.488 0.627임계값을 낮추면 1이라고 답하는 표본이 늘기만 하므로 재현율은 내려가지 않는다. 정밀도는 대체로 떨어지지만, 새로 1이 된 표본에 진짜 1이 많으면 잠깐 오를 수도 있다(그림 왼쪽의 오르내림). 그래서 둘은 대개 한쪽을 올리면 다른 쪽이 내려간다. 암 검진의 1차 선별처럼 놓치면 큰일이면 재현율을, 스팸 차단처럼 잘못된 경보의 비용이 크면(중요한 메일이 스팸함으로) 정밀도를 우선한다. 임계값은 검증 데이터에서 고르고, 테스트에는 고른 값을 그대로 쓴다.
수학 상자: 확률과 혼동행렬
섹션 제목: “수학 상자: 확률과 혼동행렬”혼동행렬의 지표는 조건부 확률(conditional probability)로 읽을 수 있다. 는 “B인 경우만 놓고 봤을 때 A의 비율”이다.
| 지표 | 조건부 확률 | 혼동행렬에서 |
|---|---|---|
| 재현율 | 정답 1인 행에서 예측 1의 비율 | |
| 정밀도 | 예측 1인 열에서 정답 1의 비율 | |
| 거짓양성률(FPR) | 정답 0인 행에서 예측 1의 비율 |
재현율과 정밀도는 조건이 반대다. 재현율과 FPR은 정답 행 안에서 계산한다. 그래서 1·0 각각의 점수 분포는 그대로이고 1의 비율(기저율, base rate)만 바뀐다고 가정하면 재현율과 FPR은 그대로지만, 정밀도는 기저율에 따라 크게 변한다. 같은 검사(재현율 0.9, FPR 0.1)를 1이 37%인 집단과 1%인 집단에 쓰면:
recall_, fpr = 0.9, 0.1for base in [0.37, 0.01]: tp_r, fp_r = recall_ * base, fpr * (1 - base) # 전체 대비 TP·FP 비율 print(base, round(tp_r / (tp_r + fp_r), 3))0.37 0.8410.01 0.0831이 드문 집단에서는 “1이라고 한 것”의 대부분이 잘못된 경보다. 검증 데이터의 범주 비율이 실제 사용 환경과 다르면 정밀도도 달라진다.
ROC 곡선과 AUC
섹션 제목: “ROC 곡선과 AUC”임계값마다 정밀도·재현율이 달라지니, 임계값을 정하기 전에 모델 자체를 비교할 지표도 필요하다. 임계값을 1에서 0으로 내리며 (FPR, 재현율) 점을 이은 것이 ROC 곡선이고, 그 아래 넓이가 AUC(area under the ROC curve)다. 재현율을 ROC에서는 참양성률(TPR)이라고도 부른다.
from sklearn.metrics import roc_curve, roc_auc_score
fpr_v, tpr_v, thr_v = roc_curve(y_va, p_va)print(len(thr_v), round(roc_auc_score(y_va, p_va), 3))
pos, neg = p_va[y_va == 1], p_va[y_va == 0]pairs = (pos[:, None] > neg[None, :]).mean() + 0.5 * (pos[:, None] == neg[None, :]).mean()print(round(pairs, 3)) # 1·0 쌍에서 1의 점수가 더 높은 비율32 0.890.89← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
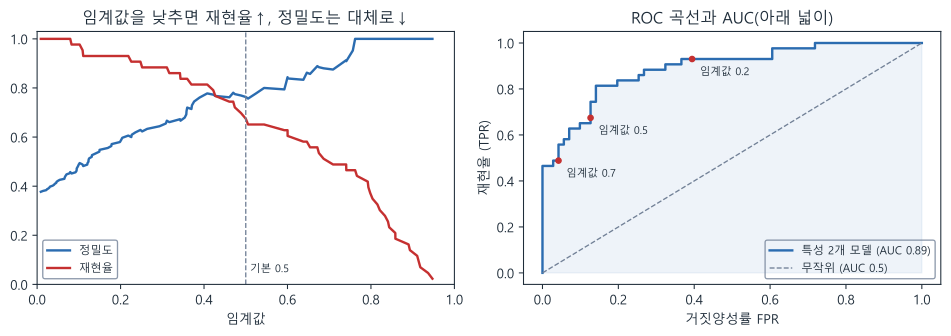
그림 설명. 유방암 특성 2개 모델의 검증 데이터 결과다. 왼쪽은 가로축 임계값(0~1), 세로축 비율(0~1)에 정밀도(파랑)와 재현율(빨강)을 그렸다. 임계값을 0 쪽으로 낮출수록 재현율은 1에 가까워지고 정밀도는 약 0.38(악성 비율)까지 내려가며, 중간중간 정밀도가 잠깐 오르는 곳이 있다. 점선은 기본 임계값 0.5다. 오른쪽 ROC 곡선은 가로축 거짓양성률(FPR), 세로축 재현율(TPR)이다. 곡선이 왼쪽 위로 휠수록 좋은 모델이고, 대각선 점선이 무작위(AUC 0.5)다. 이 모델의 AUC는 0.89이며, 빨간 점은 임계값 0.7·0.5·0.2의 위치로 임계값을 낮출수록 오른쪽 위로 옮겨 간다.
- AUC는 무작위로 뽑은 1 하나와 0 하나에서 1의 점수가 더 높을 확률과 같다(위의 쌍 비교, 동점은 절반). 1이면 완벽한 순서이고, 점수를 무작위로 매기면 기대값이 0.5다. 다만 AUC가 0.5라고 순서가 무작위라는 뜻은 아니며, 0.5보다 작으면 1에 오히려 낮은 점수를 주는 경향이 있다는 뜻이다.
- 임계값과 무관하고 점수의 순서만 본다. 그래서 확률이 아닌 점수(
decision_function)를 넣어도 같고, 임계값을 정하기 전 모델 비교에 좋다. - 순서만 보므로 “확률 0.8이 실제로 80%인가”는 재지 않는다. 그리고 1이 아주 드물면 AUC가 높아도 정밀도가 낮을 수 있어서, 이때는 임계값별 정밀도·재현율을 함께 본다(그림 왼쪽).
roc_auc_score에는 0/1 예측이 아니라 확률이나 점수를 넣는다.predict결과를 넣으면 점이 하나뿐인 곡선의 넓이가 나온다.
5-6. 회귀 지표
섹션 제목: “5-6. 회귀 지표”03장의 당뇨병 데이터로 회귀 지표 세 가지를 비교한다.
| 지표 | 식 | 단위 | 특징 |
|---|---|---|---|
| MAE(mean absolute error) | 정답과 같음 | 오차를 그대로 평균. 이상치에 덜 민감 | |
| RMSE | 정답과 같음 | 큰 오차를 더 크게 벌함. 항상 MAE 이상 | |
| R²(결정계수) | 없음 | 1 완벽, 0은 늘 평균으로 예측한 수준, 더 나쁘면 음수. 는 평가 데이터 정답의 평균이고, 정답이 모두 같으면 식이 정의되지 않는다 |
from sklearn.datasets import load_diabetesfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_absolute_error, root_mean_squared_error, r2_score
dia = load_diabetes(scaled=False)Xd_tr, Xd_te, yd_tr, yd_te = train_test_split(dia.data, dia.target, test_size=0.2, random_state=0)yd_hat = LinearRegression().fit(Xd_tr, yd_tr).predict(Xd_te)print(round(mean_absolute_error(yd_te, yd_hat), 2), round(root_mean_squared_error(yd_te, yd_hat), 2),      round(r2_score(yd_te, yd_hat), 3))
bad = yd_hat.copy()bad[0] += 500 # 한 명만 크게 틀렸다면print(round(mean_absolute_error(yd_te, bad), 2), round(root_mean_squared_error(yd_te, bad), 2))46.17 58.52 0.33249.94 72.84- 89명 중 한 명의 예측만 500 틀어지자 MAE보다 RMSE가 훨씬 크게 늘었다. 제곱이 큰 오차를 키우기 때문이다.
- 큰 오차가 특히 나쁘면(재고 부족, 안전 여유) RMSE, 오차 크기에 비례해 손해가 나고 이상치가 섞여 있으면 MAE를 쓴다. MAE는 “평균 몇 점 틀린다”를 그대로 나타낸다. RMSE도 정답과 단위가 같지만 큰 오차를 더 크게 반영한 값이라 MAE와 같은 뜻은 아니다.
- R²는 같은 평가 데이터에서 “늘 평균으로 예측”하는 기준선보다 얼마나 나은지를 나타낸다. 단위를 바꿔도 값이 같지만, 정답의 분산에 따라 달라지므로 서로 다른 데이터셋의 R²를 나란히 놓고 모델 순위를 매기지 않는다. 보고할 때는 RMSE·MAE와 함께 쓴다.
- sklearn의
scoring이름은"neg_root_mean_squared_error"처럼 음수다. 교차검증 도구는 “클수록 좋다”로 통일하기 때문이다(5-8절).
5-7. 과적합
섹션 제목: “5-7. 과적합”모델이 훈련 데이터의 잡음까지 외우면 훈련 오차는 작아지지만 처음 보는 데이터의 오차는 커진다. 이것을 과적합(overfitting)이라 한다. 반대로 모델이 너무 단순해 훈련 데이터의 패턴도 못 잡으면 과소적합(underfitting)이다.
곡선 모양 데이터에 다항식을 맞추며 차수(degree)를 바꿔 본다. 차수가 모델의 복잡도다. PolynomialFeatures가 를 로 늘리고, 그 위에 04장의 선형 회귀를 맞춘다.
from sklearn.preprocessing import PolynomialFeatures
rng = np.random.default_rng(1)x = rng.uniform(-1, 1, 40)yc = np.sin(np.pi * x) + rng.normal(0, 0.25, 40)                # 사인 곡선 + 잡음idx = rng.permutation(40)tr, va = idx[:12], idx[12:]                                         # 훈련 12, 검증 28
def rmse(a, b):    return np.sqrt(np.mean((a - b) ** 2))
for deg in [1, 3, 5, 7, 9]: poly = PolynomialFeatures(deg).fit(x[tr, None]) m = LinearRegression().fit(poly.transform(x[tr, None]), yc[tr]) r_tr = rmse(m.predict(poly.transform(x[tr, None])), yc[tr]) r_va = rmse(m.predict(poly.transform(x[va, None])), yc[va]) print(f"차수 {deg:2d}: 훈련 RMSE {r_tr:.3f}, 검증 RMSE {r_va:.3f}")차수 1: 훈련 RMSE 0.533, 검증 RMSE 0.563차수 3: 훈련 RMSE 0.153, 검증 RMSE 0.237차수 5: 훈련 RMSE 0.137, 검증 RMSE 0.245차수 7: 훈련 RMSE 0.115, 검증 RMSE 0.305차수 9: 훈련 RMSE 0.083, 검증 RMSE 4.653← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
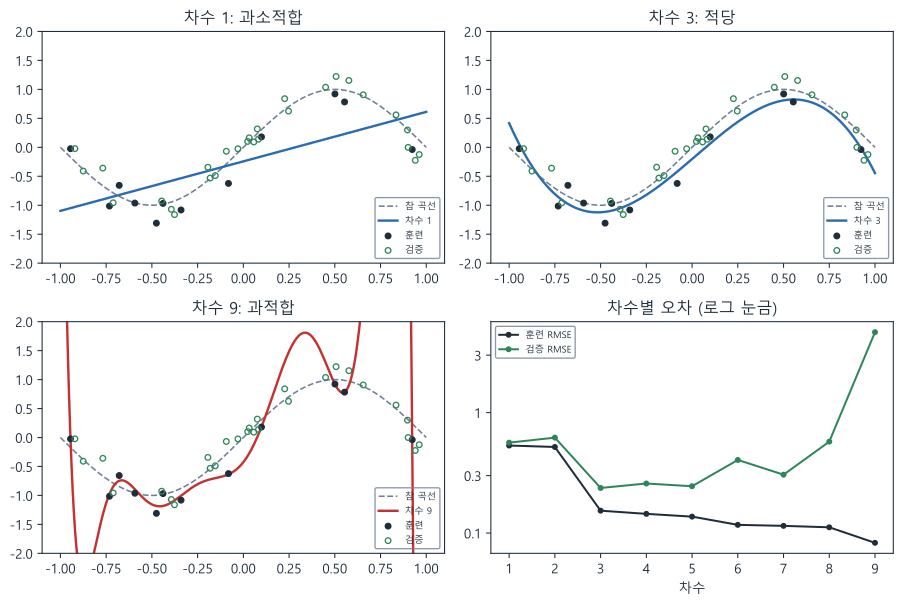
그림 설명. 위 왼쪽·위 오른쪽·아래 왼쪽은 가로축 (−1~1), 세로축 (−2~2)에 참 곡선(점선, 사인 곡선), 훈련 점 12개(채운 점), 검증 점 28개(빈 점), 학습한 다항식을 그렸다. 차수 1은 직선이라 곡선을 따라가지 못하고, 차수 3은 참 곡선과 거의 겹치며, 차수 9는 훈련 점을 거의 지나지만 훈련 점이 없는 양 끝에서 세로 범위 밖으로 크게 휜다. 아래 오른쪽은 가로축 차수(1~9), 세로축 RMSE(로그 눈금)다. 훈련 RMSE는 차수를 올릴수록 계속 내려가지만, 검증 RMSE는 차수 3 근처에서 가장 낮고 그 뒤로 올라가 차수 9에서 약 4.7이 된다.
| 상태 | 훈련 오차 | 검증 오차 | 이 예에서 | 손쓸 방법 |
|---|---|---|---|---|
| 과소적합 | 크다 | 크다 | 차수 1 | 더 복잡한 모델, 특성 추가 |
| 적당 | 작다 | 가장 작다 | 차수 3~5 | |
| 과적합 | 아주 작다 | 커진다 | 차수 7 이상 | 더 많은 데이터, 단순한 모델, 정규화(6장), 조기 종료(11장) |
- 훈련 오차는 차수를 올릴수록 계속 줄었다. 그래서 훈련 오차로는 차수를 고를 수 없다. 검증 오차가 가장 작은 곳을 고른다.
- 과적합의 신호는 훈련·검증 오차의 벌어짐이다. 딥러닝의 학습 곡선(11장)에서는 에폭(epoch, 훈련 데이터 전체를 한 번 다 쓰는 단위로, 그 안에 스텝이 여러 번 있다)이 늘수록 훈련 손실은 내려가는데 검증 손실이 다시 오르는 모습으로 나타난다.
- 차수 9의 검증 오차가 특히 큰 것은 훈련 점이 없는 양 끝에서 곡선이 크게 휘기 때문이다(그림 아래 왼쪽).
- 훈련 데이터가 12개뿐이라 과적합이 빨리 왔다. 같은 차수라도 데이터가 많으면 잡음을 외우기 어려워 과적합이 늦게 온다.
5-8. 교차검증
섹션 제목: “5-8. 교차검증”검증 점수 하나는 운이 섞인다
섹션 제목: “검증 점수 하나는 운이 섞인다”5-3절에서 떼어 둔 테스트는 그대로 두고, 나머지(X_tmp)를 훈련·검증으로 나누는 random_state만 바꿔 같은 모델의 검증 AUC를 본다.
from sklearn.pipeline import make_pipeline
aucs = []for seed in range(6): a_tr, a_va, b_tr, b_va = train_test_split(X_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=seed) model = make_pipeline(StandardScaler(), LogisticRegression()).fit(a_tr, b_tr) aucs.append(roc_auc_score(b_va, model.predict_proba(a_va)[:, 1]))print(np.round(aucs, 3))[0.89 0.902 0.829 0.856 0.87 0.816]- 모델도 데이터도 같은데 나누는 방법에 따라 AUC가 0.1 가까이 흔들린다. 검증 데이터가 114개뿐이라 어떤 환자가 들어가느냐에 따라 점수가 달라진다. 두 모델의 차이가 이 흔들림보다 작으면 검증 한 번으로는 어느 쪽이 나은지 말할 수 없다.
make_pipeline(StandardScaler(), LogisticRegression())은 “표준화 → 모델”을 한 덩어리로 묶는다.fit하면 표준화도 그 데이터로만fit하고,predict_proba하면 같은 값으로 변환한 뒤 예측한다. 자세한 사용법은 9장, 왜 필요한지는 5-9절이다.
k-겹 교차검증
섹션 제목: “k-겹 교차검증”k-겹 교차검증(k-fold cross-validation)은 데이터를 k조각으로 나눠, 조각 하나씩 돌아가며 검증으로 쓰고 나머지로 학습한다. 모든 표본이 한 번씩 검증에 쓰이고, 점수가 k개 나온다. 분류에서는 조각마다 범주 비율을 지키는 StratifiedKFold를 쓴다.
from sklearn.model_selection import StratifiedKFold, cross_val_score
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)for i, (a, b) in enumerate(cv.split(X_tmp, y_tmp)): print(i, len(a), len(b), round(y_tmp[b].mean(), 3))0 364 91 0.3741 364 91 0.3742 364 91 0.3743 364 91 0.3744 364 91 0.374테스트(X_te)는 빼 두고 나머지 455명(X_tmp)만 5조각으로 나눴다. 이제 특성 2개 모델과 30개 모델을 비교한다.
X30 = bc.data.to_numpy()X30_tmp, X30_te, _, _ = train_test_split(X30, y, test_size=0.2, stratify=y, random_state=0)   # 같은 환자 분할
for name, Xc in [("특성 2개", X_tmp), ("특성 30개", X30_tmp)]: model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)) s = cross_val_score(model, Xc, y_tmp, cv=cv, scoring="roc_auc") print(name, s.round(3), "평균", round(s.mean(), 3), "표준편차", round(s.std(ddof=1), 3))특성 2개 [0.779 0.89 0.828 0.826 0.928] 평균 0.85 표준편차 0.059특성 30개 [0.994 1. 0.976 0.987 1. ] 평균 0.992 표준편차 0.01cross_val_score는 조각마다 모델을 새로 학습해 점수를 낸다. 넘긴model객체 자체는 학습되지 않는다.- 결과는 “평균 ± 표준편차”로 읽는다. 특성 2개 모델의 AUC 평균은 약 0.85이고 조각마다 0.15 가까이 차이 난다. 30개 모델은 평균 0.99에 흔들림도 작다. 두 모델의 차이가 흔들림보다 훨씬 크므로 30개 모델이 낫다고 말할 수 있다.
scoring에는 5-5·5-6절의 지표 이름을 넣는다:"accuracy","f1","roc_auc","neg_root_mean_squared_error"등.- 교차검증은 k번 학습하므로 k배 오래 걸린다. 데이터가 크거나 딥러닝처럼 학습이 오래 걸리면 검증 데이터 하나로 대신하는 경우가 많다.
마지막에 테스트 한 번
섹션 제목: “마지막에 테스트 한 번”모델을 고른 뒤에야 테스트를 쓴다. 고른 설정으로 훈련 데이터와 검증 데이터 전체(X30_tmp)를 써서 모델을 다시 학습시킨 뒤, 테스트 데이터에서 한 번 잰다.
final = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)).fit(X30_tmp, y_tmp)p_te = final.predict_proba(X30_te)[:, 1]print("테스트 AUC", round(roc_auc_score(y_te, p_te), 3), "/ 재현율", round(recall_score(y_te, (p_te >= 0.5).astype(int)), 3))print(confusion_matrix(y_te, (p_te >= 0.5).astype(int)).ravel())테스트 AUC 0.993 / 재현율 0.952[71 1 2 40]테스트 점수가 기대보다 낮게 나와도 여기서 다시 고치지 않는다. 고치면 테스트가 검증이 되어 버린다. 결과를 그대로 보고하고, 다음 개선은 새 테스트 데이터로 확인한다.
수학 상자: 표본과 분산
섹션 제목: “수학 상자: 표본과 분산”교차검증 점수 5개는 “무한히 많은 분할에서 나올 점수” 중 몇 개를 뽑은 표본(sample)이다. 표본으로 전체의 평균과 흩어짐을 추정한다.
- 표본 평균
- 표본 분산 , 표준편차 . 표본으로 전체 분산을 추정할 때는 k가 아니라 k − 1로 나눈다(평균을 표본에서 구한 만큼 흩어짐이 작게 나오는 것을 보정).
- 서로 독립인 점수 개의 평균은 만큼 흔들린다(표준오차). 교차검증 점수는 학습 데이터가 겹쳐 독립이 아니므로 이 식을 그대로 쓰지 않는다.
import pandas as pd
s = np.array([0.779, 0.890, 0.828, 0.826, 0.928])print(round(s.std(), 4), round(s.std(ddof=1), 4), round(pd.Series(s).std(), 4))0.0525 0.0587 0.0587NumPy std는 기본이 k로 나누는 것(ddof=0), pandas std는 k − 1(ddof=1)이다(03장). 표본이 5개처럼 적으면 차이가 크므로 무엇을 썼는지 적는다. 교차검증 결과는 평균과 조각별 표준편차를 그대로 보고하고, 표준오차로 바꿔 “평균이 이만큼만 흔들린다”고 말하지 않는다.
5-9. 데이터 누수
섹션 제목: “5-9. 데이터 누수”데이터 누수(data leakage)는 예측할 때는 쓸 수 없는 정보가 학습이나 평가에 섞이는 것이다. 검증 점수는 좋은데 실제 사용에서 무너지는 가장 흔한 원인이다.
| 종류 | 예 | 막는 법 |
|---|---|---|
| 전처리 누수 | 스케일러·인코더·결측 대체값·특성 선택을 전체 데이터로 fit한 뒤 나눔 |
나눈 뒤 훈련 데이터로만 fit. 교차검증에서는 파이프라인 안에 넣기 |
| 정답 누수 | 정답이 정해진 뒤에야 생기는 값이 특성에 있음(예: 불량 판정 뒤 붙는 “반품 처리 비용”) | 예측 시점에 알 수 있는 특성만 쓰기 |
| 그룹 누수 | 같은 환자의 사진 여러 장이 훈련과 검증에 나뉘어 들어감 | 사람·기기 단위로 나누기(GroupKFold) |
| 시간 누수 | 미래 데이터로 학습하고 과거를 검증 | 시간순으로 나누기(TimeSeriesSplit) |
전처리 누수를 눈으로 보기
섹션 제목: “전처리 누수를 눈으로 보기”정답과 아무 관계 없는 무작위 특성 5000개와 무작위 정답 100개를 만든다. 진짜 실력은 정확도 0.5(동전 던지기)여야 한다. 정답과 상관이 높은 특성 20개를 고르는 SelectKBest를 두 방식으로 쓴다.
from sklearn.feature_selection import SelectKBest, f_classif
r = np.random.default_rng(0)Xn, yn = r.normal(size=(100, 5000)), r.integers(0, 2, 100)
Xn_sel = SelectKBest(f_classif, k=20).fit_transform(Xn, yn)          # 잘못: 전체 데이터로 특성 선택leak = cross_val_score(LogisticRegression(), Xn_sel, yn, cv=5)
pipe = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression()) # 바름: 조각마다 훈련 부분으로만 선택clean = cross_val_score(pipe, Xn, yn, cv=5)print("누수", leak.round(2), round(leak.mean(), 2))print("바름", clean.round(2), round(clean.mean(), 2))누수 [0.7 0.8 0.85 0.9 1. ] 0.85바름 [0.45 0.6 0.3 0.45 0.6 ] 0.48- 전체 데이터로 특성을 고르면, 검증 조각의 정답까지 보고 “우연히 정답과 맞아떨어진” 특성을 고른다. 그래서 의미 없는 데이터에서 정확도가 0.85로 나왔다.
- 선택을 파이프라인 안에 넣으면 조각마다 훈련 부분으로만 고르므로 동전 던지기 수준(약 0.5)으로 돌아간다. 이것이 진짜 실력이다.
- 스케일러를 전체로
fit하는 누수는 보통 점수 차이가 이보다 훨씬 작다. 그래도 규칙은 같다.fit하는 모든 전처리는 훈련 데이터(교차검증에서는 훈련 조각)로만. 파이프라인으로 묶으면 이 규칙이 저절로 지켜진다.
5-10. 지표 고르기
섹션 제목: “5-10. 지표 고르기”| 상황 | 볼 지표 | 이유 |
|---|---|---|
| 범주가 고르고 두 오류의 비용이 비슷하다 | 정확도 | 가장 설명하기 쉽다 |
| 1을 놓치면 큰일이다(질병 1차 선별, 사기 탐지) | 재현율(+ 정밀도 하한) | FN을 줄인다. 정밀도가 너무 떨어지지 않게 함께 본다 |
| 잘못된 경보의 비용이 크다(스팸 차단, 자동 처벌) | 정밀도(+ 재현율 하한) | FP를 줄인다 |
| 둘 다 중요하고 범주가 불균형하다 | F1 | 정확도의 함정을 피하고 두 오류를 함께 본다 |
| 임계값을 아직 정하지 않고 모델을 비교한다 | AUC | 순서만 보므로 임계값과 무관 |
| 숫자 예측, 큰 오차가 특히 나쁘다 | RMSE | 큰 오차를 크게 벌한다 |
| 숫자 예측, 이상치가 섞였거나 평균 오차를 설명해야 한다 | MAE | 이상치에 덜 민감, 해석이 직관적 |
| 평균 예측 기준선보다 얼마나 나은지 단위 없이 말해야 한다 | R² | 같은 평가 데이터 안에서만 비교하고, RMSE·MAE와 함께 보고 |
시험·대회처럼 채점 지표가 정해져 있으면 그 지표로 검증한다. 정확도로 고른 모델이 F1에서도 가장 좋다는 보장은 없다.
5-11. 선택 기준표에 추가
섹션 제목: “5-11. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 모델 성능을 잰다 | 훈련·검증·테스트로 나누고(분류는 stratify), 고르기는 검증에서, 테스트는 마지막 한 번 |
훈련 점수는 일반화를 말해 주지 않고, 테스트로 고르면 점수가 낙관적이 된다 | 05 |
| 데이터가 수천 개 이하이거나 두 모델의 차이가 작다 | k-겹 교차검증(분류는 StratifiedKFold), 평균 ± 표준편차로 비교 |
검증 한 번의 점수는 분할 운에 흔들린다 | 05 |
| 범주가 불균형한 분류 | 정확도 대신 재현율·정밀도·F1·AUC, “모두 다수 범주” 기준선과 비교 | 아무것도 안 배운 모델도 정확도가 높게 나온다 | 05 |
| FN과 FP의 비용이 다르다 | 확률을 내는 모델 + 검증 데이터에서 임계값 고르기 | 0.5는 기본값일 뿐, 목적에 맞는 임계값은 사람이 정한다 | 05 |
fit하는 전처리(스케일러·인코더·특성 선택)가 있다 |
나눈 뒤 훈련 데이터로만 fit, 교차검증은 make_pipeline으로 묶기 |
전체로 fit하면 검증 정보가 새어 점수가 부풀려진다 |
05 |
확인 문제
섹션 제목: “확인 문제”11문항. 풀면 결과가 기록되고 복습 일정에 들어간다.
5-12. 실습과 문제
섹션 제목: “5-12. 실습과 문제”실습/문제/ch05_일반화와_평가.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 훈련·검증·테스트 역할과 과적합 참/거짓 |
| 2 | 코드 | 혼동행렬 칸 수 직접 세기 |
| 3 | 코드 | 정밀도·재현율·F1 직접 계산(0으로 나누기 처리 포함) |
| 4 | 개념 | 분류·회귀 지표 참/거짓 |
| 5 | 코드 | 목표 재현율을 만족하는 임계값 고르기 |
| 6 | 코드 | 쌍 비교로 AUC 계산, roc_auc_score와 비교 |
| 7 | 코드 | 검증 오차로 다항식 차수 고르기 |
| 8 | 코드 | k-겹 교차검증을 직접 구현(조각마다 스케일러 fit) |
| 9 | 사례 | 검증 점수가 너무 좋은 모델의 누수 진단 |
| 10 | 사례 | 상황별 지표 고르기 |
5-13. 공식 문서와 참고 자료
섹션 제목: “5-13. 공식 문서와 참고 자료”- 교차검증: https://scikit-learn.org/stable/modules/cross_validation.html
- 분류·회귀 지표: https://scikit-learn.org/stable/modules/model_evaluation.html
train_test_split: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.train_test_split.htmlStratifiedKFold: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.StratifiedKFold.htmlcross_val_score: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.cross_val_score.htmlconfusion_matrix: https://scikit-learn.org/stable/modules/generated/sklearn.metrics.confusion_matrix.htmlroc_auc_score: https://scikit-learn.org/stable/modules/generated/sklearn.metrics.roc_auc_score.html- 과소적합과 과적합(다항식 예): https://scikit-learn.org/stable/auto_examples/model_selection/plot_underfitting_overfitting.html
- 흔한 함정(전처리 누수): https://scikit-learn.org/stable/common_pitfalls.html
- 유방암 데이터
load_breast_cancer: https://scikit-learn.org/stable/modules/generated/sklearn.datasets.load_breast_cancer.html