03장에서 결측을 채우고 범주를 원-핫으로 바꿨고, 05장에서 전처리는 훈련 데이터에만 맞춰야 한다고 했고, 06~08장에서 로지스틱 회귀·트리 앙상블·kNN을 교차검증으로 비교했다. 이 장은 이 조각들을 한 덩어리로 묶어 표 데이터 문제 하나를 처음부터 끝까지 푼다. 열마다 다른 전처리를 ColumnTransformer로, 전처리와 모델을 Pipeline으로 묶고, 기준선 → 한 번에 하나씩 개선 → 하이퍼파라미터 탐색 → 제출으로 나아간다. 마지막으로 전처리까지 포함한 모델을 저장해 새 프로세스에서 다시 불러 같은 예측이 나오는지 확인하고, 제출 파일의 행이 양식과 맞는지 점검한다. 2부를 마치며 1·2부의 선택 기준표를 작업 순서대로 정리한다.
9-1. 이 장의 목표와 완료 기준
섹션 제목: “9-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 열마다 다른 전처리를 묶는다 | 숫자·범주 열에 다른 전처리를 ColumnTransformer로 적용하고, 처음 보는 범주·결측이 어떻게 처리되는지 확인한다 |
| 전처리와 모델을 한 덩어리로 만든다 | Pipeline으로 묶어 교차검증·예측·저장을 한 객체로 한다 |
| 기준선부터 잰다 | 평균만 예측하는 모델과 선형 모델로 기준 점수를 만들고, 이후 개선을 같은 교차검증 조각으로 비교한다 |
| 특성 공학을 파이프라인에 넣는다 | 날짜·비율 특성을 함수로 만들어 FunctionTransformer로 넣고, 치우친 목표를 로그로 바꿔 학습한다 |
| 하이퍼파라미터를 탐색한다 | GridSearchCV로 파이프라인 안의 인자를 단계__인자 이름으로 탐색하고 결과 표를 읽는다 |
| 마지막 확인과 제출을 한다 | 홀드아웃에서 한 번 확인하고, 전체 훈련 데이터로 다시 학습해 양식과 같은 행 순서의 제출 파일을 만든다 |
| 저장하고 다시 불러온다 | joblib으로 저장한 파이프라인을 새 프로세스에서 불러 같은 예측을 확인하고, 재현에 필요한 조건을 말한다 |
| 1·2부 기준표를 정리한다 | 표 데이터 작업 순서에 따라 지금까지의 선택 기준을 말한다 |
| 실습 노트북 09를 끝낸다 | 실습/문제/ch09_표_데이터_실전_파이프라인.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
9-2. 왜 파이프라인인가
섹션 제목: “9-2. 왜 파이프라인인가”지금까지는 전처리 한 단계, 모델 하나를 따로 보여 주었다. 실제 문제에서는 이것들을 이어 붙이다가 틀린다. 자주 깨지는 곳은 세 군데다.
- 누수. 결측을 채우는 중앙값, 표준화의 평균·표준편차, 원-핫의 범주 목록은 모두 데이터로
fit하는 값이다. 교차검증 조각마다 훈련 부분으로만 다시 맞춰야 하는데(05장), 손으로 하면 빠뜨린다. - 훈련과 예측의 규칙이 어긋난다. 훈련 때는 노트북 위쪽 셀에서 특성을 만들고 열 순서를 바꾸지만, 제출용 테스트 데이터를 처리할 때는 그 셀 하나를 실행하지 않는다. 오류 없이 엉뚱한 예측이 나온다.
- 제출 행이 어긋난다. 예측 배열은 순서만 있고 id가 없다. 테스트 표를 정렬하거나 결측 행을 지운 뒤 예측하면, 예측이 다른 차의 id에 붙는다. 이것도 오류가 나지 않는다.
Pipeline은 “원본 표를 받아 예측을 내는 전체 과정”을 객체 하나로 만든다. fit 한 번에 모든 단계가 같은 데이터로 맞춰지고, predict 한 번에 같은 규칙이 적용되고, 저장하면 전처리까지 함께 저장된다. 세 문제 중 앞의 둘을 구조로 막는다. 셋째는 9-7절의 점검으로 막는다.
9-3. 과제와 데이터
섹션 제목: “9-3. 과제와 데이터”가상 중고차 가격
섹션 제목: “가상 중고차 가격”중고차 판매 공고 4000건 중 3000건(train)에는 가격이 있고, 1000건(test)에는 없다. test의 가격을 예측해 양식(sample)에 맞춰 제출한다. 지표는 RMSE(만원)이다. 실제 대회·시험의 train.csv, test.csv, sample_submission.csv 구성과 같다.
데이터는 아래 규칙으로 만든다. 가격은 신차 가격(제조사 × 차종 × 연료)에서 해마다 일정 비율씩 빠지고, 수입차·전기차는 더 빨리 빠진다. 한 해 주행거리가 2만 km를 넘으면 더 싸고, 사고가 날 때마다 싸진다. 색상은 가격과 무관하다. 실제 문제에서는 이 규칙을 모른다. 여기서는 개선이 왜 통했는지 확인하려고 알고 시작한다.
import numpy as npimport pandas as pd
def make_cars(n, seed):    rng = np.random.default_rng(seed)    makers = ["현대", "기아", "제네시스", "쉐보레", "르노", "KG", "BMW", "벤츠", "아우디", "볼보", "미니"]    new = dict(zip(makers, [2600, 2500, 5200, 2300, 2200, 2400, 5500, 6000, 5000, 4800, 3500]))  # 신차 가격(만원)    body = {"경차": 0.55, "세단": 1.0, "SUV": 1.25, "승합": 1.15}    fuel = {"가솔린": 1.0, "디젤": 1.05, "LPG": 0.85, "하이브리드": 1.15, "전기": 1.3}    df = pd.DataFrame({        "제조사": rng.choice(makers, n, p=[0.30, 0.28, 0.06, 0.07, 0.06, 0.05, 0.07, 0.07, 0.02, 0.01, 0.01]),        "차종": rng.choice(list(body), n, p=[0.15, 0.4, 0.35, 0.1]),        "연료": rng.choice(list(fuel), n, p=[0.5, 0.2, 0.08, 0.14, 0.08]),        "연식": rng.integers(2010, 2025, n),        "색상": rng.choice(["흰색", "검정", "회색", "파랑", "빨강"], n),    })    ad = pd.Timestamp("2024-01-01") + pd.to_timedelta(rng.integers(0, 731, n), unit="D")    df["공고일"] = ad.strftime("%Y-%m-%d")                                 # 판매 공고 날짜(문자열)    age = (ad.year - df["연식"]).clip(lower=0) + rng.uniform(0, 1, n)       # 실제 차령(년)    annual = rng.gamma(4.0, 3500, n)                                        # 한 해 주행(km)    df["주행거리"] = (annual * np.maximum(age, 0.3)).round(-2)    df["사고횟수"] = rng.poisson(0.4, n)    imported = df["제조사"].isin(["BMW", "벤츠", "아우디", "볼보", "미니"])    rate = 0.09 + 0.07 * imported + 0.05 * (df["연료"] == "전기")            # 해마다 값이 빠지는 비율    log_price = (np.log(df["제조사"].map(new) * df["차종"].map(body) * df["연료"].map(fuel))                 - rate * age - 0.25 * (annual > 20000) - 0.08 * df["사고횟수"] + rng.normal(0, 0.12, n))    df["가격"] = np.exp(log_price).round()    df.loc[rng.random(n) < 0.08, "주행거리"] = np.nan    df.loc[rng.random(n) < 0.05, "연료"] = np.nan    df.insert(0, "id", np.arange(1, n + 1))    return df
cars = make_cars(4000, seed=0)train = cars.iloc[:3000].reset_index(drop=True) # 정답이 있는 표test = cars.iloc[3000:].drop(columns="가격").reset_index(drop=True) # 정답이 없는 표(제출 대상)test.loc[[5, 400, 800], "제조사"] = "포르쉐" # 훈련에 없는 제조사sample = pd.DataFrame({"id": test["id"], "가격": 0.0}) # 제출 양식print(train.shape, test.shape, sample.shape)print(train.head(3).to_string())(3000, 10) (1000, 9) (1000, 2) id 제조사 차종 연료 연식 색상 공고일 주행거리 사고횟수 가격0 1 제네시스 SUV 디젤 2010 파랑 2024-05-16 113000.0 0 2288.01 2 현대 세단 LPG 2017 빨강 2024-08-06 NaN 0 981.02 3 현대 세단 LPG 2022 회색 2024-02-01 18700.0 0 1874.0먼저 볼 것
섹션 제목: “먼저 볼 것”모델보다 먼저 결측, 범주, 테스트에만 있는 값, 목표의 분포를 본다(03장).
print("결측:", train.isna().sum()[lambda s: s > 0].to_dict())print("범주 수:", {c: train[c].nunique() for c in ["제조사", "차종", "연료", "색상"]})print("테스트에만 있는 제조사:", set(test["제조사"]) - set(train["제조사"]))print("가격 평균", round(train["가격"].mean()), "/ 중앙값", round(train["가격"].median()), "/ 최대", train["가격"].max(), "/ 왜도", round(train["가격"].skew(), 2), "→ 로그 뒤", round(np.log(train["가격"]).skew(), 2))결측: {'연료': 160, '주행거리': 238}범주 수: {'제조사': 11, '차종': 4, '연료': 5, '색상': 5}테스트에만 있는 제조사: {'포르쉐'}가격 평균 1468 / 중앙값 1206 / 최대 8646.0 / 왜도 2.1 → 로그 뒤 0.02- 숫자 열(주행거리)과 범주 열(연료)에 결측이 있다. 둘 다 채우는 방법이 달라야 한다.
- 테스트에 훈련에 없는 제조사가 있다. 원-핫 인코더를 기본값으로 두면
transform에서 오류가 난다(03장). - 가격은 평균이 중앙값보다 크고 왜도(skewness, 분포가 한쪽으로 늘어진 정도. 좌우 대칭인 분포는 0이다. 다만 0에 가깝다고 대칭이 보장되지는 않는다)가 2를 넘는다. 비싼 차 몇 대가 오른쪽으로 길게 늘어져 있다. 로그를 씌우면 왜도가 0 가까이로 줄어 한쪽으로 늘어진 꼬리가 거의 사라진다. 9-5절에서 쓴다.
공고일은 문자열이라 그대로는 모델에 넣을 수 없다.id는 특성이 아니다(03장). 제출할 때만 쓴다.
잠깐 확인 (ch09-i01)
판매 공고 번호 id(1, 2, 3, …)를 다른 열과 함께 특성으로 넣어 학습하려 한다. 알맞은 판단은?
숫자 열이므로 표준화만 하면 특성으로 써도 된다
범주로 보고 원-핫으로 바꿔 넣는다
표본을 가리키는 번호일 뿐이라 특성에서 빼고, 제출할 때 예측과 짝지을 때만 쓴다
넣으면 교차검증에서 오류가 나므로 뺀다
개발·홀드아웃·교차검증
섹션 제목: “개발·홀드아웃·교차검증”정답이 있는 3000건을 개발(development) 데이터 2400건과 홀드아웃(hold-out) 600건으로 나눈다. 모델 고르기와 탐색은 모두 개발 데이터의 5겹 교차검증으로 하고, 홀드아웃은 다 고른 뒤 한 번만 본다(05장의 테스트 역할). 제출 대상 test에는 정답이 없으니 점수를 잴 수 없다.
from sklearn.model_selection import train_test_split, KFold
X = train.drop(columns=["id", "가격"]) # id는 특성이 아니다y = train["가격"]X_dev, X_hold, y_dev, y_hold = train_test_split(X, y, test_size=0.2, random_state=0)cv = KFold(n_splits=5, shuffle=True, random_state=0) # 모든 비교에 같은 조각print("개발", X_dev.shape, "/ 홀드아웃", X_hold.shape)개발 (2400, 8) / 홀드아웃 (600, 8)- 회귀라서
stratify없이KFold(shuffle=True)를 쓴다.random_state를 고정한cv객체 하나를 모든 비교에 넘겨, 모델들이 같은 조각으로 채점되게 한다.
잠깐 확인 (ch09-i02)
모델마다 KFold(shuffle=True)를 새로 만들고 random_state를 서로 다르게 주면, 모델 간 점수 차이를 더 공정하게 비교할 수 있다.
O / X
9-4. 기준선: ColumnTransformer와 Pipeline
섹션 제목: “9-4. 기준선: ColumnTransformer와 Pipeline”열마다 다른 전처리
섹션 제목: “열마다 다른 전처리”숫자 열은 중앙값으로 채우고 표준화하고, 범주 열은 가장 흔한 값으로 채우고 원-핫으로 바꾼다. ColumnTransformer는 열 목록마다 다른 전처리를 적용하고 결과를 옆으로 이어 붙인다. 각 전처리는 make_pipeline으로 여러 단계를 이을 수 있다.
from sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipeline, make_pipelinefrom sklearn.impute import SimpleImputerfrom sklearn.preprocessing import StandardScaler, OneHotEncoder
num_cols = ["연식", "주행거리", "사고횟수"]cat_cols = ["제조사", "차종", "연료"]
def linear_prep(num_cols):    return ColumnTransformer([        ("num", make_pipeline(SimpleImputer(strategy="median"), StandardScaler()), num_cols),        ("cat", make_pipeline(SimpleImputer(strategy="most_frequent"),                              OneHotEncoder(handle_unknown="ignore", sparse_output=False)), cat_cols),    ])                                                                    # 목록에 없는 열(색상·공고일)은 버린다
prep = linear_prep(num_cols)Z = prep.fit_transform(X_dev) # 개발 데이터로만 fitprint(Z.shape, list(prep.get_feature_names_out()[[0, 1, 2, 3, 14]]))print("주행거리 결측을 채운 값(개발 중앙값):", prep.named_transformers_["num"][0].statistics_[1])print("포르쉐 행의 제조사 열 합:", prep.transform(test.iloc[[5]])[:, 3:14].sum())(2400, 23) ['num__연식', 'num__주행거리', 'num__사고횟수', 'cat__제조사_BMW', 'cat__차종_SUV']주행거리 결측을 채운 값(개발 중앙값): 89350.0포르쉐 행의 제조사 열 합: 0.0- 열은 숫자 3개 + 제조사 11개 + 차종 4개 + 연료 5개 = 23개다. 출력 열 이름은
변환이름__원래열_범주꼴이라 어느 열에서 왔는지 알 수 있다. remainder(목록에 없는 열의 처리) 기본값은"drop"이라 색상·공고일은 버려진다. 남기려면remainder="passthrough"로 둔다. 버리는 열을 명시적으로 정해 두면 테스트에 엉뚱한 열이 더 있어도 영향이 없다.- 결측을 채운 값은
fit한 데이터(개발)의 중앙값이고, 테스트에도 같은 값을 쓴다. 처음 보는 포르쉐는 제조사 열이 모두 0이 된다(handle_unknown="ignore"). - 원-핫 결과는 기본으로 대부분 0인 희소 행렬이다. 여기서는 출력을 보려고
sparse_output=False로 보통 배열을 받았다. 범주가 수천 개면 희소 행렬이 메모리를 아낀다.
잠깐 확인 (ch09-i03)
훈련 데이터에 없던 제조사 "포르쉐"가 테스트 데이터에 있다. OneHotEncoder(handle_unknown="ignore")를 쓴 파이프라인으로 예측하면 그 행은 어떻게 되는가?
제조사 원-핫 열이 모두 0이 된다
transform에서 오류가 난다가장 흔한 제조사로 바뀌어 그 열이 1이 된다
"제조사_포르쉐" 열이 새로 생긴다
전처리 + 모델 한 덩어리
섹션 제목: “전처리 + 모델 한 덩어리”Pipeline은 (이름, 단계) 목록을 차례로 잇는다. 이 장의 예측용 파이프라인은 마지막 단계가 모델이고, 앞 단계는 모두 fit/transform을 하는 변환기다(전처리만 묶은 파이프라인은 마지막 단계도 변환기일 수 있다). fit하면 앞 단계부터 fit_transform해 다음 단계에 넘기고, predict하면 앞 단계는 transform만 한다. make_pipeline은 이름을 자동으로 붙이는 줄임 형태다(05·08장).
평균만 예측하는 DummyRegressor와 선형 모델 Ridge(06장)로 기준선을 잰다.
from sklearn.model_selection import cross_val_scorefrom sklearn.linear_model import Ridgefrom sklearn.dummy import DummyRegressor
def cv_rmse(model):    return -cross_val_score(model, X_dev, y_dev, cv=cv, scoring="neg_root_mean_squared_error")
ridge = Pipeline([("prep", linear_prep(num_cols)), ("model", Ridge())])for name, model in [("평균만 예측", DummyRegressor()), ("Ridge", ridge)]: s = cv_rmse(model) print(f"{name:7s} RMSE {s.mean():6.1f} ± {s.std(ddof=1):5.1f}")ridge.fit(X_dev, y_dev)print("단계:", list(ridge.named_steps), "/ 테스트 앞 3대 예측", ridge.predict(test.head(3)).round())평균만 예측 RMSE 957.2 ± 69.6Ridge RMSE 492.7 ± 42.7단계: ['prep', 'model'] / 테스트 앞 3대 예측 [766. 556. 771.]← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
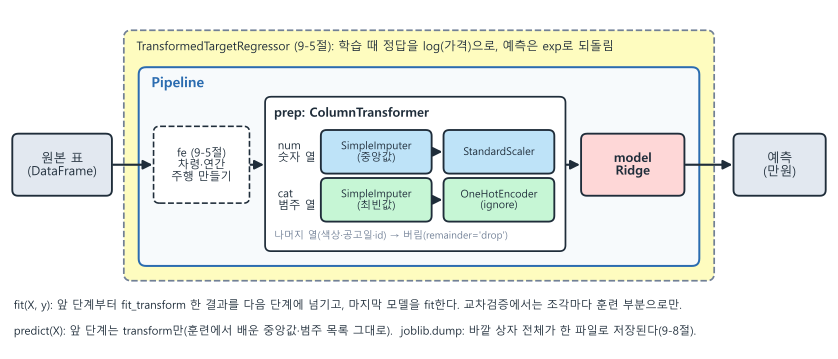
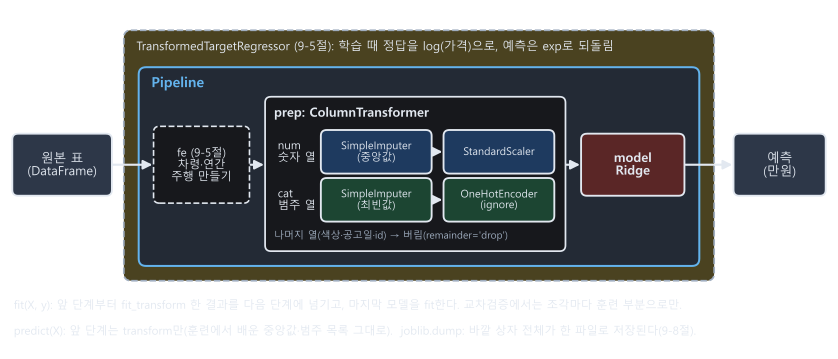
그림 설명. 왼쪽 “원본 표(DataFrame)“에서 오른쪽 “예측(만원)“까지 화살표로 이어진다. 가운데 파란 테두리 상자가 Pipeline이고, 그 안에 차례로 점선 상자 “fe(9-5절): 차령·연간주행 만들기”, 실선 상자 “prep: ColumnTransformer”, “model Ridge”가 있다. ColumnTransformer 안은 두 줄이다. 숫자 열은 SimpleImputer(중앙값) → StandardScaler, 범주 열은 SimpleImputer(최빈값) → OneHotEncoder(ignore)를 지나고, 나머지 열(색상·공고일·id)은 버린다(remainder='drop'). Pipeline 바깥을 점선 상자 “TransformedTargetRegressor(9-5절)“가 감싸며, 학습 때 정답을 log(가격)으로 바꾸고 예측은 exp로 되돌린다. 아래 두 줄은 fit은 앞 단계부터 fit_transform한 결과를 다음 단계로 넘기고, predict는 앞 단계를 transform만 하며, joblib.dump는 바깥 상자 전체를 한 파일로 저장한다는 설명이다.
- sklearn의
scoring은 “클수록 좋다”로 통일돼 있어 오차 지표는 음수(neg_)로 준다. 부호를 바꿔 RMSE로 읽는다. - 평균만 예측하면 RMSE가 950 정도다. 이것이 “아무것도 배우지 않은” 점수이고, Ridge는 그 절반쯤이다. 앞으로의 개선은 모두 이 숫자와 비교한다.
cross_val_score에 파이프라인을 넘기면 조각마다 전처리까지 훈련 부분으로만 다시 맞춘다. 전처리 때문에 생기는 누수는 따로 신경 쓰지 않아도 된다. 다만 시간·그룹에 맞게 나눴는지, 특성에 예측 시점에는 모를 정보가 섞였는지는 파이프라인이 막아 주지 않으므로 따로 확인한다.test에는id열이 더 있지만ColumnTransformer가 열 이름으로 골라 쓰므로 그대로 넣어도 된다. 전처리에서 실제로 쓰는 열의 이름이 바뀌거나 빠지면 오류가 난다. 조용히 틀리는 것보다 낫다.
기준선은 바로 제출해 둔다
섹션 제목: “기준선은 바로 제출해 둔다”기준선이 나오면 개선보다 먼저 제출 파일까지 한 번 만든다(9-7절의 순서). 시간이 모자라도 0점은 피하고, 제출 형식의 문제를 일찍 발견한다.
잠깐 확인 (ch09-i04)
모델을 고르기 전에 평균만 예측하는 DummyRegressor의 교차검증 RMSE(957)를 먼저 재는 이유는?
DummyRegressor가 표 데이터에서 대개 가장 좋은 제출 모델이기 때문이다교차검증 조각을 만들려면 먼저 이 모델을 학습해야 하기 때문이다
평균만 예측하면 RMSE가 MAE와 같아져 지표를 맞출 수 있기 때문이다
아무것도 배우지 않은 점수를 알아야 다른 모델이 정말 배웠는지 판단할 수 있기 때문이다
9-5. 개선: 한 번에 하나씩
섹션 제목: “9-5. 개선: 한 번에 하나씩”개선은 한 번에 하나씩 바꾸고 같은 교차검증 조각으로 잰다. 여러 개를 한꺼번에 바꾸면 무엇이 효과였는지 모른다.
치우친 목표는 로그로
섹션 제목: “치우친 목표는 로그로”신차 가격에 해마다 일정 비율씩 곱해 값이 빠지므로, 가격은 여러 요인의 곱이다. 선형 모델은 요인을 더한다. 로그를 씌우면 곱이 더하기가 된다(일 때 ). TransformedTargetRegressor는 학습할 때 정답에 func를 적용하고, 예측을 inverse_func로 되돌린다. 점수는 원래 단위(만원)로 잰다.
from sklearn.compose import TransformedTargetRegressor
def log_target(model):    return TransformedTargetRegressor(model, func=np.log, inverse_func=np.exp)
ridge_log = log_target(ridge)s = cv_rmse(ridge_log)print(f"Ridge + 로그 RMSE {s.mean():6.1f} ± {s.std(ddof=1):5.1f}")Ridge + 로그 RMSE 388.4 ± 52.2- 모델은 같고 목표만 바꿨는데 RMSE가 크게 준다. 정답이 모두 양수이고 오른쪽으로 길게 늘어진 값(가격·소득)이면 로그를 먼저 시도한다. 0이 있는 0 이상의 값(조회수 등)이면
np.log1p/np.expm1()을 쓴다. 음수가 있으면 로그를 그대로 쓸 수 없다. - 로그 공간에서 오차 제곱을 줄인 예측은 로그값의 평균을 지수로 되돌린 값(기하평균)에 가깝다. 이 값은 원래 단위의 평균보다 작거나 같고, 중앙값과는 같을 수도 다를 수도 있다. 지표가 원래 단위의 RMSE라면 이 변환이 정말 나은지 위처럼 원래 단위로 재서 확인한다.
잠깐 확인 (ch09-i05)
아래 코드의 출력은?
import numpy as np
a, b = 2000.0, 0.5
print(round(np.log(a * b), 3), round(np.log(a) + np.log(b), 3), np.exp(np.log(1000.0)).round())
6.908 7.601 1000.0
6.908 6.908 1000.0
1000.0 6.908 6.908
6.908 6.908 6.908
날짜와 비율로 특성 만들기
섹션 제목: “날짜와 비율로 특성 만들기”특성 공학(feature engineering)은 모델이 쓰기 쉬운 모양으로 특성을 만드는 일이다. 이 데이터에서 가격을 정하는 것은 연식이 아니라 공고 시점의 차령이다. 주행거리도 총량보다 한 해 동안 얼마나 탔는지가 중요하다. 둘 다 원래 열에는 없다.
- 차령 = 공고 연도 − 연식(+0.5, 연중 어느 때 샀는지 모르므로 평균 반년). 문자열 날짜를
pd.to_datetime으로 바꿔 연도를 뽑는다. - 연간주행 = 주행거리 ÷ 차령. 나눗셈·곱셈 같은 특성 사이의 관계는 선형 모델이 스스로 만들지 못한다(06장).
이 함수를 파이프라인 안에 넣으려면 FunctionTransformer로 감싼다. 저장한 모델을 다른 곳에서 불러오려면 같은 함수를 import할 수 있어야 하므로(9-8절), 함수는 노트북 셀이 아니라 .py 파일에 둔다. 아래 코드는 car_features.py를 만든다. 편집기로 같은 내용의 파일을 만들어도 된다.
from pathlib import Path
Path("car_features.py").write_text('''import pandas as pd

def add_features(df):    """공고일·연식·주행거리로 차령과 한 해 주행거리를 만든다. 입력 표는 바꾸지 않는다."""    out = df.copy()    year = pd.to_datetime(out["공고일"]).dt.year    out["차령"] = (year - out["연식"]).clip(lower=0) + 0.5    out["연간주행"] = out["주행거리"] / out["차령"]    return out''', encoding="utf-8")
from car_features import add_featuresprint(add_features(X_dev.head(3))[["공고일", "연식", "차령", "주행거리", "연간주행"]].round({"연간주행": 0}).to_string()) 공고일 연식 차령 주행거리 연간주행2370 2025-11-19 2020 5.5 53100.0 9655.01774 2024-02-19 2022 2.5 8900.0 3560.0731 2024-10-13 2022 2.5 40400.0 16160.0df.copy()로 입력 표를 바꾸지 않는다. 바꾸면 그 표를 쓰는 다른 코드가 영향을 받고, 변환에 따라서는 같은 표로 다시fit할 때 결과가 달라질 수도 있다.- 주행거리가 결측이면 연간주행도 결측이다. 뒤의
SimpleImputer가 채운다. 특성 만들기를 결측 채우기보다 앞에 두었기 때문이다. 단계 순서가 결과를 바꾼다. - 이 함수는 행 하나씩 계산하고 데이터 전체의 통계(평균 등)를 쓰지 않는다. 그래서
fit할 것이 없고 누수도 없다. 전체 통계를 쓰는 특성(예: 같은 제조사 평균 주행거리)은 훈련 부분으로만 계산해야 하므로fit이 있는 변환기로 만들어야 한다. 정답을 모으는 특성(예: 같은 제조사 평균 가격)은 더 조심한다. 훈련 부분으로만 계산해도 각 훈련 행 자신의 가격이 그 행의 특성에 들어가므로, 훈련 데이터를 다시 나눠 자기 정답이 빠진 평균을 쓴다(교차 적합). sklearnTargetEncoder는fit_transform에서 이것을 해 준다.
from sklearn.preprocessing import FunctionTransformer
fe_cols = ["차령", "주행거리", "연간주행", "사고횟수"]ridge_fe_log = log_target(Pipeline([("fe", FunctionTransformer(add_features)), ("prep", linear_prep(fe_cols)), ("model", Ridge())]))s = cv_rmse(ridge_fe_log)print(f"Ridge + 로그 + 특성 RMSE {s.mean():6.1f} ± {s.std(ddof=1):5.1f}")Ridge + 로그 + 특성 RMSE 370.7 ± 41.0- 연식 대신 차령을, 주행거리와 함께 연간주행을 넣었다. RMSE가 조금 더 준다.
트리 모델과 범주 열
섹션 제목: “트리 모델과 범주 열”07장대로 HistGradientBoosting을 쓴다. 트리는 표준화가 필요 없고 결측을 그대로 받는다. 범주 열은 원-핫 대신 정수로 바꾸고, categorical_features로 “이 열은 범주”라고 알려 주면 범주 묶음으로 나누는 분할을 쓴다. 정수의 크기 순서를 쓰지 않는다.
from sklearn.preprocessing import OrdinalEncoderfrom sklearn.ensemble import HistGradientBoostingRegressor
def tree_prep(num_cols):    return ColumnTransformer([        ("num", "passthrough", num_cols),        ("cat", OrdinalEncoder(handle_unknown="use_encoded_value", unknown_value=np.nan), cat_cols),    ], verbose_feature_names_out=False).set_output(transform="pandas")   # 열 이름을 유지한 DataFrame으로
def hgb_model(num_cols, fe=False):    steps = [("fe", FunctionTransformer(add_features))] if fe else []    steps += [("prep", tree_prep(num_cols)),              ("model", HistGradientBoostingRegressor(categorical_features=cat_cols, random_state=0))]    return log_target(Pipeline(steps))
tp = tree_prep(fe_cols).fit(add_features(X_dev))print(tp.transform(add_features(test.iloc[[0, 5]])).round({"연간주행": 0}).to_string()) 차령 주행거리 연간주행 사고횟수 제조사 차종 연료0 11.5 130800.0 11374.0 1 10.0 2.0 1.05 12.5 166700.0 13336.0 1 NaN 1.0 1.0OrdinalEncoder는 범주를 0, 1, 2, …로 바꾼다. 처음 보는 포르쉐는unknown_value=np.nan으로 결측이 되고, HistGradientBoosting은 결측을 따로 다룬다. 연료의 결측도 그대로 NaN으로 남는다.set_output(transform="pandas")로 열 이름을 유지해야categorical_features=cat_cols처럼 이름으로 범주 열을 지정할 수 있다. 열 순서가 바뀌어도 이름으로 찾는다.- 범주가 255종을 넘으면 이 방식을 쓸 수 없다(HistGradientBoosting의 제한). 그때는 드문 범주를 묶거나(03장) 다른 인코딩을 쓴다.
같은 조각으로 비교
섹션 제목: “같은 조각으로 비교”지금까지의 모델을 한 표에 모은다. 모두 같은 cv 조각으로 잰다.
models = {"평균만 예측": DummyRegressor(), "Ridge": ridge, "Ridge+로그": ridge_log, "Ridge+로그+특성": ridge_fe_log, "HGB+로그": hgb_model(num_cols), "HGB+로그+특성": hgb_model(fe_cols, fe=True)}scores = {name: cv_rmse(model) for name, model in models.items()}print("모델 평균 표준편차")for name, s in scores.items(): print(f"{name:13s} {s.mean():7.1f} {s.std(ddof=1):7.1f}")print("조각별 (HGB+로그) − (HGB+로그+특성):", (scores["HGB+로그"] - scores["HGB+로그+특성"]).round(1))모델 평균 표준편차평균만 예측 957.2 69.6Ridge 492.7 42.7Ridge+로그 388.4 52.2Ridge+로그+특성 370.7 41.0HGB+로그 297.6 19.4HGB+로그+특성 276.9 15.9조각별 (HGB+로그) − (HGB+로그+특성): [ 26.4 -10.3 49.2 19.8 18.2]- 수입차·전기차는 값이 더 빨리 빠진다. “제조사에 따라 차령의 효과가 다르다”는 상호작용이라 Ridge는 표현하지 못하고, 트리는 질문을 이어 붙여 잡는다(07장). 그래서 HGB가 Ridge보다 크게 낫다.
- 특성 공학은 트리에도 효과가 있다. 트리는 나눗셈을 계단으로 흉내 낼 수 있지만, 연간주행을 직접 주면 질문 하나로 끝난다.
- 개선 폭이 조각 간 표준편차와 비슷하거나 작으면 운일 수 있다. 같은 조각으로 쟀으므로 조각별 차이를 본다. 특성을 넣은 쪽이 다섯 조각 중 넷에서 나았고 한 조각에서는 10 정도 나빴다. 평균 차이(약 21)가 조각 간 표준편차(16~19)와 비슷해 이 표만으로 확실하다고 하기는 어렵다. 이 데이터는 규칙을 알고 있어 두 특성이 실제로 쓸모 있음을 알지만, 실제 문제에서는 반복 교차검증(
RepeatedKFold)으로 조각 수를 늘리거나 홀드아웃에서 함께 확인한다. 특성이 업무상 말이 되는지(차령은 가격을 정하는 요인인가)도 판단 근거다. - 개선 순서를 정리하면: 기준선(평균) → 선형 → 목표 변환 → 특성 → 모델 교체. 모델을 바꾸기 전에 데이터 모양(로그, 특성)을 고치는 쪽이 싸고 효과가 클 때가 많다.
잠깐 확인 (ch09-i06)
파이프라인에서 특성 만들기(fe)가 결측 채우기(prep의 SimpleImputer)보다 앞에 있다. 주행거리가 결측인 차의 연간주행은 어떻게 처리되는가?
fe에서 결측으로 계산되고, 뒤의SimpleImputer가 연간주행 열의 중앙값으로 채운다fe가 주행거리를 먼저 중앙값으로 채운 뒤 연간주행을 계산한다결측이 있는 행은 파이프라인이 학습과 예측에서 자동으로 지운다
결측을 0으로 보고 계산해 연간주행이 0이 된다
9-6. 하이퍼파라미터 탐색
섹션 제목: “9-6. 하이퍼파라미터 탐색”GridSearchCV와 이름 규칙
섹션 제목: “GridSearchCV와 이름 규칙”하이퍼파라미터(hyperparameter)는 학습 전에 사람이 정하는 값이다(트리 수, 학습률, C, alpha, k). 06~08장에서는 후보마다 cross_val_score를 for 문으로 돌렸다. GridSearchCV는 후보의 모든 조합을 교차검증하고, 가장 좋은 조합으로 개발 데이터 전체에 다시 학습(refit=True, 기본값)까지 해 준다.
파이프라인 안의 인자는 단계이름__인자(밑줄 두 개)로 부른다. TransformedTargetRegressor 안의 파이프라인은 regressor, 그 안의 모델 단계는 model이므로 학습률은 regressor__model__learning_rate다. 이름이 헷갈리면 get_params()의 키를 본다.
from sklearn.model_selection import GridSearchCV
best_base = hgb_model(fe_cols, fe=True)print([k for k in best_base.get_params() if k.endswith(("learning_rate", "max_leaf_nodes"))])grid = {"regressor__model__learning_rate": [0.05, 0.1, 0.2], "regressor__model__max_leaf_nodes": [7, 15, 31]}search = GridSearchCV(best_base, grid, cv=cv, scoring="neg_root_mean_squared_error").fit(X_dev, y_dev)print("고른 값", search.best_params_, "/ 교차검증 RMSE", round(-search.best_score_, 1))r = pd.DataFrame(search.cv_results_)print((-r.pivot_table(index="param_regressor__model__learning_rate", columns="param_regressor__model__max_leaf_nodes", values="mean_test_score")).round(1))['regressor__model__learning_rate', 'regressor__model__max_leaf_nodes']고른 값 {'regressor__model__learning_rate': 0.2, 'regressor__model__max_leaf_nodes': 7} / 교차검증 RMSE 267.5param_regressor__model__max_leaf_nodes 7 15 31param_regressor__model__learning_rate0.05 324.6 286.3 282.40.10 276.0 269.3 276.90.20 267.5 272.3 280.9← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
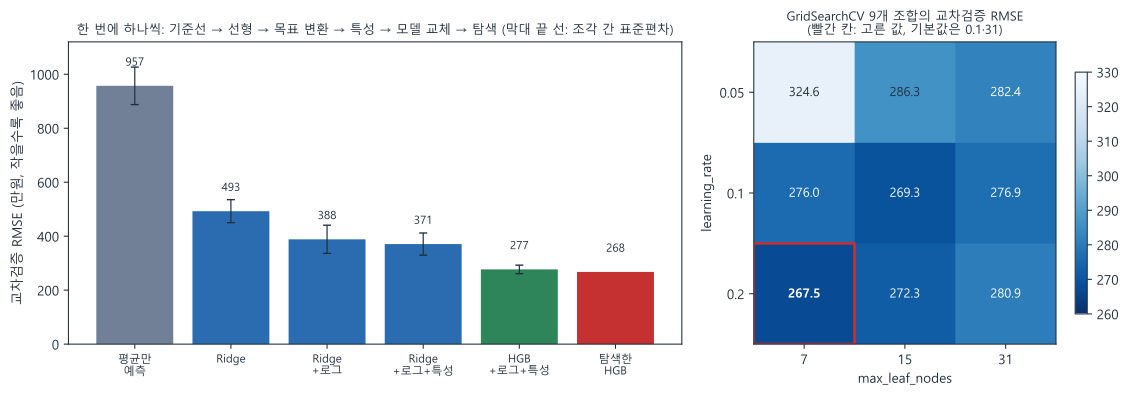
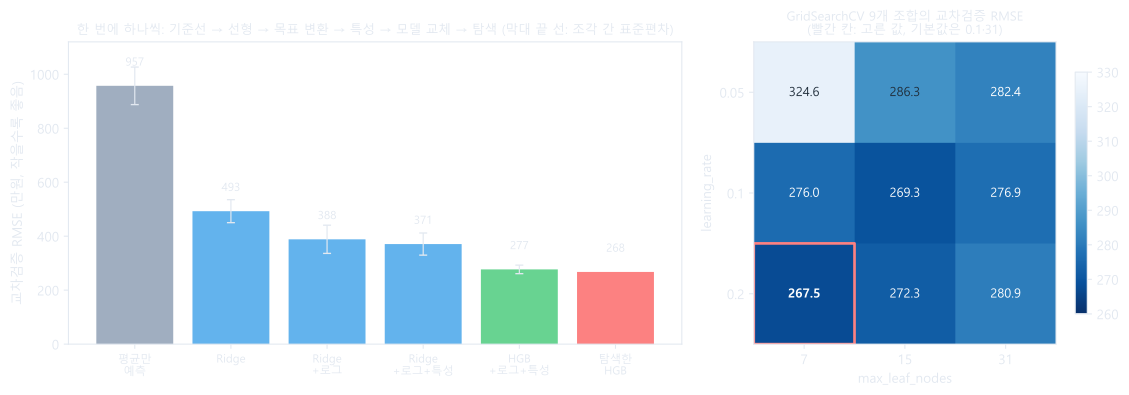
그림 설명. 왼쪽 막대그래프는 같은 조각으로 잰 교차검증 RMSE(만원, 세로 0~1120)다. 한 번에 하나씩 바꾼 순서로 평균만 예측 957, Ridge 493, Ridge+로그 388, Ridge+로그+특성 371, HGB+로그+특성 277, 탐색한 HGB 268로 줄어든다(특성 없는 HGB+로그 298은 특성의 효과를 보는 별도 비교라 그림에서 뺐다). 막대 끝의 선은 조각 간 표준편차이고(탐색한 HGB는 없다), 색은 회색(기준선), 파랑(Ridge 계열), 초록(HGB 계열), 빨강(탐색)이다. 오른쪽은 GridSearchCV 9개 조합의 교차검증 RMSE 표로, 세로가 learning_rate(0.05·0.1·0.2), 가로가 max_leaf_nodes(7·15·31)다. 값이 작을수록 진한 파랑이다. 0.05·7이 324.6으로 가장 크고, 0.2·7이 267.5로 가장 작아 빨간 테두리로 표시했다. 기본값 0.1·31은 276.9다.
- 3 × 3 = 9개 조합 × 5조각 = 45번 학습하고, 마지막에 고른 조합으로 한 번 더 학습한다. 조합 수는 인자마다 후보 수를 곱한 값이라, 탐색할 인자를 하나 더하면 그 후보 수만큼 곱으로 는다.
cv_results_에는 조합마다 조각별 점수, 평균, 표준편차, 순위, 학습 시간이 있다. 표로 펼쳐 보면 경향이 보인다. 학습률이 작은데 트리가 작으면(0.05, 7) 기본 트리 수 100개로는 덜 배운다(07장: 학습률과 트리 수는 함께 움직인다). 고른 값이 후보의 끝(여기서는 학습률 0.2)에 있으면 그 바깥도 시험해 본다.- 가장 좋은 조합과 기본값(0.1, 31)의 차이는 10 정도로, 9-5절 표의 조각 간 표준편차(16 정도)보다 작다. 이 예제에서는 탐색의 이득이 목표 변환(약 100)·특성 공학(약 20)보다 작았다. 데이터마다 다르지만, 탐색은 시간이 곱으로 들고 데이터 모양이 바뀌면 다시 해야 하므로 작업 순서상 마지막에 한다.
잠깐 확인 (ch09-i07)
TransformedTargetRegressor가 감싼 Pipeline의 model 단계(HistGradientBoostingRegressor)의 max_leaf_nodes를 GridSearchCV로 탐색할 때 쓰는 인자 이름은 ____이다.
답: ________________
탐색 방법 고르기
섹션 제목: “탐색 방법 고르기”| 상황 | 방법 | 이유 |
|---|---|---|
| 인자 1~2개, 후보가 적다 | GridSearchCV |
모든 조합을 본다. 결과 표를 읽기 쉽다 |
| 인자가 여럿이거나 범위가 넓다 | RandomizedSearchCV(n_iter=…) |
정해진 횟수만 무작위로 뽑는다. 중요한 인자 몇 개에 대해서는 같은 시간에 더 많은 값을 본다 |
| 선형 모델의 정규화 강도 하나 | LogisticRegressionCV·RidgeCV(06장) |
탐색이 내장돼 빠르다 |
LogisticRegressionCV(Cs=…, cv=…)·RidgeCV(alphas=…)는C·alpha하나만 빠르게 고른다. 파이프라인 끝에 넣으면 앞 단계 전처리는 그 내부 교차검증 밖에서 한 번 맞춰지고, 점수도 모델이 받은 값(여기서는 로그 가격) 기준이다. 전처리까지 조각마다 다시 맞추고 원래 단위의 지표로 고르려면 이 장처럼 파이프라인 전체를GridSearchCV로 탐색한다.- 크기가 10배 단위로 효과를 바꾸는 인자(
C,alpha, 학습률)는np.logspace처럼 로그 간격으로 후보를 둔다(06장).
탐색 점수는 낙관적이다
섹션 제목: “탐색 점수는 낙관적이다”best_score_는 9개 중 가장 좋았던 점수다. 같은 조각에서 여러 번 골랐으므로 새 데이터에서는 대개 이보다 나쁘다(05장: 고르는 데 쓴 점수는 낙관적이다). 그래서 다 고른 뒤 홀드아웃에서 한 번 확인한다.
from sklearn.metrics import root_mean_squared_error
for name, model in [("Ridge(기준선)", ridge.fit(X_dev, y_dev)), ("HGB+로그+특성(기본값)", hgb_model(fe_cols, fe=True).fit(X_dev, y_dev)), ("탐색으로 고른 HGB", search)]: print(f"{name:16s} 홀드아웃 RMSE {root_mean_squared_error(y_hold, model.predict(X_hold)):6.1f}")Ridge(기준선) 홀드아웃 RMSE 566.0HGB+로그+특성(기본값) 홀드아웃 RMSE 316.5탐색으로 고른 HGB 홀드아웃 RMSE 309.1- 이번 분할에서는 세 모델 모두 홀드아웃 RMSE가 교차검증보다 컸다. 평가하는 표본이 다르고(600건 한 묶음 대 480건씩 다섯 묶음), 학습 데이터 양도 다르고(2400건 대 1920건), 탐색한 모델은 고른 점수의 낙관성도 있어 이 출력만으로 원인을 하나로 가를 수 없다. 좋은 순서(기준선 < 기본 HGB < 탐색한 HGB)는 교차검증과 같다. 순서가 뒤집혔다면 탐색이 조각에 과적합했거나 홀드아웃 분포가 다를 가능성을 의심하고 더 확인한다. 600건 하나로는 확정하지 않는다.
search자체가 고른 조합으로 다시 학습한 모델이라predict를 바로 쓸 수 있다.- 홀드아웃 점수를 보고 다시 탐색 후보를 바꾸기 시작하면, 홀드아웃도 “고르는 데 쓴 점수”가 된다. 그래서 한 번만 본다.
잠깐 확인 (ch09-i08)
GridSearchCV의 best_score_(−267.5, 부호를 바꾸면 교차검증 RMSE 267.5)를 보고서에 "새 데이터에서 예상되는 RMSE"로 적으려 한다. 알맞은 판단은?
교차검증 평균이므로 새 데이터 점수로 그대로 믿어도 된다
best_score_는 홀드아웃에서 잰 점수라 그대로 쓴다9개 후보 중 가장 좋았던 점수라 낙관적이므로, 홀드아웃에서 한 번 따로 확인한다
홀드아웃 점수가 나쁘면 후보를 바꿔 다시 탐색하고 홀드아웃을 다시 본다
9-7. 제출
섹션 제목: “9-7. 제출”전체로 다시 학습하고 양식에 맞춘다
섹션 제목: “전체로 다시 학습하고 양식에 맞춘다”고른 설정으로 정답이 있는 3000건 전체에 다시 학습한다. 데이터가 많을수록 대개 낫고, 설정은 이미 정했으니 더 나눌 이유가 없다. clone은 같은 설정의 학습 전 모델을 만든다.
from sklearn.base import clone
final = clone(search.best_estimator_).fit(X, y) # 개발 + 홀드아웃 전체로 다시 학습pred = final.predict(test) # 열 이름으로 고르므로 id 열은 쓰이지 않는다sub = pd.DataFrame({"id": test["id"], "가격": pred.round()}) # id와 예측을 같은 표에서 짝짓는다sub = sample[["id"]].merge(sub, on="id", how="left", validate="one_to_one") # 양식의 id 순서로print(sub.head(3).to_string(), "\n행", len(sub), "/ 빈 예측", sub["가격"].isna().sum(), "/ 최솟값", sub["가격"].min()) id 가격0 3001 874.01 3002 736.02 3003 929.0행 1000 / 빈 예측 0 / 최솟값 280.0- 핵심은 id와 예측을 같은 표에서 짝짓는 것이다.
test["id"]와final.predict(test)는 같은test에서 나왔으므로 행이 맞는다. 그다음 양식의 id 순서로merge한다.validate="one_to_one"은 id가 한쪽이라도 중복이면 오류를 낸다(03장). - 로그를 되돌린 예측이라 음수 가격이 나오지 않는다. 회귀 예측에 음수·비현실적인 값이 없는지도 본다.
잠깐 확인 (ch09-i09)
테스트 표 test(id 포함)와 학습한 파이프라인 final로 제출 파일을 만든다. 행이 어긋나지 않는 방법은?
둘러보려고 제조사순으로 정렬해 둔 표로 예측한 배열을 양식의 가격 열에 붙인다
결측이 있는 행을
dropna로 지운 표로 예측해 양식에 붙인다예측을 크기순으로 정렬한 뒤 양식의 id 순서대로 붙인다
test["id"]와final.predict(test)를 같은 표로 묶고, 양식의 id 순서로merge한다
행 대응 점검
섹션 제목: “행 대응 점검”제출 전에 양식과 비교하는 함수를 하나 만들어 둔다.
def check_submission(sub, sample):    problems = []    if list(sub.columns) != list(sample.columns):        problems.append(f"열 이름 {list(sub.columns)}")    if len(sub) != len(sample):        problems.append(f"행 수 {len(sub)} ≠ {len(sample)}")    elif not np.array_equal(sub["id"].to_numpy(), sample["id"].to_numpy()):        problems.append("id 순서가 양식과 다르다")    if sub["id"].duplicated().any():        problems.append("중복 id")    if sub[sample.columns[1]].isna().any():        problems.append("빈 예측")    return problems or ["문제 없음"]
print("제출:", check_submission(sub, sample))by_maker = test.sort_values("제조사") # 둘러보다 정렬해 둔 표wrong = sample.copy()wrong["가격"] = final.predict(by_maker).round() # 정렬된 순서의 예측을 양식에 그대로 붙임print("정렬된 예측을 양식에 붙임:", check_submission(wrong, sample), "/ 예측값이 같은 행", (wrong["가격"] == sub["가격"]).sum(), "개 / 제자리인 차", (by_maker["id"].to_numpy() == test["id"].to_numpy()).sum(), "대")print("dropna한 표로 예측:", check_submission(pd.DataFrame({"id": test.dropna()["id"], "가격": 1.0}), sample))제출: ['문제 없음']정렬된 예측을 양식에 붙임: ['문제 없음'] / 예측값이 같은 행 3 개 / 제자리인 차 2 대dropna한 표로 예측: ['행 수 855 ≠ 1000']- 두 번째 경우가 가장 위험하다. 양식을 복사해 예측 열만 바꿨으므로 id·행 수·열 이름이 모두 맞아 점검을 통과한다. 그런데 예측은 제조사순으로 정렬된 차의 것이라 1000행 중 제자리인 차는 2대뿐이다(예측값이 우연히 같은 행까지 세도 3개). 점검 함수는 형식만 본다. 행 대응은 “id와 예측을 같은 표에서 짝짓고 id로 맞춘다”는 만드는 방법으로 지킨다.
- 결측이 있는 행을 지우면(
dropna) 그 행은 제출에서 빠진다. 결측은 파이프라인이 채우게 두고, 테스트 행은 절대 지우지 않는다. - 파일로 쓴 뒤에는
pd.read_csv로 다시 읽어 같은 점검을 한 번 더 한다(인덱스 열이 끼어들지 않게to_csv(index=False)).
잠깐 확인 (ch09-i10)
제출 점검 함수가 열 이름·행 수·id 순서·중복·빈 예측을 모두 확인해 "문제 없음"을 냈다면, 예측이 각 id의 차에 바르게 붙었다고 확신할 수 있다.
O / X
9-8. 저장·재로딩·재현
섹션 제목: “9-8. 저장·재로딩·재현”joblib으로 저장
섹션 제목: “joblib으로 저장”joblib은 sklearn과 함께 설치되는 저장 도구다. 파이프라인을 통째로 저장하면 전처리와 모델이 함께 저장된다. 이 장의 최종 모델에는 범주 인코딩 목록, 특성 함수 참조, 학습된 트리, 로그 되돌리기가 들어 있다(결측을 중앙값으로 채우는 단계가 있으면 그 중앙값도 들어간다). 학습에 쓴 열 목록과 sklearn 버전도 함께 넣어 둔다.
import joblib, sklearn
bundle = {"model": final, "columns": list(X.columns), "sklearn": sklearn.__version__}joblib.dump(bundle, "car_price.joblib")loaded = joblib.load("car_price.joblib")print("버전 같음:", loaded["sklearn"] == sklearn.__version__, "/ 같은 예측:", np.array_equal(loaded["model"].predict(test[loaded["columns"]]), pred))버전 같음: True / 같은 예측: Truenp.allclose가 아니라np.array_equal(허용 오차 없이 원소 값이 같은지)로 비교했다. 같은 환경에서 저장·재로딩은 예측을 조금도 바꾸지 않아야 한다.
새 프로세스에서 불러오기
섹션 제목: “새 프로세스에서 불러오기”같은 노트북 안의 재로딩은 메모리에 남은 함수·변수 덕분에 될 수도 있다. 진짜 확인은 새 프로세스에서 한다. 제출용 스크립트 predict.py를 만들어 별도 파이썬으로 실행한다(터미널에서 python predict.py를 친 것과 같다).
import subprocess, sys
test.to_csv("test.csv", index=False)np.save("pred.npy", pred)Path("predict.py").write_text('''import joblib, numpy as np, pandas as pd, sklearnbundle = joblib.load("car_price.joblib")assert bundle["sklearn"] == sklearn.__version__, "학습 때와 sklearn 버전이 다르다"test = pd.read_csv("test.csv")pred = bundle["model"].predict(test[bundle["columns"]])print("새 프로세스에서 같은 예측:", np.array_equal(pred, np.load("pred.npy")))''', encoding="utf-8")run = subprocess.run([sys.executable, "-X", "utf8", "predict.py"], capture_output=True, text=True, encoding="utf-8")print(run.stdout.strip() or run.stderr[-500:])새 프로세스에서 같은 예측: True- CSV로 저장했다 읽은 테스트 표로도 같은 예측이 나온다.
-X utf8은 Windows에서 한글 출력이 깨지지 않게 하는 옵션이다. car_features.py가 없는 폴더에서 불러왔을 때의 결과를 확인한다.
import shutil, tempfile
elsewhere = tempfile.mkdtemp() # car_features.py가 없는 폴더shutil.copy("car_price.joblib", elsewhere)run = subprocess.run([sys.executable, "-X", "utf8", "-c", "import joblib; joblib.load('car_price.joblib')"], capture_output=True, text=True, encoding="utf-8", cwd=elsewhere)print(run.stderr.strip().splitlines()[-1])ModuleNotFoundError: No module named 'car_features'- joblib(내부는 파이썬
pickle)은 함수를 코드째 저장하지 않고 “car_features 모듈의 add_features”라는 이름만 저장한다. 불러오는 쪽에서 그 이름을 import할 수 있어야 한다. 그래서 9-5절에서 함수를.py파일에 두었다. 노트북 셀에서 정의한 함수는__main__소속으로 저장돼, 그 함수를 다시 정의하지 않은 새 프로세스에서는 불러오지 못한다.lambda는 저장 자체가 안 된다. - 모델 파일을 넘길 때는
.joblib+ 사용자 함수.py+ 버전 목록(requirements.txt)을 함께 넘긴다.
잠깐 확인 (ch09-i11)
car_features.py가 없는 폴더에서 저장한 파이프라인을 joblib.load했더니 ModuleNotFoundError: No module named 'car_features'가 났다. 이유는?
joblib 파일이 복사 중에 손상되었기 때문이다
joblib은 함수를 코드째 저장하지 않고, 어느 모듈의 어떤 함수인지 이름만 저장하기 때문이다
불러오는 쪽 sklearn 버전이 달라서 모듈 이름이 바뀌었기 때문이다
FunctionTransformer가 들어간 파이프라인은 처음부터 저장되지 않기 때문이다
같은 예측이 나오는 조건
섹션 제목: “같은 예측이 나오는 조건”again = clone(final).fit(X, y).predict(test)print("같은 설정으로 다시 학습:", np.array_equal(again, pred))Xf, ylog = add_features(X)[fe_cols], np.log(y)for rs in [0, 0, 1, 2]: m = HistGradientBoostingRegressor(early_stopping=True, random_state=rs).fit(Xf, ylog) print(f"조기 종료, random_state={rs}: 트리 {m.n_iter_}개")같은 설정으로 다시 학습: True조기 종료, random_state=0: 트리 34개조기 종료, random_state=0: 트리 34개조기 종료, random_state=1: 트리 30개조기 종료, random_state=2: 트리 37개- 같은 데이터·같은 설정·같은
random_state로 다시 학습하면 같은 예측이 나온다. 조기 종료(07장)는 훈련 데이터의 일부를 무작위로 떼어 멈출 시점을 정하므로,random_state가 다르면 떼는 표본이 달라져 트리 수가 달라진다.random_state=None(기본값)이면 실행할 때마다 다른 난수를 쓰므로 같은 코드를 다시 돌려도 결과가 바뀔 수 있다. 무작위가 들어가는 곳(분할, 교차검증 섞기, 부트스트랩, 조기 종료)에는 모두random_state를 고정한다. - 버전이 다르면 같은 코드도 결과가 달라질 수 있다. sklearn은 다른 버전에서 저장한 모델을 불러오면
InconsistentVersionWarning을 내고, 동작을 보장하지 않는다. 학습·예측 환경의 버전을requirements.txt로 고정한다(00장). - 보안:
joblib.load·pickle.load는 파일 안의 코드를 실행할 수 있다. 출처를 믿을 수 없는 모델 파일은 열지 않는다. 공유가 필요하면 sklearn 문서가 소개하는skops.io나 ONNX 같은 형식을 검토한다. - 같은 환경이어도 다른 CPU·스레드 수에서 소수점 끝자리가 달라질 수 있다. 그때는
np.allclose로 비교하고, 차이가 제출 점수에 영향이 없는 수준인지 본다.
잠깐 확인 (ch09-i12)
joblib.load는 저장된 숫자만 읽어 들이므로, 인터넷에서 받은 출처 모를 모델 파일을 열어도 안전하다.
O / X
9-9. 선택 기준표에 추가
섹션 제목: “9-9. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 열마다 전처리가 다른 표 데이터 | ColumnTransformer(숫자: 채우기·표준화, 범주: 채우기·원-핫/정수) + 모델을 Pipeline 하나로 |
교차검증·예측·저장에 같은 규칙이 저절로 적용된다 | 09 |
| 문제를 처음 받았다 | 평균(또는 최빈값) 예측 → 선형 모델 기준선 → 제출 파일까지 먼저 | 개선의 비교 기준과 0점 방지 제출이 생긴다 | 09 |
| 정답이 양수이고 오른쪽으로 길게 치우친 회귀(가격·소득) | TransformedTargetRegressor(func=np.log, inverse_func=np.exp), 점수는 원래 단위로 |
곱으로 얽힌 관계가 더하기가 되고, 큰 값 몇 개에 끌려가지 않는다 | 09 |
| 날짜·비율 같은 특성을 만든다 | 행 단위 함수는 .py 모듈 + FunctionTransformer로 파이프라인 안에, 전체 통계를 쓰는 특성은 fit이 있는 변환기로 |
훈련·예측 규칙이 같아지고 저장 모델을 다른 곳에서 불러올 수 있다 | 09 |
| 하이퍼파라미터를 고른다 | 마지막 단계에서 GridSearchCV(인자가 많으면 RandomizedSearchCV), 단계__인자 이름, 홀드아웃 한 번 확인 |
탐색 점수는 낙관적이고, 시간이 곱으로 들며 데이터 모양이 바뀌면 다시 해야 한다 | 09 |
| 제출 파일을 만든다 | id와 예측을 같은 표에서 짝짓고 양식 id로 merge, 점검 함수 + 다시 읽어 확인, 테스트 행은 지우지 않는다 |
정렬·삭제로 어긋난 행은 오류 없이 점수를 망친다 | 09 |
| 모델을 저장해 다른 곳에서 쓴다 | joblib으로 파이프라인 통째 + 열 목록·버전, 새 프로세스에서 같은 예측 확인, random_state 고정 |
전처리를 빠뜨리지 않고, 버전·무작위성 차이를 잡는다. 믿을 수 없는 파일은 열지 않는다 | 09 |
9-10. 1·2부 선택 기준표 정리
섹션 제목: “9-10. 1·2부 선택 기준표 정리”01~09장의 기준표를 표 데이터 작업 순서로 다시 묶는다. 각 줄의 자세한 이유는 장 열의 장에 있다. 19장에서 3·4부와 합쳐 데이터 종류·양·라벨·설명 필요성·지연·비용 기준으로 다시 정리한다.
| 단계 | 판단 | 기본 선택 | 장 |
|---|---|---|---|
| 방법 | 규칙이 법·정책으로 정해져 있나, 정답 달린 예시가 있나 | 정해진 규칙은 규칙 기반, 정답 달린 예시가 있으면 지도 학습, 정답이 없으면 비지도(아래 ‘정답 없음’). 꼭 지킬 조건은 규칙 + 모델 | 01 |
| 데이터 모양 | 모델이 받는 모양인가 | (표본, 특성) 숫자 배열, 계산은 벡터화 |
02 |
| 데이터 확인 | 결측·범주·중복 키·목표 분포 | 숫자 결측은 훈련 중앙값 + 결측 표시, 범주 결측은 최빈값 또는 별도 범주, 순서 없는 범주는 원-핫(ignore), ID는 뺀다, 합칠 때 merge(validate=…) |
03·09 |
| 나누기 | 어떻게 채점할까 | 훈련·검증(교차검증)·테스트, 분류는 층화, 테스트는 마지막 한 번 | 05 |
| 지표 | 무엇이 비싼 실수인가 | 불균형이면 정확도 대신 재현율·정밀도·F1·AUC, 회귀는 RMSE·MAE. 임계값은 목적에 맞게 | 05 |
| 전처리 | fit하는 단계가 있나 |
모두 파이프라인 안에서 훈련 부분으로만 fit |
05·09 |
| 기준선 | 무엇과 비교할까 | 평균·최빈값 예측 → 선형(회귀: LinearRegression·Ridge, 분류: 표준화 + LogisticRegression) |
04·06·09 |
| 개선 | 무엇부터 바꿀까 | 목표 변환·특성 공학 → 트리 앙상블(랜덤 포레스트, HistGradientBoosting + 조기 종료) | 06·07·09 |
| 선형 모델 | 정규화·스케일 | 표준화 후 C·alpha를 로그 간격으로 교차검증, 쓸모 있는 특성이 일부면 L1 |
06 |
| 거리 모델 | kNN·k-평균·PCA를 쓰나 | 표준화, k·성분 수는 교차검증·설명된 분산으로 |
08 |
| 정답 없음 | 묶기·줄이기·찾기 | k-평균(n_init), PCA, 정규화 + 코사인 검색. 결과는 사람이 해석 |
08 |
| 탐색 | 하이퍼파라미터 | 마지막에 GridSearchCV·RandomizedSearchCV, 홀드아웃 한 번 |
09 |
| 해석 | 무엇이 중요했나 | 검증 데이터 순열 중요도, 인과로 읽지 않는다 | 07 |
| 제출·저장 | 같은 규칙, 같은 행 | 전체로 다시 학습, id로 맞춘 제출 + 점검, 파이프라인 통째 저장 + 새 프로세스 확인 | 09 |
확인 문제
섹션 제목: “확인 문제”문제 1 (ch09-e01)
숫자 열 2개(채우기 + 표준화)와 범주 열 2개(채우기 + 원-핫)를 ColumnTransformer로 바꾸고 나머지 열은 버린다. 원-핫은 범주를 빼지 않는 기본 설정이고, fit한 데이터에서 두 범주 열의 범주는 각각 3종, 4종이다. 출력 열 수는 ____개다.
답: ________________
문제 2 (ch09-e02)
ColumnTransformer를 개발 데이터 전체로 fit_transform한 배열을 만들고, 그 배열과 Ridge()로 cross_val_score를 돌렸다. 무엇이 문제인가?
배열은
cross_val_score가 받지 않아 오류가 난다검증 조각의 중앙값·평균·범주 목록이 전처리에 섞여 점수가 낙관적으로 나올 수 있다
전처리는 정답을 쓰지 않으므로 아무 문제가 없다
전처리를 한 번만 하므로 점수는 같고 계산만 빨라진다
문제 3 (ch09-e03)
TransformedTargetRegressor(func=np.log, inverse_func=np.exp)로 학습했다. 지표가 원래 단위(만원)의 RMSE라면, 변환한 모델이 나은지 원래 단위로 다시 재야 하는 이유는?
로그 공간 RMSE가 원래 단위 RMSE보다 대개 작게 나와 낙관적이기 때문이다
TransformedTargetRegressor는 원래 단위의 점수를 직접 계산하지 않기 때문이다로그를 되돌릴 때 반올림 오차가 커져 점수가 흔들리기 때문이다
로그 공간에서 가장 좋은 예측이 원래 단위 RMSE에서도 가장 좋다는 보장이 없기 때문이다
문제 4 (ch09-e04)
같은 5조각에서 (HGB+로그) − (HGB+로그+특성)의 조각별 RMSE 차이가 [26.4, −10.3, 49.2, 19.8, 18.2]이고 평균은 약 21이다. 두 모델 각각의 조각 간 RMSE 표준편차는 19.4와 15.9였다. 알맞은 해석은?
다섯 조각 모두에서 나아졌으므로 특성이 쓸모 있다고 결론 낸다
평균 차이가 흔들림과 비슷하니 조각을 늘리거나 홀드아웃으로 더 확인한다
평균 차이 21이 0보다 크므로 특성을 넣은 쪽이 낫다고 결론 낸다
한 조각에서 나빠졌으므로 특성을 빼고 원래 모델로 돌아간다
문제 5 (ch09-e05)
GridSearchCV가 고른 학습률이 후보 [0.05, 0.1, 0.2] 중 가장 큰 0.2라면, 0.2보다 큰 값도 후보에 넣어 다시 시험해 본다.
O / X
문제 6 (ch09-e06)
후보가 아래 grid이고 5겹 교차검증을 하는 GridSearchCV(refit=True)가 모델을 학습하는 횟수를 센다. 아래 코드의 출력은?
grid = {"a": [0.05, 0.1, 0.2], "b": [7, 15, 31], "c": [True, False]}
n = 1
for v in grid.values():
    n *= len(v)
print(n, n * 5 + 1)
18 91
8 41
18 90
3 16
문제 7 (ch09-e07)
탐색과 홀드아웃 확인으로 설정을 다 정했다. 이 장에서 제출 모델을 만드는 방법은?
홀드아웃 600건만으로 다시 학습한다
테스트 예측을 정답처럼 붙여 훈련 데이터에 더한 뒤 다시 학습한다
clone(search.best_estimator_)를 정답이 있는 3000건 전체로 다시 학습한다탐색 후보를 늘려 홀드아웃 점수가 가장 좋은 설정으로 바꾼 뒤 학습한다
문제 8 (ch09-e08)
정렬해 둔 표로 예측한 배열을 원래 순서의 id에 붙인다(예측은 x의 10배라고 하자). 아래 코드의 출력은?
import pandas as pd
test = pd.DataFrame({"id": [11, 12, 13], "x": [3, 1, 2]})
pred = test.sort_values("x")["x"] * 10
sub = pd.DataFrame({"id": test["id"], "가격": pred.to_numpy()})
print(sub["가격"].tolist())
[10, 20, 30]
[30, 10, 20]
[20, 30, 10]
[30, 20, 10]
문제 9 (ch09-e09)
HistGradientBoostingRegressor(early_stopping=True)를 random_state를 주지 않고 같은 데이터로 두 번 학습했다. 어떻게 될 수 있는가?
조기 종료에는 무작위성이 없으므로 늘 같은 트리 수가 나온다
random_state는 데이터 분할에만 쓰이므로 이 모델에는 영향이 없다sklearn 버전이 같으면 언제나 같은 예측이 나온다
실행마다 멈출 시점을 정할 표본이 다르게 뽑혀 트리 수와 예측이 바뀔 수 있다
문제 10 (ch09-e10)
새 표 데이터 회귀 문제를 받았다. 1·2부 기준표의 작업 순서로 가장 알맞은 것은?
데이터 확인 → 트리 앙상블 탐색 → 홀드아웃을 보며 후보 조정 → 기준선 → 제출
기준선 → 탐색 → 목표 변환·특성 → 홀드아웃 여러 번 확인 → 제출
데이터 확인 → 나누기·지표 → 기준선·제출 → 목표 변환·특성 → 앙상블 → 탐색 → 홀드아웃 한 번
탐색 → 특성 → 데이터 확인 → 기준선 → 홀드아웃 한 번 → 제출
9-11. 실습과 문제
섹션 제목: “9-11. 실습과 문제”실습/문제/ch09_표_데이터_실전_파이프라인.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안팎에 끝난다. 다 푼 뒤 해설 노트북과 비교한다. 실습은 원고와 다른 가상 데이터(분류)로 같은 과정을 밟는다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 파이프라인·누수 참/거짓 |
| 2 | 코드 | 숫자·범주 열 전처리를 ColumnTransformer로 |
| 3 | 코드 | 날짜·비율 특성 함수 |
| 4 | 코드 | 같은 조각으로 기준선과 모델 비교 |
| 5 | 코드 | 파이프라인 안의 인자를 GridSearchCV로 탐색 |
| 6 | 코드 | id로 맞춘 제출 파일과 점검 |
| 7 | 코드 | 저장·재로딩 후 같은 예측 확인 |
| 8 | 개념 | 탐색·제출·저장 참/거짓 |
| 9 | 사례 | 검증보다 크게 낮은 제출 점수 |
| 10 | 사례 | 1·2부 상황별 선택 |
9-12. 공식 문서와 참고 자료
섹션 제목: “9-12. 공식 문서와 참고 자료”- 파이프라인과 복합 추정기(사용자 안내서,
Pipeline·ColumnTransformer·TransformedTargetRegressor): https://scikit-learn.org/stable/modules/compose.html ColumnTransformer: https://scikit-learn.org/stable/modules/generated/sklearn.compose.ColumnTransformer.htmlFunctionTransformer: https://scikit-learn.org/stable/modules/generated/sklearn.preprocessing.FunctionTransformer.html- 하이퍼파라미터 탐색(사용자 안내서): https://scikit-learn.org/stable/modules/grid_search.html
GridSearchCV: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.htmlRandomizedSearchCV: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.RandomizedSearchCV.html- HistGradientBoosting의 범주 특성 예제: https://scikit-learn.org/stable/auto_examples/ensemble/plot_gradient_boosting_categorical.html
- 목표 변환 예제: https://scikit-learn.org/stable/auto_examples/compose/plot_transformed_target.html
- 모델 저장(사용자 안내서, 보안·버전 주의): https://scikit-learn.org/stable/model_persistence.html
- 재현성과
random_state(사용자 안내서): https://scikit-learn.org/stable/common_pitfalls.html#controlling-randomness