07장의 트리는 ” 임계값인가?”라는 질문으로 데이터를 나눴다. 이 장은 다른 생각 하나에서 출발한다. 가까운 것은 비슷하다. 표본을 특성 공간의 점으로 보고 점 사이의 거리를 재면, 정답이 있을 때는 가까운 이웃의 정답을 빌려 예측하고(kNN), 정답이 없을 때는 가까운 점끼리 묶고(k-평균), 점들이 가장 넓게 퍼진 방향만 남겨 차원을 줄이고(PCA), 질문과 방향이 가장 비슷한 문서를 찾는다(코사인 유사도 검색). 마지막 것은 17장 임베딩 검색과 RAG의 바탕이다. 네 방법 모두 “거리를 어떻게 재느냐”에 결과가 달려 있으므로, 단위와 차원이 거리를 어떻게 바꾸는지를 먼저 본다.
8-1. 이 장의 목표와 완료 기준
섹션 제목: “8-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 거리를 잰다 | 유클리드·맨해튼 거리를 계산하고, 모든 쌍의 거리를 행렬곱으로 구해 sklearn과 맞춘다 |
| 단위의 영향을 안다 | 표준화 전후에 거리를 차지하는 특성이 어떻게 바뀌는지 말한다 |
| kNN을 쓴다 | kNN을 NumPy로 구현해 sklearn과 맞추고, 표준화와 k를 교차검증으로 고른다 |
| 차원의 저주를 말한다 | 차원이 커지면 가장 가까운 점과 가장 먼 점의 거리가 비슷해지는 것을 수치로 보인다 |
| k-평균을 쓴다 | 할당·평균 갱신을 직접 구현해 sklearn과 맞추고, n_init·inertia·실루엣 점수로 결과를 고른다 |
| k-평균의 한계를 안다 | 둥글지 않은 군집·단위 차이에서 실패하는 예를 들고, 군집이 정답이 아님을 말한다 |
| PCA를 쓴다 | 훈련 데이터에만 맞춘 PCA로 투영·복원하고, 설명된 분산 비율로 성분 수를 정하고, 2차원 그림을 읽는다 |
| 코사인 유사도로 검색한다 | 벡터를 정규화해 행렬곱 한 번으로 유사도를 구하고 상위 k개를 찾는다 |
| 선택 기준표에 줄을 더한다 | 거리 기반 방법을 언제 고르는지 적는다 |
| 실습 노트북 08을 끝낸다 | 실습/문제/ch08_거리와_비지도_학습.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
8-2. 왜 거리인가
섹션 제목: “8-2. 왜 거리인가”- 정답이 없어도 할 수 있는 일이 있다. 01장의 학습 방식 지도에서 정답(라벨) 없이 데이터의 구조를 찾는 것을 비지도 학습(unsupervised learning)이라 했다. 비슷한 고객끼리 묶기(군집, clustering), 특성 수백 개를 몇 개로 줄여 그림으로 보기(차원 축소, dimensionality reduction), 비슷한 문서·상품 찾기(검색)가 대표적이다. 셋 다 “비슷하다”를 숫자로 재는 거리나 유사도가 필요하다.
- 가장 단순한 예측 방법이다. kNN은 학습 단계에서 예측 함수를 따로 최적화하지 않고 훈련 데이터를 저장한다. 새 표본과 가장 가까운 훈련 표본 몇 개를 보고 다수결한다. 성능은 앙상블보다 낮을 때가 많지만, 거리가 의미 있는 특성 공간(15장의 사전학습 모델이 뽑은 특성, 17장의 문장 임베딩)에서는 강한 기준선이 된다.
- 거리가 결과를 정한다. 트리는 단위를 타지 않았지만(07장), 거리 기반 방법은 단위가 큰 특성 하나가 거리를 독차지하면 그 특성만 보는 모델이 된다. 그래서 06장의 표준화가 여기서 다시 필수다.
8-3. 거리와 단위
섹션 제목: “8-3. 거리와 단위”유클리드 거리와 맨해튼 거리
섹션 제목: “유클리드 거리와 맨해튼 거리”두 점 , 의 유클리드 거리(Euclidean distance)는 차이 벡터의 길이 , 02장의 L2 노름 이다. 맨해튼 거리(Manhattan distance)는 차이의 절댓값 합 , L1 노름이다. 바둑판 길을 따라 걷는 거리라 이렇게 부른다.
import numpy as npfrom sklearn.metrics import pairwise_distances
a = np.array([1.0, 2.0, 3.0])b = np.array([4.0, 0.0, 3.0])print("유클리드", np.linalg.norm(a - b), np.sqrt(np.sum((a - b) ** 2)))print("맨해튼 ", np.abs(a - b).sum(), pairwise_distances([a], [b], metric="manhattan")[0, 0])유클리드 3.605551275463989 3.605551275463989맨해튼 5.0 5.0- 유클리드 거리는 차이를 제곱하므로 한 특성에서 크게 다른 것을 더 무겁게 본다. 별말이 없으면 거리는 유클리드 거리를 뜻한다(sklearn 기본값도 같다).
단위가 거리를 바꾼다
섹션 제목: “단위가 거리를 바꾼다”sklearn의 와인 데이터(load_wine)는 와인 178병의 화학 성분 13개로 품종 3개를 구분한다. 특성마다 단위가 다르다.
from sklearn.datasets import load_winefrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScaler
wine = load_wine()Xw, yw = wine.data, wine.targetw_tr, w_va, yw_tr, yw_va = train_test_split(Xw, yw, test_size=0.3, stratify=yw, random_state=0)print(Xw.shape, "품종별 개수", np.bincount(yw))for j in [0, 7, 12]:    print(f"{wine.feature_names[j]:21s} 표준편차 {w_tr[:, j].std():8.2f}")
sc = StandardScaler().fit(w_tr) # 훈련 데이터에만 맞춘다(05장)z_tr = sc.transform(w_tr)d2_raw = (w_tr[0] - w_tr[1]) ** 2 # 특성별 차이²d2_std = (z_tr[0] - z_tr[1]) ** 2print("proline이 거리²에서 차지하는 비율: 원래", round(d2_raw[12] / d2_raw.sum(), 3), "/ 표준화 뒤", round(d2_std[12] / d2_std.sum(), 3))(178, 13) 품종별 개수 [59 71 48]alcohol 표준편차 0.82nonflavanoid_phenols 표준편차 0.12proline 표준편차 325.39proline이 거리²에서 차지하는 비율: 원래 0.997 / 표준화 뒤 0.132- proline(아미노산 함량)은 표준편차가 수백이고, nonflavanoid_phenols는 0.1 정도다. 표준화 전에는 두 와인의 거리²를 proline 하나가 99.7% 차지하고, 표준화 뒤에는 13% 정도로 다른 특성과 비슷해진다. 표준화하지 않고 거리를 재면 proline이 거리를 거의 결정해 나머지 12개 특성의 영향은 아주 작다.
잠깐 확인 (ch08-i01)
와인 데이터에서 표준화하지 않으면 두 와인의 거리²를 proline(표준편차 약 325) 하나가 99.7% 차지했다. 이 상태로 kNN을 쓰면 어떻게 되는가?
13개 특성이 거리에 고르게 반영된다
사실상 proline 값이 비슷한 와인을 이웃으로 고르는 모델이 된다
표준편차가 큰 proline은 거리 계산에서 자동으로 빠진다
거리는 단위의 영향을 받지 않으므로 표준화 전후가 같다
- 표준화(평균 0, 표준편차 1)하면 각 특성이 “자기 퍼짐 대비 얼마나 다른가”로 같은 무게를 갖는다. 스케일러는 05장대로 훈련 데이터에만 맞추고 검증·새 데이터에는
transform만 한다. - 표준화가 늘 정답은 아니다. 모든 특성이 같은 단위이고 크기 자체가 의미 있으면(예: 이미지 픽셀 밝기 0~16) 그대로 둔다. 거꾸로 중요하지 않은 특성이 많으면 표준화로 그 특성들의 무게가 커질 수도 있다. 어떤 특성을 넣을지가 거리 기반 방법의 성능을 크게 좌우한다.
수학 상자: 모든 쌍의 거리를 행렬곱으로
섹션 제목: “수학 상자: 모든 쌍의 거리를 행렬곱으로”kNN·k-평균·검색은 “점 m개와 점 n개 사이의 모든 거리”가 필요하다. 이중 for 문 대신 다음 전개를 쓴다.
from sklearn.metrics.pairwise import euclidean_distances
def sq_dists(A, B):                                                 # (m, d), (n, d) → (m, n) 거리²    D2 = (A ** 2).sum(axis=1)[:, None] + (B ** 2).sum(axis=1)[None, :] - 2 * A @ B.T    return np.maximum(D2, 0)                                        # 반올림 오차로 생긴 −0.0000001 같은 값을 0으로
loop = np.array([[np.sum((p - q) ** 2) for q in z_tr[:5]] for p in z_tr[:3]])print(sq_dists(z_tr[:3], z_tr[:5]).shape, np.allclose(sq_dists(z_tr[:3], z_tr[:5]), loop), np.allclose(sq_dists(z_tr, z_tr), euclidean_distances(z_tr, z_tr, squared=True)))(3, 5) True TrueA @ B.T가 모든 쌍의 내적 를 (m, n) 행렬로 한 번에 준다. 앞의 두 항은 02장의 브로드캐스팅으로 (m, 1) + (1, n) → (m, n)이 된다.A[:, None, :] - B[None, :, :]로 차이를 직접 만들어도 되지만 (m, n, d) 배열이 생겨 메모리가 d배 든다. 위 전개는 (m, n)만 만든다. 반올림 때문에 아주 작은 음수가 나올 수 있어 0으로 자른다. 좌표가 아주 큰데(예: 10억) 서로 가까운 점이면 큰 수끼리 빼며 유효 숫자가 사라져 실제 거리가 0으로 나올 수도 있다. 이것은 자르기로 해결되지 않으므로, 그런 데이터는 먼저 표준화하거나 차이를 직접 계산한다.
잠깐 확인 (ch08-i02)
점 2개(A)와 점 1개(B) 사이의 거리²를 전개식으로 구한다. 아래 코드의 출력은?
import numpy as np
A = np.array([[0., 0.], [3., 4.]])
B = np.array([[0., 4.]])
D2 = (A ** 2).sum(1)[:, None] + (B ** 2).sum(1)[None, :] - 2 * A @ B.T
print(D2.ravel().tolist(), np.sqrt(D2).ravel().tolist())
[0.0, 16.0] [0.0, 4.0]
[16.0, 25.0] [4.0, 5.0]
[4.0, 3.0] [2.0, 1.7320508075688772]
[16.0, 9.0] [4.0, 3.0]
8-4. kNN: 가까운 이웃의 다수결
섹션 제목: “8-4. kNN: 가까운 이웃의 다수결”직접 구현과 sklearn
섹션 제목: “직접 구현과 sklearn”k-최근접 이웃(k-nearest neighbors, kNN) 분류는 새 표본과 거리가 가장 가까운 훈련 표본 k개를 찾아 그 정답의 다수결로 예측한다. 회귀(KNeighborsRegressor)는 이웃 정답의 평균을 낸다. “학습”은 훈련 데이터를 저장하는 것(설정에 따라 빠른 검색용 트리를 만드는 것까지)이다. sklearn에서 훈련 표본을 더하려면 기존 표본과 합쳐 다시 fit한다.
from sklearn.neighbors import KNeighborsClassifier
def knn_predict(X_tr, y_tr, X_new, k):    nn = np.argsort(sq_dists(X_new, X_tr), axis=1)[:, :k]           # 행마다 가까운 k개의 위치    return np.array([np.bincount(y_tr[row]).argmax() for row in nn])  # 다수결(동점이면 작은 범주)
z_va = sc.transform(w_va)mine = knn_predict(z_tr, yw_tr, z_va, k=5)knn = KNeighborsClassifier(n_neighbors=5).fit(z_tr, yw_tr)print("sklearn과 같은 예측:", np.array_equal(mine, knn.predict(z_va)), "/ 검증 정확도", round(np.mean(mine == yw_va), 3))print("이웃 5개의 정답:", yw_tr[knn.kneighbors(z_va[:1])[1][0]], "→ 예측", knn.predict(z_va[:1])[0], "/ 확률", knn.predict_proba(z_va[:1])[0])sklearn과 같은 예측: True / 검증 정확도 0.963이웃 5개의 정답: [0 0 0 0 0] → 예측 0 / 확률 [1. 0. 0.]- 직접 쓴 세 줄이 sklearn과 같은 예측을 낸다.
predict_proba는 이웃 k개 중 범주별 비율이다. weights="distance"로 두면 가까운 이웃에 거리의 역수만큼 더 큰 표를 준다.
표준화를 빼면
섹션 제목: “표준화를 빼면”from sklearn.pipeline import make_pipeline
raw = KNeighborsClassifier(n_neighbors=5).fit(w_tr, yw_tr)scaled = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5)).fit(w_tr, yw_tr)print(f"표준화 없음: 검증 {raw.score(w_va, yw_va):.3f} / 표준화: 검증 {scaled.score(w_va, yw_va):.3f}")표준화 없음: 검증 0.722 / 표준화: 검증 0.963- 같은 모델인데 표준화만으로 정확도가 크게 바뀐다. 표준화 없이는 proline이 비슷한 와인을 이웃으로 고르는 모델이 된다.
make_pipeline으로 묶으면 교차검증 때도 스케일러가 각 조각의 훈련 부분에만 맞춰진다(05장).
잠깐 확인 (ch08-i03)
kNN을 교차검증할 때 make_pipeline(StandardScaler(), KNeighborsClassifier())로 묶는 가장 중요한 이유는?
조각마다 스케일러가 그 조각의 훈련 부분에만 맞춰져, 검증 부분의 정보가 새지 않는다
KNeighborsClassifier는 표준화한 입력만 받아 그대로 쓰면 오류가 나기 때문이다파이프라인으로 묶으면 이웃 수
k가 교차검증 안에서 자동으로 정해지기 때문이다표준화는 검증 데이터로 맞춰야 정확한데, 파이프라인이 그렇게 해 주기 때문이다
k 고르기: 편향과 분산
섹션 제목: “k 고르기: 편향과 분산”from sklearn.model_selection import StratifiedKFold, cross_val_score
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)print(" k 훈련 교차검증")for k in [1, 5, 15, 31, 61, 91]: model = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k)) tr = model.fit(w_tr, yw_tr).score(w_tr, yw_tr) print(f"{k:3d} {tr:6.3f} {cross_val_score(model, w_tr, yw_tr, cv=cv).mean():8.3f}") k 훈련 교차검증 1 1.000 0.919 5 0.968 0.951 15 0.952 0.943 31 0.976 0.952 61 0.952 0.831 91 0.661 0.403← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
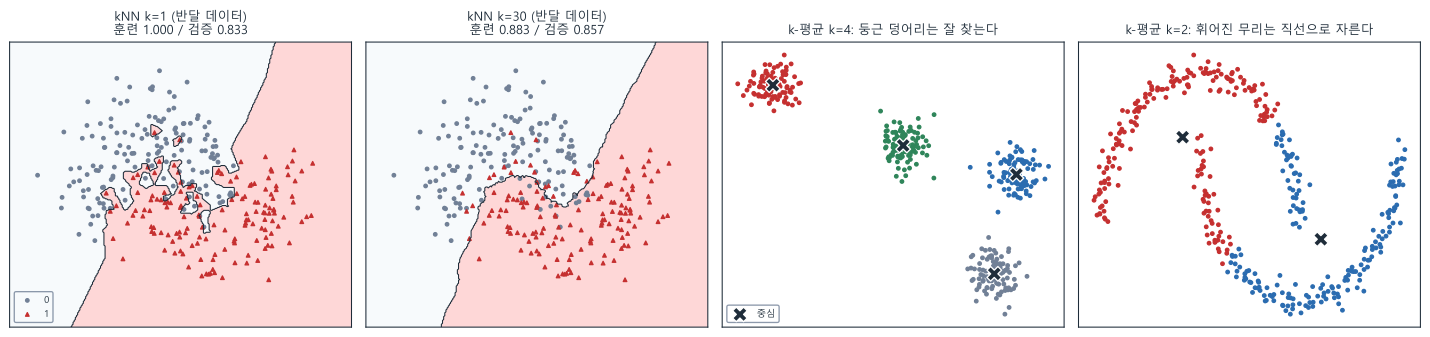
그림 설명. 네 칸 모두 좌표축 눈금은 생략했다. 첫째·둘째 칸은 07장의 반달 데이터(훈련 300개, 회색 점이 0, 빨간 삼각형이 1)에 kNN을 학습한 결정 영역이고, 붉은 영역이 1로 예측하는 곳이다. k = 1은 경계가 표본 하나하나를 따라 구불구불하고 상대 영역 안에 작은 섬이 생긴다(훈련 1.000, 검증 0.833). k = 30은 경계가 매끈한 곡선이 된다(훈련 0.883, 검증 0.857). 셋째 칸은 둥근 덩어리 4개(400개)에 k-평균 k = 4를 돌린 결과로, 덩어리마다 한 색이고 × 표시한 중심이 각 덩어리 가운데에 있다. 넷째 칸은 잡음이 적은 반달 2개(400개)에 k-평균 k = 2를 돌린 결과다. 두 무리가 반달 모양을 따르지 못하고 비스듬한 직선 하나로 갈려, 각 무리에 다른 반달의 일부가 섞인다.
- k = 1이면 훈련 표본의 가장 가까운 이웃은 자기 자신이라 훈련 정확도가 늘 1.0이다(같은 좌표에 정답이 다른 표본이 없다면). 경계가 표본 하나하나를 따라 구불구불해진다(그림 첫 칸, 07장의 반달 데이터). 07장의 제한 없는 트리처럼 분산이 크다.
- k를 키우면 더 많은 이웃을 평균해 경계가 매끈해지고(그림 둘째 칸), 너무 크면 먼 이웃까지 섞여 편향이 커진다. k = 61부터 교차검증 정확도가 떨어지고, k = 91이면 교차검증 조각마다 훈련 부분(약 99개)의 거의 전부가 이웃이라 품종을 거의 구분하지 못한다.
- 이 데이터에서는 k = 5~31이 비슷하게 좋다. 비슷하면 경계가 더 매끈한 큰 k가 더 단순한 모델이다. k는 교차검증으로 고른다(실습 문제 4).
- 범주가 2개이고 이웃마다 같은 무게로 투표하면, k를 홀수로 둘 때 동점이 생기지 않는다(
weights="distance"에서는 홀수여도 동점이 날 수 있다).
차원의 저주
섹션 제목: “차원의 저주”정답과 무관한 특성이 많아지면 거리가 흐려진다. 극단적인 경우로, 서로 독립인 무작위 특성만 있을 때 차원을 늘려 본다. 0~1 사이 균등 분포에서 점 500개를 뽑고, 새 점 하나에서 가장 가까운 점과 가장 먼 점의 거리를 비교한다.
rng = np.random.default_rng(0)print("차원 최근접 최원 비율")for d in [2, 10, 100, 1000]: P, q = rng.uniform(size=(500, d)), rng.uniform(size=d) dist = np.linalg.norm(P - q, axis=1) print(f"{d:4d} {dist.min():7.2f} {dist.max():6.2f} {dist.min() / dist.max():6.3f}")차원 최근접 최원 비율 2 0.03 1.27 0.024 10 0.34 1.91 0.177 100 3.39 4.60 0.7371000 12.32 13.63 0.904- 2차원에서는 가장 가까운 점이 가장 먼 점보다 수십 배 가깝지만, 1000차원에서는 둘의 비율이 1에 가깝다. 모든 점이 “비슷하게 멀어서” 가장 가까운 이웃이라는 말이 별 뜻이 없어진다. 이를 차원의 저주(curse of dimensionality)라 한다.
- 이 실험은 모든 특성이 서로 독립인 잡음인 경우다. 실제 데이터는 특성끼리 얽혀 있어 정보가 몇 개 방향에 몰려 있으므로 이보다 덜하다. 차원 수 자체보다 정답과 무관한 독립적인 특성이 많을수록 거리의 상대적 차이가 작아진다고 이해한다. 그래서 kNN 앞에 특성을 고르거나 PCA로 줄이거나(8-6절), 의미 있는 특성 공간(15·17장)을 쓴다.
- kNN은 예측할 때마다 훈련 표본과 거리를 잰다. 훈련 표본이 수백만 개면 예측이 느리다. sklearn은
algorithm="auto"일 때 낮은 차원에서는 KD 트리·볼 트리로 계산을 줄이지만, 차원이 높으면 대개 모든 표본과 재는 전수 검색(brute)을 고른다. 아주 큰 데이터의 고차원 검색에는 sklearn 밖의 근사 최근접 검색 도구를 따로 쓴다(8-7절, 17장).
잠깐 확인 (ch08-i04)
모든 특성을 서로 독립으로 0~1 균등 분포에서 뽑은 데이터에서 차원을 2에서 1000으로 늘리면, 한 점에서 가장 가까운 점까지의 거리와 가장 먼 점까지의 거리의 비율이 1에 가까워진다.
O / X
8-5. k-평균 군집
섹션 제목: “8-5. k-평균 군집”할당과 평균 갱신을 되풀이한다
섹션 제목: “할당과 평균 갱신을 되풀이한다”k-평균(k-means)은 정답 없이 점들을 k개 무리로 나눈다. 각 무리의 대표점을 중심(centroid)이라 한다.
- 중심 k개를 정한다(예: 표본 k개를 무작위로 고른다).
- 할당: 모든 점을 가장 가까운 중심의 무리에 넣는다.
- 갱신: 각 중심을 그 무리 점들의 평균으로 옮긴다.
- 할당이 더 바뀌지 않을 때까지(또는 반복 상한까지) 2~3을 되풀이한다.
from sklearn.datasets import make_blobsfrom sklearn.cluster import KMeans
Xb, yb = make_blobs(n_samples=400, centers=4, cluster_std=0.8, random_state=6)
def kmeans(X, C, max_iter=100):    labels = None    for it in range(1, max_iter + 1):        new = sq_dists(X, C).argmin(axis=1)                         # 할당: 가장 가까운 중심        if labels is not None and np.array_equal(new, labels):            break                                                   # 할당이 그대로면 끝        labels = new        C = np.array([X[labels == j].mean(axis=0) for j in range(len(C))])   # 갱신: 무리의 평균    labels = sq_dists(X, C).argmin(axis=1)                          # 최종 중심으로 다시 할당(상한에서 끝날 때 대비)    inertia = sq_dists(X, C)[np.arange(len(X)), labels].sum()    return labels, C, inertia, it
C0 = Xb[np.random.default_rng(0).choice(len(Xb), 4, replace=False)] # 처음 중심: 표본 4개labels, C, inertia, it = kmeans(Xb, C0)km = KMeans(n_clusters=4, init=C0, n_init=1, tol=0).fit(Xb) # tol=0: 할당이 그대로일 때까지print("반복", it, "/ inertia 직접", round(inertia, 1), "sklearn", round(km.inertia_, 1))print("같은 할당:", np.array_equal(labels, km.labels_), "/ 같은 중심:", np.allclose(C, km.cluster_centers_))반복 4 / inertia 직접 473.0 sklearn 473.0같은 할당: True / 같은 중심: True- inertia는 각 점과 자기 중심 사이 거리²의 합이다. k-평균은 이것을 줄이는 방법이다. 할당 단계는 중심을 고정하고 inertia를 줄이고(가장 가까운 중심), 갱신 단계는 할당을 고정하고 줄인다(거리² 합을 가장 작게 하는 점이 평균이다, 07장 회귀 트리의 잎 평균과 같은 이유). 그래서 반복마다 inertia가 늘지 않고, 몇 번 만에 멈춘다.
- 무리가 비면 평균을 낼 수 없다. 직접 구현은 이 경우를 다루지 않았고, sklearn은 먼 점으로 중심을 옮겨 처리한다.
처음 중심에 따라 결과가 다르다
섹션 제목: “처음 중심에 따라 결과가 다르다”print("처음 중심(seed)별 inertia:", [round(KMeans(4, init="random", n_init=1, random_state=s).fit(Xb).inertia_, 1) for s in range(6)])best = KMeans(4, init="random", n_init=10, random_state=0).fit(Xb)print("n_init=10의 inertia:", round(best.inertia_, 1))처음 중심(seed)별 inertia: [473.0, 473.0, 4539.5, 2184.1, 473.0, 473.0]n_init=10의 inertia: 473.0- k-평균은 지금 할당에서 조금씩 나아질 뿐이라, 처음 중심이 나쁘면 두 무리를 하나로 합치고 한 무리를 둘로 쪼갠 채 멈춘다(지역 최솟값). 위에서 seed 2·3의 inertia는 가장 좋은 결과의 네 배가 넘는다.
- 그래서 처음 중심을 바꿔 여러 번 돌리고 inertia가 가장 작은 결과를 고른다(
n_init). sklearn 기본 초기화init="k-means++"는 서로 먼 점을 처음 중심으로 고르는 방법이라 이런 실패가 줄지만, 여러 번 돌리는 것이 안전하다.
잠깐 확인 (ch08-i05)
처음 중심을 무작위로 고르는 k-평균(k = 4)을 seed만 바꿔 돌렸더니 inertia가 473.0, 4539.5, 2184.1로 달랐다. 옳은 것은?
inertia가 큰 결과일수록 무리를 더 넓게 잘 나눈 것이다
k-평균은 언제나 같은 답을 내므로 계산 오류가 난 것이다
처음 중심 탓에 지역 최솟값에 멈췄으니 inertia가 가장 작은 결과를 고른다
k를 5로 늘리면 처음 중심과 관계없이 같은 결과가 나온다
k 고르기: inertia와 실루엣 점수
섹션 제목: “k 고르기: inertia와 실루엣 점수”from sklearn.metrics import silhouette_score
print(" k inertia 실루엣")for k in range(2, 8): m = KMeans(n_clusters=k, n_init=10, random_state=0).fit(Xb) print(f"{k:2d} {m.inertia_:9.1f} {silhouette_score(Xb, m.labels_):7.3f}") k inertia 실루엣 2 6352.7 0.623 3 2228.9 0.699 4 473.0 0.799 5 427.9 0.670 6 386.2 0.554 7 346.7 0.426- 가장 좋은(전역 최솟값) inertia는 k를 늘리면 늘지 않는다(k = 표본 수면 0). 실제 실행 결과는 처음 중심에 따라 지역 최솟값에 머물러 예외가 생길 수 있지만,
n_init을 충분히 두면 대체로 줄어든다. 그래서 가장 작은 값이 아니라 줄어드는 폭이 갑자기 작아지는 곳, 즉 엘보(elbow)를 본다. 여기서는 k = 4 뒤로 줄어드는 폭이 작아진다. - 실루엣 점수(silhouette score)는 점마다 를 구해 평균한 값이다. 는 자기 무리 안 다른 점들까지의 평균 거리, 는 다른 무리마다 그 점들까지의 평균 거리를 구해 그중 가장 작은 값이다. 값은 −1~1이고, 1에 가까우면 무리가 잘 갈라졌고, 0 근처면 경계에 걸쳤고, 음수면 다른 무리에 더 가깝게 잘못 들어갔다는 뜻이다. 무리 수가 2 이상, 표본 수 − 1 이하여야 계산되고, 표본이 하나뿐인 무리의 점은 sklearn이 0으로 둔다. 이 데이터에서는 k = 4가 가장 높다.
- 실제 데이터에서는 두 기준이 흐릿한 경우가 많다. 그때는 “몇 개로 나눠야 쓸모 있나”(마케팅 팀이 다룰 수 있는 고객군 수 등)가 k를 정한다.
한계: 모양과 단위, 그리고 정답이 아니다
섹션 제목: “한계: 모양과 단위, 그리고 정답이 아니다”from sklearn.datasets import make_moonsfrom sklearn.metrics import adjusted_rand_score
Xm, ym = make_moons(n_samples=400, noise=0.05, random_state=0)km_m = KMeans(n_clusters=2, n_init=10, random_state=0).fit(Xm)print("반달 2개: 실제 무리와의 일치(ARI)", round(adjusted_rand_score(ym, km_m.labels_), 3))print("덩어리 4개: 실제 무리와의 일치(ARI)", round(adjusted_rand_score(yb, best.labels_), 3))반달 2개: 실제 무리와의 일치(ARI) 0.274덩어리 4개: 실제 무리와의 일치(ARI) 1.0- 둥근 덩어리 4개는 실제 무리를 그대로 찾았다(ARI 1.0). ARI(adjusted rand index)는 두 무리 나누기가 얼마나 같은지를 잰다. 1이면 같고(무리 번호가 바뀐 것은 상관없다), 0 근처면 우연 수준이며, 우연보다 못하면 음수도 나온다. 여기서는 데이터를 만들 때의 무리와 비교했다. 정답이 없어도 두 군집 결과(예: 설정을 바꾼 두 실행)가 얼마나 같은지 비교하는 데 쓸 수 있다.
- k-평균은 각 점을 가장 가까운 중심에 넣으므로 무리 경계가 중심 사이의 직선이다(특성이 3개 이상이면 평면·초평면). 둥글고 크기가 비슷한 덩어리는 잘 찾지만, 반달처럼 휘어진 무리는 가운데를 직선으로 자른다(그림 넷째 칸). 이런 모양에는 밀도로 묶는
DBSCAN이나, 가까운 무리부터 차례로 합치는 계층적 군집(AgglomerativeClustering)을 고려한다. 계층적 군집은 무리 사이 거리를 재는 방식(linkage)에 따라 찾는 모양이 달라서, 이 반달은 기본값"ward"로는 못 찾고"single"로는 찾는다. - 거리를 쓰므로 kNN과 같이 단위가 큰 특성이 무리를 정한다. 표준화를 먼저 한다.
- 군집 결과는 정답이 아니다. 같은 데이터도 특성·k·단위에 따라 다른 무리가 나온다. 무리마다 특성 평균을 보고 사람이 이름을 붙이고, 그 나누기가 업무에 쓸모 있는지를 따로 확인한다.
잠깐 확인 (ch08-i06)
k-평균으로 고객을 4개 무리로 나눴다면, 그 무리는 데이터에 숨어 있던 정답 등급이므로 따로 확인하지 않고 그대로 써도 된다.
O / X
8-6. PCA: 가장 넓게 퍼진 방향
섹션 제목: “8-6. PCA: 가장 넓게 퍼진 방향”주성분
섹션 제목: “주성분”특성이 2개인 점들이 비스듬한 타원 모양으로 퍼져 있다고 하자. 축을 돌려 점들이 가장 넓게 퍼진 방향을 첫째 축으로, 그와 직각인 방향 중 가장 넓게 퍼진 방향을 둘째 축으로 삼는다. 이 축들을 주성분(principal component)이라 하고, 이렇게 축을 바꾸는 방법이 주성분 분석(principal component analysis, PCA)이다. 뒤쪽 주성분 몇 개를 버리면 정보를 조금 잃고 차원을 줄인다.
sklearn PCA로 주성분을 구하고, 바꾼 좌표가 어떻게 계산되는지 확인한다.
from sklearn.decomposition import PCA
rng = np.random.default_rng(0)x1 = rng.normal(0, 2, 300)X2 = np.column_stack([x1, 0.5 * x1 + rng.normal(0, 0.5, 300)])     # 비스듬한 타원
pca2 = PCA().fit(X2)print("주성분(행)", pca2.components_.round(3).tolist())print("주성분별 분산", pca2.explained_variance_.round(3), "/ 설명된 분산 비율", pca2.explained_variance_ratio_.round(3))Z2 = pca2.transform(X2)print("transform = (X − 평균) @ 주성분ᵀ:", np.allclose(Z2, (X2 - pca2.mean_) @ pca2.components_.T))print("변환 뒤 상관계수", np.corrcoef(Z2.T)[0, 1].round(6), "/ 열별 분산", Z2.var(axis=0, ddof=1).round(3))주성분(행) [[0.882, 0.471], [-0.471, 0.882]]주성분별 분산 [5.291 0.187] / 설명된 분산 비율 [0.966 0.034]transform = (X − 평균) @ 주성분ᵀ: True변환 뒤 상관계수 0.0 / 열별 분산 [5.291 0.187]- 첫째 주성분 (0.88, 0.47)은 직선을 따르는 방향이고 분산의 약 97%를 설명한다. 둘째 주성분은 그와 직각이다.
- 주성분의 부호는 정해져 있지 않다. (a, b)와 (−a, −b)는 같은 축이고, 좌표의 부호만 바뀐다. 라이브러리나 버전이 다르면 부호가 뒤집혀 나올 수 있다.
transform은 평균(mean_)을 빼고 주성분 방향으로 내적한 것(투영)이다. PCA를 맞춘 데이터에서는 바꾼 좌표끼리 상관이 0이고(분산이 0인 성분은 빼고), 열별 분산이explained_variance_와 같다. 새 데이터를 변환한 좌표는 이와 조금 다를 수 있다. 원래 특성 사이에 얽혀 있던 정보를 서로 겹치지 않는 축으로 다시 나눈 것이다.- 주성분 계산은 sklearn에 맡긴다(데이터 크기에 따라 특잇값 분해나 공분산 행렬의 고유값 분해 중 하나를 고른다).
explained_variance_ratio_(설명된 분산 비율)는 각 주성분이 전체 분산 중 얼마를 담는지다. 이 값의 누적합으로 몇 개를 남길지 정한다.
64차원 손글씨를 2차원으로
섹션 제목: “64차원 손글씨를 2차원으로”sklearn 내장 손글씨 숫자(load_digits)는 8×8 픽셀 이미지 1797장이다. 펼치면 특성이 64개다.
from sklearn.datasets import load_digits
digits = load_digits()Xd, yd = digits.data, digits.targetpca_d = PCA().fit(Xd)cum = np.cumsum(pca_d.explained_variance_ratio_)print(Xd.shape, "/ 처음 2개", cum[1].round(3), "/ 10개", cum[9].round(3), "/ 20개", cum[19].round(3))print("90%에 필요한 주성분 수", np.searchsorted(cum, 0.90) + 1, "/ 95%", np.searchsorted(cum, 0.95) + 1)print("PCA(n_components=0.9):", PCA(n_components=0.9).fit(Xd).n_components_)(1797, 64) / 처음 2개 0.285 / 10개 0.738 / 20개 0.89490%에 필요한 주성분 수 21 / 95% 29PCA(n_components=0.9): 21← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
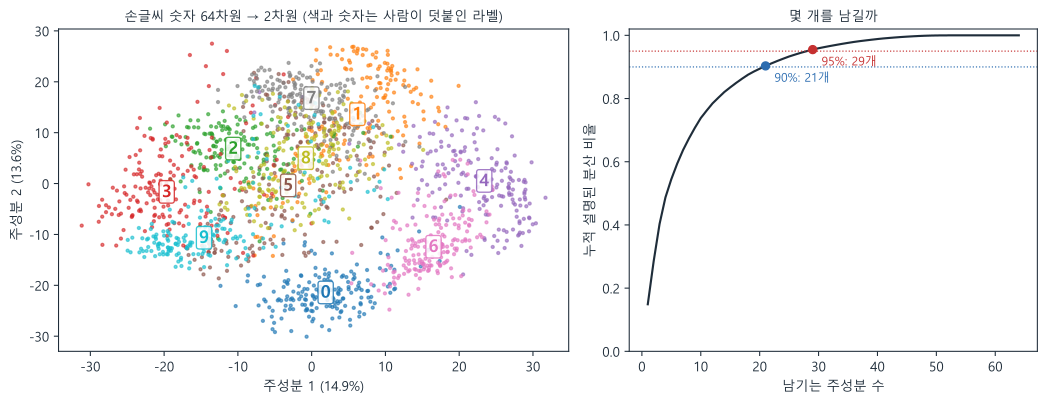
그림 설명. 왼쪽은 손글씨 숫자 1797장을 가로축 주성분 1(분산의 14.9%), 세로축 주성분 2(13.6%)에 찍은 산점도다. 숫자마다 색을 다르게 하고, 그 숫자 점들의 가운데에 숫자를 적었다. 0은 아래, 4는 오른쪽, 6은 오른쪽 아래, 3은 왼쪽, 9는 왼쪽 아래에 비교적 따로 모이고, 1·5·7·8과 2는 가운데에서 서로 겹친다. 오른쪽은 가로축 남기는 주성분 수(1~64), 세로축 누적 설명된 분산 비율(0~1)이다. 곡선은 처음에 가파르게 오르다 완만해지며, 점선 표시처럼 90%는 21개, 95%는 29개에서 넘는다.
- 처음 주성분 2개는 분산의 약 29%만 담는다. 그래도 2차원 그림(왼쪽)에서 0·3·4·6처럼 무리가 갈라지는 숫자가 보인다. 1·5·7·8처럼 가운데서 겹치는 숫자도 있다. 2차원으로 그린 그림은 데이터를 둘러보는 용도이고, 겹친다고 해서 원래 64차원에서 구분이 안 된다는 뜻은 아니다.
- 분산의 90%는 21개, 95%는 29개로 담긴다(오른쪽).
PCA(n_components=0.9)처럼 비율을 주면 그만큼 담는 최소 개수를 sklearn이 고른다. - PCA는 라벨을 보지 않는다. 그림에 숫자별 색을 칠한 것은 사람이 결과를 보려고 덧붙인 것이다.
잠깐 확인 (ch08-i07)
손글씨 숫자 64차원을 주성분 2개(분산의 약 29%)로 그렸더니 1·5·7·8이 가운데서 겹쳤다. 옳은 해석은?
이 숫자들은 64차원에서도 구분할 수 없다
PCA가 라벨을 보고 비슷한 숫자끼리 일부러 모았다
2차원은 분산의 일부만 담으므로, 겹쳐 보여도 원래 차원에서는 구분될 수 있다
주성분 2개만 남겨도 kNN 정확도는 64차원과 거의 같다
줄인 뒤 모델에 넣기
섹션 제목: “줄인 뒤 모델에 넣기”d_tr, d_va, yd_tr, yd_va = train_test_split(Xd, yd, test_size=0.3, stratify=yd, random_state=0)for name, model in [("kNN(64차원) ", KNeighborsClassifier(n_neighbors=5)), ("PCA 20 + kNN ", make_pipeline(PCA(n_components=20), KNeighborsClassifier(n_neighbors=5))), ("PCA 2 + kNN ", make_pipeline(PCA(n_components=2), KNeighborsClassifier(n_neighbors=5)))]: print(name, "검증 정확도", round(model.fit(d_tr, yd_tr).score(d_va, yd_va), 3))
p20 = PCA(n_components=20).fit(d_tr)back = p20.inverse_transform(p20.transform(d_va)) # 20차원으로 줄였다가 64차원으로 되돌림print("복원 평균 제곱 오차", round(np.mean((back - d_va) ** 2), 3), "/ 픽셀 분산 평균", round(d_va.var(axis=0).mean(), 3))kNN(64차원) 검증 정확도 0.98PCA 20 + kNN 검증 정확도 0.974PCA 2 + kNN 검증 정확도 0.606복원 평균 제곱 오차 2.096 / 픽셀 분산 평균 18.887- 64차원을 20차원으로 줄여도 kNN 정확도가 거의 그대로다. 거리 계산이 3배 넘게 준다. 버린 방향에 잡음이 주로 놓여 있었다면 잡음을 줄이는 효과도 있지만, 그것이 보장되지는 않는다. 2차원까지 줄이면 크게 떨어진다. 그림용 차원과 모델용 차원은 다르다.
inverse_transform으로 되돌리면 버린 주성분만큼의 정보가 빠진 근사가 나온다. 이 복원 오차가 작을수록 정보를 덜 잃은 것이다.- PCA도
fit을 훈련 데이터에만 한다. 파이프라인에 넣으면 저절로 지켜진다. 검증 데이터까지 넣어 주성분을 구하면 05장의 누수다.
표준화와 PCA
섹션 제목: “표준화와 PCA”p_raw = PCA().fit(w_tr)p_std = make_pipeline(StandardScaler(), PCA()).fit(w_tr)[-1]print("와인 첫 주성분이 설명한 분산: 원래", p_raw.explained_variance_ratio_[0].round(3), "/ 표준화 뒤", p_std.explained_variance_ratio_[0].round(3))print("원래 단위 첫 주성분에서 가장 큰 성분:", wine.feature_names[np.abs(p_raw.components_[0]).argmax()])와인 첫 주성분이 설명한 분산: 원래 0.998 / 표준화 뒤 0.37원래 단위 첫 주성분에서 가장 큰 성분: proline- 표준화하지 않으면 와인의 첫 주성분이 분산의 99.8%를 “설명”하는데, 그 주성분은 거의 proline 축 하나다. 표준화하면 첫 주성분은 여러 특성이 섞인 방향이 되고, 그 주성분이 설명하는 분산 비율은 37%가 된다. 분산이 큰 방향을 찾는 방법이라 표준화하지 않으면 단위가 큰 특성이 주성분 방향을 좌우한다. 단위가 서로 다른 표 데이터는 표준화한 뒤 PCA를 한다.
- PCA는 분산이 큰 방향을 남길 뿐, 정답을 가르는 데 중요한 방향을 남긴다는 보장은 없다. 분산이 작은 방향에 중요한 정보가 있으면 PCA로 잃는다. 차원 축소 뒤 성능은 늘 검증으로 확인한다.
잠깐 확인 (ch08-i08)
단위가 서로 다른 와인 특성 13개에 표준화 없이 PCA를 했더니 첫 주성분이 분산의 99.8%를 설명했다. 그 이유는?
proline의 분산이 압도적으로 커서 첫 주성분이 거의 proline 축이 되었기 때문이다
와인 데이터는 원래 1차원 구조라 주성분 하나로 충분하기 때문이다
PCA가 품종을 가장 잘 가르는 방향을 첫 주성분으로 골랐기 때문이다
표준화하지 않으면 PCA가 라벨을 함께 쓰기 때문이다
8-7. 코사인 유사도와 최근접 검색
섹션 제목: “8-7. 코사인 유사도와 최근접 검색”길이 말고 방향
섹션 제목: “길이 말고 방향”코사인 유사도(cosine similarity)는 두 벡터 사이 각도의 코사인이다.
두 벡터가 모두 영벡터가 아닐 때 정의되고, 방향이 같으면 1, 직각이면 0, 반대면 −1이다. 길이는 보지 않는다. 문서를 “단어(또는 글자 묶음)별 등장 횟수” 벡터로 만들면, 같은 내용을 두 번 이어 쓴 문서는 벡터 길이만 두 배가 된다. 내용이 같으니 같다고 봐야 한다.
def cosine(a, b):    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))
doc = np.array([2.0, 1.0, 0.0, 3.0]) # 단어 4종의 등장 횟수print("두 번 이어 쓴 문서: 유클리드", np.linalg.norm(doc - 2 * doc).round(3), "/ 코사인", cosine(doc, 2 * doc).round(3))print("겹치는 단어 없음 : 코사인", cosine(doc, np.array([0.0, 0.0, 5.0, 0.0])))두 번 이어 쓴 문서: 유클리드 3.742 / 코사인 1.0겹치는 단어 없음 : 코사인 0.0- 유클리드 거리는 길이 차이 때문에 두 문서를 멀다고 보지만, 코사인 유사도는 1(같은 방향)이다. 그래서 문서·문장 임베딩(17장)처럼 방향이 의미를 담는 벡터에는 코사인 유사도를 쓴다.
- 코사인 거리는 1 − 코사인 유사도다. sklearn에서
metric="cosine"이 이것이다.
정규화하면 행렬곱 한 번
섹션 제목: “정규화하면 행렬곱 한 번”FAQ 문장 6개 중 질문과 가장 비슷한 것을 찾는다. 문장을 글자 두 개씩 묶은 조각(예: “배송은” → “배송”, “송은”. 단어 앞뒤에는 공백을 붙여 ” 배”, “은 “도 센다)의 등장 횟수 벡터로 바꾼다. 한국어는 조사가 붙어 단어 단위로 세면 “배송은”과 “배송”이 다른 단어가 되기 때문이다. 이 방법은 같은 글자가 겹치는지만 볼 뿐 뜻은 모른다. 뜻을 담는 문장 임베딩은 17장에서 다룬다.
from sklearn.feature_extraction.text import CountVectorizerfrom sklearn.neighbors import NearestNeighbors
faq = ["배송은 주문 후 2~3일 걸립니다", "환불은 수령 후 7일 안에 신청하세요", "교환하려면 고객센터에 연락하세요",       "배송 조회는 마이페이지에서 합니다", "쿠폰은 결제 화면에서 적용됩니다", "회원 등급은 매달 1일에 바뀝니다"]queries = ["배송 며칠 걸려요", "환불 신청 기간", "쿠폰 어디서 써요"]vec = CountVectorizer(analyzer="char_wb", ngram_range=(2, 2)).fit(faq)   # 글자 2개 묶음의 등장 횟수D = vec.transform(faq).toarray().astype(float)Q = vec.transform(queries).toarray().astype(float)print("벡터 모양", D.shape, Q.shape)
def normalize(M):    n = np.linalg.norm(M, axis=1, keepdims=True)    return M / np.where(n == 0, 1, n)                                # 행마다 길이 1로(영벡터는 0으로 둔다)
S = normalize(Q) @ normalize(D).T # (질문 3, 문서 6) 코사인 유사도top = np.argsort(-S, axis=1, kind="stable")[:, :2] # 큰 순서 상위 2개(같으면 앞 번호)for q, row, s in zip(queries, top, S): print(f"{q} → {faq[row[0]]} ({s[row[0]]:.2f}) / {faq[row[1]]} ({s[row[1]]:.2f})")nn = NearestNeighbors(n_neighbors=2, metric="cosine").fit(D)dist, idx = nn.kneighbors(Q)print("sklearn 코사인 거리 = 1 − 유사도:", np.allclose(1 - dist, np.take_along_axis(S, idx, axis=1)))벡터 모양 (6, 93) (3, 93)배송 며칠 걸려요 → 배송은 주문 후 2~3일 걸립니다 (0.31) / 배송 조회는 마이페이지에서 합니다 (0.31)환불 신청 기간 → 환불은 수령 후 7일 안에 신청하세요 (0.44) / 배송은 주문 후 2~3일 걸립니다 (0.00)쿠폰 어디서 써요 → 쿠폰은 결제 화면에서 적용됩니다 (0.35) / 교환하려면 고객센터에 연락하세요 (0.12)sklearn 코사인 거리 = 1 − 유사도: True- 각 행 벡터를 자기 L2 노름으로 나눠 길이를 1로 맞춰 두면(L2 정규화) 코사인 유사도는 그냥 내적이고, 질문 m개 × 문서 n개를 행렬곱 한 번에 구한다.
- 문서와 겹치는 글자 묶음이 하나도 없는 질문은 영벡터가 되어 코사인 유사도가 정의되지 않는다. 위
normalize는 영벡터를 0으로 남겨 유사도가 모두 0이 되게 했다. 이때는 상위 문서를 내지 말고 “비슷한 문서 없음”으로 처리한다. - 첫 질문은 두 배송 문서와 유사도가 같다. 두 문서 모두 질문과 겹치는 글자 묶음이 3개이고 묶음 수(19개)도 같아서다. 사람이 보면 “며칠 걸려요”는 첫 문서에 더 가깝지만, 이 벡터는 “걸려”와 “걸립”을 다른 묶음으로 센다. 동점을 어떻게 정할지(여기서는 앞 번호) 미리 정해 두지 않으면 실행마다, 라이브러리마다 순서가 달라질 수 있다.
- 모든 문서와 유사도를 재는 방법(전수 검색, brute force)은 문서 n개, 차원 d일 때 질문 하나에 n × d번 곱한다. 수만 개까지는 이것으로 충분하다. 수백만 개 이상이면 정확도를 조금 잃고 훨씬 빠른 근사 최근접 검색(ANN, FAISS 등)을 쓴다(17장).
잠깐 확인 (ch08-i09)
문서 벡터 3개와 질문 벡터 하나를 정규화해 내적으로 유사도를 구한다. 아래 코드의 출력은?
import numpy as np
D = np.array([[3., 4.], [1., 0.], [0., 2.]])
q = np.array([6., 8.])
Dn = D / np.linalg.norm(D, axis=1, keepdims=True)
s = Dn @ (q / np.linalg.norm(q))
print(s.round(2).tolist(), int(np.argmax(s)))
[50.0, 6.0, 16.0] 0
[1.0, 0.6, 0.8] 0
[1.0, 0.6, 0.8] 2
[0.6, 1.0, 0.8] 1
수학 상자: 정규화한 벡터의 거리와 코사인
섹션 제목: “수학 상자: 정규화한 벡터의 거리와 코사인”길이가 1인 두 벡터 , 에서는 8-3절의 전개가 이렇게 된다.
Dn = normalize(D)print("거리² = 2 − 2·코사인:", np.allclose(sq_dists(normalize(Q), Dn), 2 - 2 * S))거리² = 2 − 2·코사인: True- 정규화한 벡터에서는 유클리드 거리가 작은 순서와 코사인 유사도가 큰 순서가 같다. 그래서 정규화한 임베딩끼리 검색할 때는 유클리드 거리만 지원하는 검색 도구를 그대로 써도 순위가 같다. k-평균은 다르다. 입력을 정규화해도 평균으로 옮긴 중심은 보통 길이가 1이 아니라서, 유클리드 기준 할당이 코사인 기준 할당과 같다는 보장이 없다.
- 정규화하지 않은 벡터의 내적은 길이도 함께 본다. 검색 도구가 “내적”을 기준으로 할 때는 벡터를 먼저 정규화했는지 확인한다.
잠깐 확인 (ch08-i10)
벡터를 정규화하지 않은 채 내적 값으로 문서를 검색하면, 내용은 같고 단어 수만 두 배인 문서가 더 높은 점수를 받을 수 있다.
O / X
8-8. 거리 기반 방법을 언제 쓰나
섹션 제목: “8-8. 거리 기반 방법을 언제 쓰나”| 상황 | 고를 것 | 이유 |
|---|---|---|
| 의미 있는 특성 공간이 이미 있다(사전학습 모델이 뽑은 특성, 임베딩) | kNN 또는 코사인 최근접 검색 | 따로 학습할 모델이 없고, 새 데이터는 합쳐서 다시 fit(저장)하면 된다 |
| 표 데이터 분류·회귀에서 성능이 필요하다 | 트리 앙상블(07장), kNN은 비교용 | kNN은 단위·쓸모없는 특성·차원에 약하고 예측이 느리다 |
| 정답 없이 고객·문서를 몇 무리로 나누고 싶다 | 표준화 + k-평균(n_init 여러 번), 실루엣·업무 쓸모로 k 결정 |
둥근 무리를 빠르게 찾는다. 휘어진 무리는 DBSCAN 등 |
| 특성이 수십~수백 개인 데이터를 그림으로 보고 싶다 | 표준화 + PCA 2차원 | 가장 넓게 퍼진 두 방향으로 본다. 겹침은 2차원 한계일 수 있다 |
| 특성이 많아 kNN·거리 계산이 느리거나 흐리다 | PCA로 설명 분산 90~95%만 남기고 검증 | 분산이 작은 방향을 버려 계산을 줄인다. 버린 방향이 잡음이라는 보장도, 정답과 무관하다는 보장도 없다 |
| 문서·문장의 비슷함 | 정규화 + 코사인 유사도 | 길이가 아니라 방향이 내용을 담는다 |
8-9. 선택 기준표에 추가
섹션 제목: “8-9. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 거리·유사도를 쓰는 모델(kNN·k-평균·PCA) | 단위가 다른 특성은 표준화(훈련 데이터에만 fit) |
단위가 큰 특성 하나가 거리와 분산을 독차지한다 | 08 |
| kNN을 쓴다 | 표준화 + k를 교차검증으로 |
k가 작으면 분산, 크면 편향이 크다. 차원이 높으면 거리가 흐려진다 | 08 |
| 정답 없이 무리를 나눈다 | k-평균(n_init 여러 번) + 실루엣·업무 쓸모로 k, 결과는 사람이 해석 |
처음 중심에 따라 결과가 다르고, 군집은 정답이 아니다 | 08 |
| 차원을 줄인다 | PCA(설명된 분산 비율로 개수 결정, 성능은 검증) | 분산이 큰 방향이 정답에 중요한 방향이라는 보장은 없다 | 08 |
| 비슷한 문서·벡터를 찾는다 | L2 정규화 + 행렬곱 코사인 유사도, 동점 규칙을 정한다 | 방향이 내용을 담고, 정규화하면 행렬곱 한 번이다 | 08 |
확인 문제
섹션 제목: “확인 문제”문제 1 (ch08-e01)
두 점 , 의 맨해튼 거리는 ____이다.
답: ________________
문제 2 (ch08-e02)
표준화 + kNN의 (훈련, 교차검증) 정확도가 k = 1 (1.000, 0.919), k = 5 (0.968, 0.951), k = 31 (0.976, 0.952), k = 91 (0.661, 0.403)이었다. 옳은 것은?
k = 1은 훈련 정확도가 1.000이라 가장 좋은 선택이다
k를 키울수록 분산이 커져 교차검증 정확도가 떨어진다
k는 훈련 정확도가 가장 높은 값으로 고른다
k = 91은 너무 많은 이웃을 섞어 편향이 커진 경우다
문제 3 (ch08-e03)
특성 하나짜리 훈련 데이터에서 새 점 1.6의 이웃 3개를 찾아 다수결한다. 아래 코드의 출력은?
import numpy as np
X = np.array([[0.], [1.], [2.], [10.], [11.]])
y = np.array([0, 0, 1, 1, 1])
d = np.abs(X[:, 0] - 1.6)
nn = np.argsort(d)[:3]
print(nn.tolist(), np.bincount(y[nn]).argmax())
[2, 1, 0] 0
[2, 1, 0] 1
[0, 1, 2] 0
[2, 3, 4] 1
문제 4 (ch08-e04)
정답과 무관한 서로 독립인 특성이 수백 개 섞인 표 데이터에 kNN을 쓰려 한다. 가장 알맞은 대응은?
k를 1로 줄여 가장 가까운 이웃 하나만 본다
특성을 고르거나 PCA로 줄인 뒤, 성능을 검증으로 확인한다
표준화를 빼서 단위가 큰 특성이 거리를 정하게 둔다
특성을 더 추가해 거리 계산에 쓰는 정보를 늘린다
문제 5 (ch08-e05)
k-평균의 갱신 단계에서 각 중심을 그 무리 점들의 평균으로 옮기는 이유로 맞는 것은?
평균은 중앙값보다 이상치의 영향을 덜 받기 때문이다
평균으로 옮기면 알맞은 무리 수 k가 저절로 정해지기 때문이다
무리 안 점들까지의 거리² 합을 가장 작게 하는 점이 평균이기 때문이다
평균은 언제나 그 무리의 실제 표본 중 하나이기 때문이다
문제 6 (ch08-e06)
덩어리 데이터에서 k별 (inertia, 실루엣 점수)가 k = 3 (2228.9, 0.699), k = 4 (473.0, 0.799), k = 5 (427.9, 0.670), k = 7 (346.7, 0.426)이었다. 옳은 것은?
inertia가 가장 작은 k = 7을 고른다
실루엣 점수는 0에 가까울수록 무리가 잘 갈라진 것이다
가장 좋은 inertia는 k를 늘리면 커지므로 k = 3이 낫다
실루엣이 가장 높고 엘보도 보이는 k = 4를 고른다
문제 7 (ch08-e07)
특성 2개 데이터에서 k-평균은 각 점을 가장 가까운 중심에 넣으므로 두 무리의 경계가 직선이 되고, 그래서 반달처럼 휘어진 무리는 잘 찾지 못한다.
O / X
문제 8 (ch08-e08)
주성분별 설명된 분산 비율이 아래 r일 때, 분산의 90% 이상을 담는 최소 주성분 수를 구한다. 아래 코드의 출력은?
import numpy as np
r = np.array([0.5, 0.3, 0.12, 0.05, 0.03])
cum = np.cumsum(r)
print(int(np.searchsorted(cum, 0.9) + 1), cum.round(2).tolist())
2 [0.5, 0.8, 0.92, 0.97, 1.0]
4 [0.5, 0.8, 0.92, 0.97, 1.0]
3 [0.5, 0.8, 0.92, 0.97, 1.0]
3 [0.5, 0.3, 0.12, 0.05, 0.03]
문제 9 (ch08-e09)
PCA는 정답을 가르는 데 중요한 방향을 우선 남기므로, 설명된 분산 비율을 95% 남기면 분류 성능이 떨어질 일은 없다.
O / X
문제 10 (ch08-e10)
훈련과 검증 데이터를 합쳐 PCA를 fit한 뒤, 줄인 특성으로 kNN을 학습하고 검증 점수를 쟀다. 무엇이 문제인가?
PCA가 정답 라벨을 쓰므로 정답이 모델에 새어 들어간다
PCA를 검증 데이터로
fit하면 sklearn이 오류를 낸다문제없다. PCA는 라벨을 보지 않으므로 어떤 데이터로
fit해도 된다검증 데이터의 정보가 주성분에 들어가 검증 점수가 실제보다 좋게 나올 수 있다
문제 11 (ch08-e11)
두 벡터 , 의 코사인 유사도를 소수 셋째 자리까지 반올림하면 ____이다.
답: ________________
문제 12 (ch08-e12)
고객 데이터(나이, 연봉(원), 월 방문 횟수)로 k-평균 군집을 하려 한다. 먼저 할 일로 가장 알맞은 것은?
단위는 그대로 두고 k를 크게 잡아 잘게 나눈다
연봉이 무리를 독차지하지 않게 표준화하고,
n_init을 여러 번 둔다k-평균은 트리처럼 단위를 타지 않으므로 바로 돌린다
PCA로 1차원까지 줄인 뒤 그 축 하나로 나눈다
8-10. 실습과 문제
섹션 제목: “8-10. 실습과 문제”실습/문제/ch08_거리와_비지도_학습.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안팎에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 거리·kNN 참/거짓 |
| 2 | 코드 | 모든 쌍의 거리²를 행렬곱으로 |
| 3 | 코드 | kNN 분류 직접 구현 |
| 4 | 코드 | 표준화 + kNN의 k를 교차검증으로 고르기 |
| 5 | 코드 | k-평균 직접 구현 |
| 6 | 코드 | 설명된 분산 비율로 주성분 수 고르기, PCA로 줄이고 복원하기 |
| 7 | 코드 | 코사인 유사도 상위 k개 검색 |
| 8 | 개념 | k-평균·PCA 참/거짓 |
| 9 | 사례 | 연봉 하나로 갈린 고객 군집 |
| 10 | 사례 | 상황별 방법 고르기 |
8-11. 공식 문서와 참고 자료
섹션 제목: “8-11. 공식 문서와 참고 자료”- 최근접 이웃(사용자 안내서): https://scikit-learn.org/stable/modules/neighbors.html
- 군집(사용자 안내서, k-평균·DBSCAN 등 비교): https://scikit-learn.org/stable/modules/clustering.html
- 분해(사용자 안내서, PCA): https://scikit-learn.org/stable/modules/decomposition.html#pca
KNeighborsClassifier: https://scikit-learn.org/stable/modules/generated/sklearn.neighbors.KNeighborsClassifier.htmlKMeans: https://scikit-learn.org/stable/modules/generated/sklearn.cluster.KMeans.htmlPCA: https://scikit-learn.org/stable/modules/generated/sklearn.decomposition.PCA.htmlsilhouette_score: https://scikit-learn.org/stable/modules/generated/sklearn.metrics.silhouette_score.html- 실루엣 점수로 k 고르기 예제: https://scikit-learn.org/stable/auto_examples/cluster/plot_kmeans_silhouette_analysis.html
- 코사인 유사도(사용자 안내서, 쌍별 지표): https://scikit-learn.org/stable/modules/metrics.html#cosine-similarity
numpy.linalg.svd: https://numpy.org/doc/stable/reference/generated/numpy.linalg.svd.html