05장에서는 로지스틱 회귀를 “확률을 내는 모델”로만 빌려 쓰고, make_pipeline(StandardScaler(), ...)으로 표준화를 함께 묶으면서 왜 표준화가 필요한지는 미뤘다. 이 장은 그 안을 연다. 04장의 선형 회귀가 낸 숫자를 시그모이드로 0~1 확률로 바꾸면 로지스틱 회귀가 되고, 손실을 로그 손실로 바꾸면 04장과 같은 경사하강법으로 학습된다. 그다음 계수가 너무 커지는 과적합을 정규화로 누르고, 정규화가 왜 스케일링을 요구하는지 본다. 로지스틱 회귀는 표 데이터 분류에서 가장 먼저 세우는 기준선이고, 10장의 신경망 마지막 층도 같은 구조다.
6-1. 이 장의 목표와 완료 기준
섹션 제목: “6-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 선형 점수와 확률을 잇는다 | decision_function(z)에 시그모이드를 씌우면 predict_proba가 됨을 코드로 확인한다 |
| 계수를 읽는다 | coef_의 부호와 크기를 오즈(odds)로 해석한다 |
| 결정 경계를 그린다 | 특성 2개에서 경계가 직선인 이유와, 임계값을 바꾸면 경계가 평행 이동함을 말한다 |
| 로그 손실을 계산한다 | 로그 손실을 직접 계산해 log_loss와 맞추고, 제곱 오차 대신 쓰는 이유를 말한다 |
| 직접 학습한다 | 경사하강법으로 로지스틱 회귀를 NumPy로 구현해 sklearn과 비교한다 |
| 여러 범주를 다룬다 | 소프트맥스로 범주별 확률을 만들고 coef_의 모양을 읽는다 |
| 정규화를 쓴다 | L2·L1의 차이와 C의 방향(작을수록 강함)을 말하고, 검증·교차검증으로 C를 고른다 |
| 스케일링을 지킨다 | 정규화·수렴 때문에 스케일링이 필요한 이유를 말하고 파이프라인으로 묶는다 |
| 선택 기준표에 줄을 더한다 | 선형 분류·정규화를 언제 고르는지 적는다 |
| 실습 노트북 06을 끝낸다 | 실습/문제/ch06_선형_분류와_정규화.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
6-2. 왜 선형 분류부터인가
섹션 제목: “6-2. 왜 선형 분류부터인가”- 분류의 기준선이다. 학습이 빠르고, 하이퍼파라미터가 사실상
C하나이며, 확률을 낸다. 표 데이터 분류에서는 이 모델로 먼저 점수를 내 두고, 더 복잡한 모델(7장 트리·앙상블)이 그 점수를 넘는지 본다. - 설명할 수 있다. 특성마다 계수가 하나라 “어느 특성이 어느 쪽으로 얼마나 밀었나”를 말할 수 있다. 대출 심사처럼 이유를 설명해야 하는 곳에서 쓴다.
- 딥러닝으로 이어진다. 신경망의 분류 층은 “선형 점수 → 시그모이드·소프트맥스 → 교차 엔트로피 손실”이고, 이것이 이 장의 로지스틱 회귀 그대로다(10·11장).
6-3. 선형 점수에서 확률로
섹션 제목: “6-3. 선형 점수에서 확률로”선형 점수 z
섹션 제목: “선형 점수 z”05장과 같은 유방암 데이터(악성 1), 같은 분할, 같은 특성 2개를 쓴다. 표준화한 특성을 Xs_tr·Xs_va라 부른다.
import numpy as npfrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegression
bc = load_breast_cancer(as_frame=True)y = (bc.target == 0).astype(int).to_numpy()                         # 악성 1, 양성 0cols = ["mean texture", "mean smoothness"]X = bc.data[cols].to_numpy()X_tmp, X_te, y_tmp, y_te = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)X_tr, X_va, y_tr, y_va = train_test_split(X_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=0)
scaler = StandardScaler().fit(X_tr)Xs_tr, Xs_va = scaler.transform(X_tr), scaler.transform(X_va)clf = LogisticRegression().fit(Xs_tr, y_tr)w, b = clf.coef_[0], clf.intercept_[0]print(clf.coef_.shape, w.round(3), round(b, 3))
z = Xs_va @ w + b # 04장 선형 회귀와 같은 식print(np.allclose(z, clf.decision_function(Xs_va)), z[:4].round(3))(1, 2) [1.112 1.285] -0.751True [-3.495 -2.256 1.802 -2.289]로지스틱 회귀도 먼저 04장 선형 회귀처럼 선형 점수 를 계산한다. sklearn에서는 decision_function이 이 를 돌려준다. 는 부터 까지 어떤 값이든 될 수 있어서 그대로는 확률이 아니다.
시그모이드
섹션 제목: “시그모이드”이 장부터 지수와 로그가 나온다. 은 자연상수이고, (np.exp(z))는 가 1 늘 때마다 배가 된다. 이 장의 는 밑이 인 자연로그(np.log)이며 의 역함수다. 즉 이고, 라서 곱을 합으로 바꾼다(6-5절 수학 상자).
를 0~1로 눌러 담는 함수가 시그모이드(sigmoid, 로지스틱 함수)다.
def sigmoid(z):    return 1 / (1 + np.exp(-z))
for v in [-6, -2, 0, 2, 6]: print(v, round(sigmoid(v), 3))p_va = sigmoid(z)print(np.allclose(p_va, clf.predict_proba(Xs_va)[:, 1]))-6 0.002-2 0.1190 0.52 0.8816 0.998True- 이면 0.5, 가 클수록 1에, 작을수록 0에 가깝다. 가 ±6만 돼도 거의 0이나 1이다.
- 로지스틱 회귀 = 선형 점수 + 시그모이드.
predict_proba[:, 1]은 그대로다. 그래서 이름에 “회귀”가 남았다. 선형 회귀처럼 점수를 내고, 그 점수를 확률로 바꾼다. - 위
sigmoid는 가 아주 작으면(예: −1000)np.exp(-z)가 넘쳐 경고를 낸다. 실무에서는scipy.special.expit처럼 안정하게 만든 함수를 쓴다(실습 문제 2).
잠깐 확인 (ch06-i01)
아래 코드의 출력은?
import numpy as np
z = np.array([-2.0, 0.0, 3.0])
p = 1 / (1 + np.exp(-z))
print((p >= 0.5).astype(int).tolist(), round(float(p[1]), 2))
[0, 1, 1] 0.5
[0, 0, 1] 0.5
[0, 1, 1] 0.0
[1, 1, 1] 0.5
계수를 오즈로 읽기
섹션 제목: “계수를 오즈로 읽기”확률 대신 오즈(odds) 로 보면 계수가 깔끔해진다. 오즈는 “1일 가능성이 0일 가능성의 몇 배인가”다(이면 4). 시그모이드를 거꾸로 풀면
즉 로그 오즈가 특성의 선형식이다. 이 1 늘면 로그 오즈가 만큼 늘고, 오즈는 배가 된다.
for name, wi in zip(cols, w):    print(f"{name}: 계수 {wi:.3f}, 표준편차 1 증가 → 오즈 {np.exp(wi):.2f}배")
x_mean = np.zeros((1, 2)) # 표준화 공간의 0 = 훈련 평균x_up = np.array([[1.0, 0.0]]) # 질감만 표준편차 1 증가odds = lambda p: p / (1 - p)p0, p1 = clf.predict_proba(x_mean)[0, 1], clf.predict_proba(x_up)[0, 1]print(round(p0, 3), round(p1, 3), round(odds(p1) / odds(p0), 2))mean texture: 계수 1.112, 표준편차 1 증가 → 오즈 3.04배mean smoothness: 계수 1.285, 표준편차 1 증가 → 오즈 3.62배0.321 0.589 3.04- 계수가 양수면 그 특성이 클수록 악성 쪽, 음수면 양성 쪽으로 민다. 두 특성 모두 양수다.
- 특성을 표준화했으므로 계수는 “표준편차 1만큼”의 효과이고, 특성끼리 크기를 비교할 수 있다. 표준화하지 않으면 계수는 원래 단위(질감 1, 매끄러움 0.01 같은) 기준이라 크기 비교가 안 된다.
- 오즈는 늘 같은 배수로 변하지만, 확률이 늘어나는 양은 출발점에 따라 다르다(위에서 0.321 → 0.589, 0.27 늘었다). 확률로 말할 때는 “어디서 출발했나”를 함께 말한다.
- 계수는 다른 특성을 고정했을 때의 효과다. 특성끼리 강하게 얽혀 있으면(예: 반지름과 넓이) 계수의 부호와 크기가 불안정해서 해석에 조심한다. 이것도 정규화가 필요한 이유 중 하나다(6-7절).
잠깐 확인 (ch06-i02)
표준화한 특성으로 학습한 로지스틱 회귀에서 어떤 특성의 계수가 −0.7이다. 다른 특성을 고정하고 이 특성만 표준편차 1만큼 늘리면 어떻게 되는가?
1일 확률이 0.7만큼 줄어든다
1일 확률이 배(약 0.5배)가 된다
오즈가 배(약 0.5배)가 된다
오즈가 0.7만큼 줄어든다
6-4. 결정 경계
섹션 제목: “6-4. 결정 경계”임계값 0.5는 z = 0
섹션 제목: “임계값 0.5는 z = 0”시그모이드는 늘 증가하므로 이다. 특성 2개에서 은 직선이다. 단, 과 가 모두 0이면 가 상수라 경계가 생기지 않는다. 이 직선을 결정 경계(decision boundary)라 한다. 직선 한쪽은 1, 다른 쪽은 0으로 예측한다.
임계값 ()를 쓰면 이다. 오른쪽 값을 로짓(logit)이라 하며 시그모이드의 역함수다. 임계값을 바꾸면 기울기()는 그대로이고 상수만 바뀌므로 경계가 평행 이동한다.
def logit(t):    return np.log(t / (1 - t))
for t in [0.3, 0.5, 0.7]: same = np.array_equal(p_va >= t, z >= logit(t)) print(f"임계값 {t}: z 기준 {logit(t):+.3f}, 같은 예측 {same}, 1 예측 {(z >= logit(t)).sum()}명")임계값 0.3: z 기준 -0.847, 같은 예측 True, 1 예측 58명임계값 0.5: z 기준 +0.000, 같은 예측 True, 1 예측 38명임계값 0.7: z 기준 +0.847, 같은 예측 True, 1 예측 24명← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
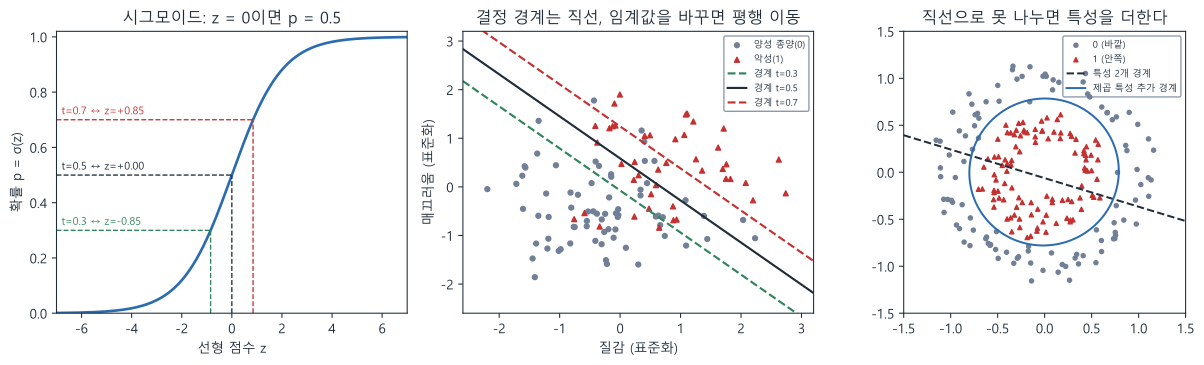
그림 설명. 왼쪽은 가로축 선형 점수 (−7~7), 세로축 확률 (0~1)의 시그모이드 곡선이다. 에서 0.5를 지나고, 점선은 임계값 0.3·0.5·0.7이 −0.85·0·+0.85에 대응함을 보인다. 가운데는 검증 데이터 114명을 질감(가로)과 매끄러움(세로, 둘 다 표준화)으로 찍은 것이다. 양성(0)은 회색 점, 악성(1)은 빨간 삼각형이며 악성이 오른쪽 위에 많다. 오른쪽 아래로 내려가는 평행한 직선 셋이 경계다. 실선이 임계값 0.5, 왼쪽 아래 점선이 0.3, 오른쪽 위 점선이 0.7이다. 오른쪽은 원 데이터의 훈련 210개다. 안쪽 원의 빨간 삼각형이 1, 바깥 고리의 회색 점이 0이다. 원래 특성 2개로 학습한 경계는 가운데를 비스듬히 가르는 점선 직선이고, 제곱 특성을 더한 경계는 안쪽 원을 감싸는, 원에 가까운 파란 타원이다.
- 그림 가운데의 세 직선은 임계값 0.3·0.5·0.7의 경계다. 모두 평행하다. 임계값을 낮추면 경계가 0 쪽으로 밀려 1 영역이 넓어진다(05장에서 재현율이 오른 이유).
- 특성이 3개면 경계는 평면, 그 이상이면 초평면(hyperplane)이다. 특성이 몇 개든 ” = 상수”인 평평한 경계 하나가 공간을 둘로 나눈다. 그래서 선형 분류기(linear classifier)라 부른다.
잠깐 확인 (ch06-i03)
특성 2개 로지스틱 회귀에서 임계값을 0.5에서 0.7로 올리면, 결정 경계 직선의 기울기가 바뀐다.
O / X
직선으로 못 나누면 특성을 더한다
섹션 제목: “직선으로 못 나누면 특성을 더한다”안쪽 원은 1, 바깥 고리는 0인 데이터는 어떤 직선으로도 나눌 수 없다.
from sklearn.datasets import make_circlesfrom sklearn.preprocessing import PolynomialFeatures
Xc, yc = make_circles(n_samples=300, factor=0.5, noise=0.1, random_state=0)c_tr, c_va, yc_tr, yc_va = train_test_split(Xc, yc, test_size=0.3, stratify=yc, random_state=0)lin = LogisticRegression().fit(c_tr, yc_tr)print("원래 특성 2개:", round(lin.score(c_va, yc_va), 3))
poly = PolynomialFeatures(2, include_bias=False).fit(c_tr) # x1, x2, x1², x1·x2, x2²print(poly.get_feature_names_out())quad = LogisticRegression().fit(poly.transform(c_tr), yc_tr)print("제곱 특성 추가:", round(quad.score(poly.transform(c_va), yc_va), 3))원래 특성 2개: 0.433['x0' 'x1' 'x0^2' 'x0 x1' 'x1^2']제곱 특성 추가: 0.978score는 분류에서 정확도다. 직선 경계는 절반도 못 맞혔지만, ·를 더하자 거의 다 맞혔다. 가 0인 곳을 원래 평면에 그리면 이차곡선 경계가 되고, 이 데이터에서는 원에 가까운 타원이 되기 때문이다(그림 맨 오른쪽).- 모델은 여전히 “특성에 대해 선형”이다. 휘어진 경계는 특성을 늘려서 얻었다. 05장 다항 회귀와 같은 방법이다.
- 특성을 늘리면 계수가 많아져 과적합하기 쉽다. 그래서 특성을 늘릴 때는 정규화(6-7절)를 함께 쓴다. 어떤 특성을 만들어야 할지 모르면 트리(7장)나 신경망(10장)처럼 경계 모양을 스스로 찾는 모델을 쓴다.
잠깐 확인 (ch06-i04)
안쪽 원이 1, 바깥 고리가 0인 데이터에서, 원래 특성 2개에 , , 를 더하자 로지스틱 회귀의 정확도가 0.43에서 0.98로 올랐다. 그 이유로 맞는 것은?
다섯 특성을 받은 로지스틱 회귀의 점수 가 더는 그 다섯 특성의 일차식이 아니기 때문이다
는 다섯 특성의 일차식 그대로이고, 을 원래 평면에 그리면 곡선이 되기 때문이다
특성이 늘어나면 sklearn이 정규화를 자동으로 꺼서 계수가 커지기 때문이다
제곱한 값은 모두 양수라서 두 범주의 값이 서로 겹치지 않게 되기 때문이다
6-5. 손실과 학습
섹션 제목: “6-5. 손실과 학습”로그 손실
섹션 제목: “로그 손실”04장 선형 회귀는 평균 제곱 오차를 줄였다. 로지스틱 회귀는 로그 손실(log loss), 다른 이름으로 이진 교차 엔트로피(binary cross-entropy)를 줄인다. 표본 하나의 손실은
- 정답이 1이면 , 정답이 0이면
- 한 줄로:
이고, 전체는 그 평균이다. 정답 쪽에 준 확률이 1에 가까우면 손실이 0에 가깝고, 0에 가까우면 손실이 끝없이 커진다.
from sklearn.metrics import log_loss
for p in [0.99, 0.9, 0.5, 0.1, 0.01]:    print(f"정답 1, p = {p}: 손실 {-np.log(p):.3f}")
def bce(y, p):    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p))
print(round(bce(y_va, p_va), 4), round(log_loss(y_va, p_va), 4))정답 1, p = 0.99: 손실 0.010정답 1, p = 0.9: 손실 0.105정답 1, p = 0.5: 손실 0.693정답 1, p = 0.1: 손실 2.303정답 1, p = 0.01: 손실 4.6050.4044 0.4044- 확신하고 틀릴수록(정답 1에 ) 손실이 크다. 그래서 로그 손실은 정확도와 달리 확률이 얼마나 믿을 만한지까지 잰다. 이 장에서는 정규화의 효과를 볼 때 검증 로그 손실을 쓴다.
- 가 정확히 0이나 1이면 가 된다. sklearn
log_loss는 확률을 아주 작은 값 안쪽으로 잘라(clip) 계산한다. 직접 계산할 때도np.clip(p, 1e-15, 1 - 1e-15)처럼 자른다(실습 문제 4).
잠깐 확인 (ch06-i05)
아래 코드의 출력은? 두 표본 모두 모델이 1일 확률을 0.9로 냈다.
import numpy as np
y = np.array([1, 0])
p = np.array([0.9, 0.9])
loss = -(y * np.log(p) + (1 - y) * np.log(1 - p))
print(loss.round(3).tolist())
[0.105, 0.105]
[0.01, 0.81]
[2.303, 0.105]
[0.105, 2.303]
왜 제곱 오차가 아닌가
섹션 제목: “왜 제곱 오차가 아닌가”시그모이드 출력에 제곱 오차를 쓰면, 확신하고 틀린 표본에서 기울기가 거의 0이 되어 학습이 멈춘다. 에 대한 기울기를 비교해 본다.
for zz in [-4.6, 0.0, 4.6]: # 정답이 1인 표본의 z p = sigmoid(zz) g_mse = 2 * (p - 1) * p * (1 - p) # d(p − 1)² / dz g_log = p - 1 # d(−log p) / dz print(f"z {zz:+.1f}, p {p:.3f}: 제곱 오차 기울기 {g_mse:+.4f}, 로그 손실 기울기 {g_log:+.4f}")z -4.6, p 0.010: 제곱 오차 기울기 -0.0195, 로그 손실 기울기 -0.9900z +0.0, p 0.500: 제곱 오차 기울기 -0.2500, 로그 손실 기울기 -0.5000z +4.6, p 0.990: 제곱 오차 기울기 -0.0002, 로그 손실 기울기 -0.0100정답이 1인데 로 크게 틀린 표본()에서 제곱 오차의 기울기는 −0.02뿐이다. 시그모이드의 기울기 가 곱해져 작아지기 때문이다. 로그 손실은 그 항이 약분되어 기울기가 로 크다. 틀린 만큼 세게 고친다. 또 로그 손실은 에 대해 볼록(convex)이라, 경사하강법이 멈춘 곳(지역 최솟값)이 곧 가장 낮은 곳(전역 최솟값)이다. 다만 최솟값이 하나뿐이라거나 유한한 계수에서 반드시 도달한다는 보장은 아니다. 특성이 중복되면 다른 계수가 같은 손실을 낼 수 있고, 데이터가 직선으로 완전히 나뉘면 계수가 끝없이 커진다(6-7절).
경사하강법으로 직접 학습
섹션 제목: “경사하강법으로 직접 학습”로그 손실의 기울기는 04장 선형 회귀와 모양이 같다. 예측이 에서 로 바뀌었을 뿐이다.
def fit_logistic(X, y, lr=0.5, steps=3000):    w, b = np.zeros(X.shape[1]), 0.0    for _ in range(steps):        p = sigmoid(X @ w + b)        w -= lr * X.T @ (p - y) / len(y)        b -= lr * np.mean(p - y)    return w, b
w_gd, b_gd = fit_logistic(Xs_tr, y_tr)ref = LogisticRegression(C=np.inf).fit(Xs_tr, y_tr) # 정규화 없음print(w_gd.round(4), round(b_gd, 4))print(ref.coef_[0].round(4), round(ref.intercept_[0], 4))print("훈련 로그 손실", round(bce(y_tr, sigmoid(Xs_tr @ w_gd + b_gd)), 4))[1.1568 1.3396] -0.7668[1.1565 1.3396] -0.7668훈련 로그 손실 0.4714- 정규화를 끈(
C=np.inf) sklearn 결과와 계수 차이가 0.001 미만이다. sklearn은 같은 손실을 경사하강법보다 빠른 방법(기본lbfgs)으로 줄일 뿐이다. - 6-3절의
clf(기본C=1.0)와 계수가 조금 다른 것은 기본값에 L2 정규화가 들어 있기 때문이다(6-7절). - 예전 코드의
penalty인자(penalty=None,penalty="l1"등)는 scikit-learn 1.8부터 사용 중단(deprecated) 경고가 나고 1.10에서 없어질 예정이다. 정규화를 끌 때는penalty=None대신C=np.inf, L1은l1_ratio=1을 쓴다. 이 자료는 1.9.0 기준으로C와l1_ratio만 쓴다.
잠깐 확인 (ch06-i06)
04장의 선형 회귀 경사하강법 코드를 로지스틱 회귀(로그 손실)용으로 바꾸려 한다. 기울기 계산에서 바꿔야 하는 것은?
갱신할 때마다 를 0과 1 사이로 잘라 확률 범위를 지킨다
오차 자리에 들어가는 예측 를 로 바꾼다
기울기에 시그모이드의 미분 를 한 번 더 곱한다
기울기의 부호를 바꿔 손실이 커지는 쪽으로 움직인다
수학 상자: 시그모이드와 로그우도
섹션 제목: “수학 상자: 시그모이드와 로그우도”시그모이드의 성질. 이고, 미분은 이다. 미분이 가장 큰 곳은 (값 0.25)이고 가 크면 0에 가깝다. 앞의 제곱 오차 기울기에 붙은 가 이것이다.
로그우도에서 로그 손실로. 모델이 표본 에 정답 를 낼 확률은 이다(이면 , 0이면 ). 표본이 서로 독립이면 데이터 전체가 나올 확률, 즉 우도(likelihood)는 이것들의 곱이다. 우도를 가장 크게 하는 를 고르는 것이 최대우도 추정(maximum likelihood estimation)이다. 곱은 다루기 어려우니 로그를 씌워 합(로그우도)으로 만들고, 부호를 바꿔 평균하면 로그 손실이 된다.
p_tr = sigmoid(Xs_tr @ w_gd + b_gd)lik = np.prod(np.where(y_tr == 1, p_tr, 1 - p_tr)) # 우도: 정답 쪽 확률의 곱loglik = np.sum(y_tr * np.log(p_tr) + (1 - y_tr) * np.log(1 - p_tr)) # 로그우도: 로그의 합print(f"{lik:.3e}", round(np.log(lik), 3), round(loglik, 3), round(-loglik / len(y_tr), 4))1.526e-70 -160.759 -160.759 0.4714- 우도는 0에 아주 가까운 수라 표본이 더 많으면 컴퓨터가 0으로 처리한다(언더플로). 로그를 씌우면 −160.8 같은 다룰 만한 수가 된다.
- −로그우도 / N이 앞의 훈련 로그 손실과 같다. 로그 손실을 줄이기 = 우도를 키우기다. 10장 이후 딥러닝의 분류 손실도 같은 원리다.
6-6. 범주가 셋 이상일 때: 소프트맥스
섹션 제목: “6-6. 범주가 셋 이상일 때: 소프트맥스”범주가 개면 범주마다 선형 점수 를 계산하고, 소프트맥스(softmax)로 합이 1인 확률로 바꾼다.
붓꽃(iris) 데이터(특성 4개, 품종 3개)로 확인한다.
from sklearn.datasets import load_iris
iris = load_iris()Xi_tr, Xi_va, yi_tr, yi_va = train_test_split(iris.data, iris.target, test_size=0.3, stratify=iris.target, random_state=0)sc_i = StandardScaler().fit(Xi_tr)multi = LogisticRegression().fit(sc_i.transform(Xi_tr), yi_tr)print(multi.classes_, multi.coef_.shape, multi.intercept_.shape)
Zi = multi.decision_function(sc_i.transform(Xi_va)) # (N, 3): 범주별 점수P = np.exp(Zi) / np.exp(Zi).sum(axis=1, keepdims=True)print(np.allclose(P, multi.predict_proba(sc_i.transform(Xi_va))), P[:2].round(3))print(np.array_equal(P.argmax(axis=1), multi.predict(sc_i.transform(Xi_va))), round(multi.score(sc_i.transform(Xi_va), yi_va), 3))[0 1 2] (3, 4) (3,)True [[0. 0.036 0.964] [0.001 0.234 0.764]]True 0.978coef_의 모양이(범주 수, 특성 수)다. 범주마다 자기 점수를 내는 선형식이 하나씩 있다. 이진 분류는(1, 특성 수)하나뿐이었다(1의 점수만 계산하고 0은 ).- 예측은 확률이 가장 큰 범주다(
argmax). 소프트맥스는 순서를 바꾸지 않으므로 점수 가 가장 큰 범주와 같다. 손실은 정답 범주 확률의 −log, 즉 교차 엔트로피(cross-entropy)다. 이진 로그 손실은 그 인 경우다. - 소프트맥스는 14장 어텐션과 16장 LLM의 다음 토큰 확률에 다시 나온다. 큰 점수에서 넘침을 막는 계산법은 그때 다룬다.
잠깐 확인 (ch06-i07)
범주 5개, 특성 8개인 데이터로 LogisticRegression을 학습했다. coef_.shape은 ____이다. (파이썬 튜플 표기로 쓴다)
답: ________________
6-7. 정규화
섹션 제목: “6-7. 정규화”큰 계수와 과적합 위험
섹션 제목: “큰 계수와 과적합 위험”정규화 없이 학습하면 모델은 훈련 데이터의 로그 손실을 끝까지 줄이려 한다. 특성이 많으면 계수를 크게 키워 훈련 데이터의 잡음이나 우연한 패턴까지 맞히고, 데이터가 직선으로 완전히 나뉘면 계수가 끝없이 커진다(확률을 0과 1로 밀어붙이려고). 그러면 처음 보는 데이터에서 확신하고 틀리는 일이 늘어 검증 손실이 커질 수 있다. 계수가 크다는 것만으로 과적합이라 단정하지는 않는다. 과적합인지는 검증 결과로 판단한다.
정규화(regularization)는 손실에 계수 크기에 대한 벌점을 더한다.
| 이름 | 벌점 | 효과 | sklearn |
|---|---|---|---|
| L2(릿지, ridge) | 계수 제곱합 | 계수 전체의 크기를 0 쪽으로 누른다. 개별 계수가 모두 같은 비율로 줄지는 않는다 | 기본값(l1_ratio=0) |
| L1(라쏘, lasso) | 계수 절댓값 합 | 쓸모 적은 계수를 정확히 0으로 만든다 | l1_ratio=1, solver="liblinear" 또는 "saga" |
sklearn은 “C × (로그 손실 합) + 벌점”을 줄인다. 그래서 C는 정규화 강도의 역수다. C가 작을수록 벌점이 상대적으로 커져 정규화가 강하고, C=np.inf면 정규화가 없다. 절편 에는 벌점을 주지 않는다(liblinear는 예외, 아래 참고).
C에 따른 변화
섹션 제목: “C에 따른 변화”특성 30개 전부를 쓴다. 05장 5-8절처럼 30개면 거의 다 맞히지만, 정규화를 아주 약하게 하면 검증에서 무너지는 모습을 본다.
X30 = bc.data.to_numpy()X30_tmp, X30_te, _, _ = train_test_split(X30, y, test_size=0.2, stratify=y, random_state=0)X30_tr, X30_va, _, _ = train_test_split(X30_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=0)   # 같은 환자 분할sc30 = StandardScaler().fit(X30_tr)A_tr, A_va = sc30.transform(X30_tr), sc30.transform(X30_va)
print(" C |w|합 훈련손실 검증손실 검증정확도 L1 0 아닌 계수")for C in [0.01, 0.1, 1, 10, 100, 10000]: m2 = LogisticRegression(C=C, max_iter=5000).fit(A_tr, y_tr) m1 = LogisticRegression(C=C, l1_ratio=1, solver="liblinear", random_state=0).fit(A_tr, y_tr) pt, pv = m2.predict_proba(A_tr)[:, 1], m2.predict_proba(A_va)[:, 1] print(f"{C:>5g} {np.abs(m2.coef_).sum():6.1f} {log_loss(y_tr, pt):8.3f} {log_loss(y_va, pv):8.3f}" f" {m2.score(A_va, y_va):9.3f} {np.count_nonzero(m1.coef_):8d}") C |w|합 훈련손실 검증손실 검증정확도 L1 0 아닌 계수 0.01 3.6 0.189 0.169 0.947 2 0.1 8.1 0.094 0.076 0.982 8 1 15.8 0.056 0.043 0.991 16 10 39.8 0.033 0.053 0.982 24 100 112.1 0.014 0.128 0.947 2310000 507.2 0.001 0.747 0.930 30← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
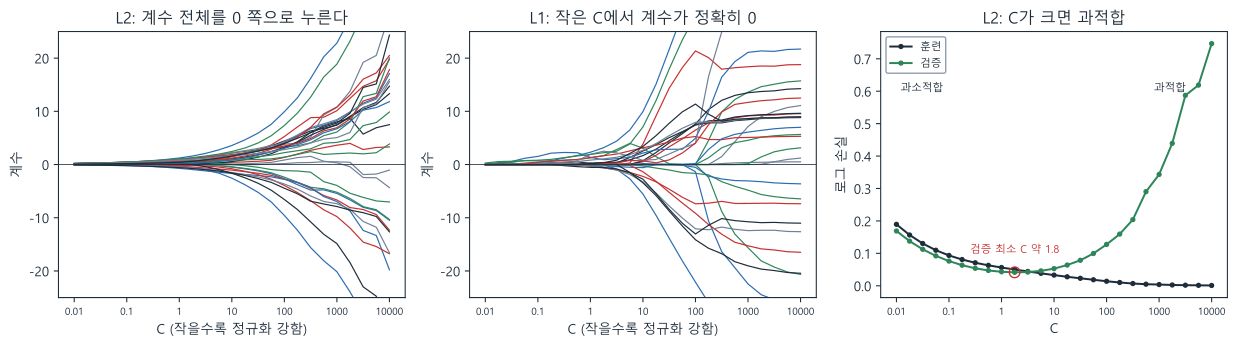
그림 설명. 세 그림 모두 가로축이 C(0.01~10000, 로그 눈금)다. 왼쪽은 L2, 가운데는 L1에서 특성 30개의 계수(세로, −25~25)가 C에 따라 어떻게 변하는지 선 30개로 그렸다. L2는 작은 C에서 모든 계수가 0 근처에 모여 있다가 C가 커지면서 함께 벌어지고, 큰 C에서는 일부가 세로 범위 밖으로 나간다. L1은 작은 C에서 대부분의 선이 정확히 0에 붙어 있고, C가 커지면서 0에서 떨어지는 선이 늘어난다. 오른쪽은 L2 모델의 로그 손실(세로)이다. 훈련 손실(흰색·검은색 선)은 C가 커질수록 0까지 계속 내려간다. 검증 손실(초록)은 C 약 1.8에서 약 0.04로 가장 낮고(빨간 원), 그 뒤로 올라가 C 10000에서 약 0.75가 된다. 왼쪽 끝에는 “과소적합”, 오른쪽 끝에는 “과적합”이라고 적었다.
C를 키울수록(정규화를 약하게) 계수 크기의 합이 커지고 훈련 손실은 계속 줄어든다. 05장의 다항식 차수처럼C도 모델 복잡도의 손잡이다.- 검증 손실은
C=1근처에서 가장 작고,C=10000에서는 훈련 손실이 거의 0인데 검증 손실이 크게 늘었다. 과적합이다.C=0.01은 계수를 너무 눌러 훈련·검증 모두 손실이 크다. 과소적합이다. - L1은
C가 작을수록 0인 계수가 대체로 많다.C=0.01에서 30개 중 2개만 남았다. 남은 특성만 봐도 되므로 특성 선택과 해석에 쓴다.liblinear는 계산 순서에 난수를 쓰므로random_state를 고정해야 0 아닌 계수의 개수가 실행마다 같다(고정하지 않았을 때 이 PC에서 7과 8이 번갈아 나왔다). 특성끼리 얽혀 있으면 L1은 그중 하나만 남기고 나머지를 0으로 만드는 경향이 있어서, 어느 것이 남았는지를 “중요한 특성 목록”으로 단정하지는 않는다. solver="liblinear"는 절편에도 벌점을 준다(intercept_scaling으로 조절). 표준화해도 이 벌점은 없어지지 않고, 정규화가 강할수록(C가 작을수록) 절편이 0 쪽으로 눌려 확률이 달라질 수 있다. 이 장에서는 0이 되는 계수 개수를 보는 L1 예시에만 쓴다. 절편에 벌점이 없는 L1이 필요하면solver="saga"를 쓰되, 수렴이 느리므로max_iter를 늘린다.
잠깐 확인 (ch06-i08)
표준화한 특성으로 LogisticRegression을 학습하면서 C를 1에서 0.01로 바꿨다. 일어나는 일로 맞는 것은?
정규화가 약해져 계수 크기의 합이 커진다
정규화가 강해져 훈련 로그 손실이 줄어든다
L1이면 0인 계수가 대체로 늘고, L2면 계수 전체의 크기가 0 쪽으로 눌린다
어떤 solver를 쓰든 절편까지 0 쪽으로 눌려 확률이 0.5에 가까워진다
C 고르기
섹션 제목: “C 고르기”C는 학습이 정하지 않는 하이퍼파라미터다. 05장의 규칙대로 검증 데이터나 교차검증으로 고른다. 로그 간격(0.01, 0.1, 1, …)으로 후보를 둔다. 결과가 10배씩 달라지는 손잡이이기 때문이다.
from sklearn.pipeline import make_pipelinefrom sklearn.model_selection import StratifiedKFold, cross_val_score
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)for C in [0.01, 0.1, 1, 10, 100]: pipe = make_pipeline(StandardScaler(), LogisticRegression(C=C, max_iter=5000)) s = -cross_val_score(pipe, X30_tmp, y_tmp, cv=cv, scoring="neg_log_loss") print(f"C {C:>5g}: 교차검증 로그 손실 {s.mean():.3f} ± {s.std(ddof=1):.3f}")C 0.01: 교차검증 로그 손실 0.190 ± 0.027C 0.1: 교차검증 로그 손실 0.101 ± 0.030C 1: 교차검증 로그 손실 0.088 ± 0.055C 10: 교차검증 로그 손실 0.147 ± 0.117C 100: 교차검증 로그 손실 0.308 ± 0.178- 훈련+검증 455명(
X30_tmp)에서 5-겹 교차검증을 했다. 스케일러는 파이프라인 안에 있어 조각마다 훈련 부분으로만fit된다(05장 5-9절). C0.1~1이 가장 좋고, 둘의 차이는 조각 간 흔들림보다 작다. 이럴 때는 더 단순한 쪽(정규화가 강한 작은C)을 고르는 것도 합리적이다.scoring을 무엇으로 하느냐에 따라 고른C가 달라질 수 있다. 확률 자체를 쓸 거면 로그 손실, 순위만 쓸 거면 AUC, 정해진 채점 지표가 있으면 그 지표로 고른다.LogisticRegressionCV는 이 반복을 내장한 클래스다. 쓰는 법은 9장 하이퍼파라미터 탐색에서GridSearchCV와 함께 다룬다.
잠깐 확인 (ch06-i09)
5-겹 교차검증에서 C=0.1과 C=1의 평균 로그 손실 차이가 조각 간 흔들림(표준편차)보다 작다. 이때는 평균이 조금이라도 낮은 쪽을 반드시 골라야 한다.
O / X
6-8. 스케일링이 왜 필요한가
섹션 제목: “6-8. 스케일링이 왜 필요한가”정규화는 단위를 탄다
섹션 제목: “정규화는 단위를 탄다”벌점 은 모든 계수를 같은 잣대로 누른다. 그런데 계수의 크기는 특성의 단위에 달려 있다. 넓이를 mm² 대신 100배 큰 단위로 적으면 값이 1/100로 작아지고, 같은 효과를 내려면 계수는 100배 커져야 한다. 그러면 벌점도 커져 그 특성만 더 세게 눌린다. 단위만 바꿨는데 모델이 달라진다.
area = list(bc.feature_names).index("mean area")X30_tr_u, X30_va_u = X30_tr.copy(), X30_va.copy()X30_tr_u[:, area] /= 100                                            # 같은 정보, 단위만 바꿈X30_va_u[:, area] /= 100
raw_a = LogisticRegression(max_iter=10000).fit(X30_tr, y_tr).predict_proba(X30_va)[:, 1]raw_b = LogisticRegression(max_iter=10000).fit(X30_tr_u, y_tr).predict_proba(X30_va_u)[:, 1]pipe_a = make_pipeline(StandardScaler(), LogisticRegression()).fit(X30_tr, y_tr).predict_proba(X30_va)[:, 1]pipe_b = make_pipeline(StandardScaler(), LogisticRegression()).fit(X30_tr_u, y_tr).predict_proba(X30_va_u)[:, 1]print("스케일링 없음: 확률 최대 차이", round(np.abs(raw_a - raw_b).max(), 3))print("표준화 후 : 확률 최대 차이", round(np.abs(pipe_a - pipe_b).max(), 6))스케일링 없음: 확률 최대 차이 0.132표준화 후 : 확률 최대 차이 0.0표준화하면 어떤 단위로 적었든 평균 0·표준편차 1이 되므로 같은 모델이 나온다. 정규화를 쓰는 선형 모델에는 스케일링이 사실상 필수다. sklearn 로지스틱 회귀는 기본이 L2 정규화이므로, 아무 설정 없이 써도 이 문제가 생긴다.
잠깐 확인 (ch06-i10)
기본 설정(L2 정규화)의 LogisticRegression을 스케일링 없이 쓴다. 한 특성의 단위만 mm에서 cm로 바꿔(값이 1/10) 다시 학습하면 어떻게 되는가?
계수가 단위에 맞게 10배로 바뀌므로 예측 확률은 그대로다
정규화를 쓰지 않을 때만 단위가 예측에 영향을 준다
표준화를 해도 단위를 바꾸면 모델이 달라진다
그 특성에 걸리는 벌점의 영향이 달라져 예측 확률이 바뀔 수 있다
수렴도 느려진다
섹션 제목: “수렴도 느려진다”특성 크기가 제각각이면 손실 곡면이 한 방향으로 길게 늘어나 최적화가 오래 걸린다(04장 학습률 실험에서 걸음이 바닥 양쪽을 오가던 것과 같은 현상).
import warningsfrom sklearn.exceptions import ConvergenceWarning
with warnings.catch_warnings(record=True) as caught: warnings.simplefilter("always") raw = LogisticRegression().fit(X30_tr, y_tr) # 기본 max_iter=100print("스케일링 없음:", raw.n_iter_, [c.category.__name__ for c in caught], round(raw.score(X30_va, y_va), 3))scaled = make_pipeline(StandardScaler(), LogisticRegression()).fit(X30_tr, y_tr)print("표준화 후 :", scaled[-1].n_iter_, round(scaled.score(X30_va, y_va), 3))스케일링 없음: [100] ['ConvergenceWarning'] 0.965표준화 후 : [18] 0.991- 표준화하지 않으면 반복 100번 안에 끝나지 못해
ConvergenceWarning이 나고, 덜 학습된 모델의 정확도도 낮다. 표준화하면 20번 안쪽에서 끝난다. - 이 경고가 나면 먼저 스케일링을 확인한다.
max_iter만 키워 경고를 없애면 단위 때문에 생긴 정규화 차이는 그대로 남는다. 스케일링한 뒤에도 반복 상한에 걸리면 그때max_iter를 늘려 수렴하는지 본다. - 스케일러는 05장 규칙대로 훈련 데이터로만
fit한다.make_pipeline(StandardScaler(), LogisticRegression(...))으로 묶으면 교차검증·예측에서도 자동으로 지켜진다. 05장에서 이 묶음을 쓴 이유다.
잠깐 확인 (ch06-i11)
원래 단위 그대로의 특성 30개로 LogisticRegression().fit(...)을 했더니 ConvergenceWarning이 났다. 먼저 할 일로 가장 알맞은 것은?
max_iter를 크게 늘려 경고가 사라지게 한다특성을 표준화했는지 확인하고, 파이프라인 안에
StandardScaler를 넣는다경고는 무시한다. 반복 횟수만 다르고 결과는 같다
C=np.inf로 정규화를 꺼서 계산을 단순하게 한다
6-9. 선형 회귀의 정규화: 릿지와 라쏘
섹션 제목: “6-9. 선형 회귀의 정규화: 릿지와 라쏘”같은 벌점을 04장 선형 회귀에 붙이면 릿지(Ridge, L2)와 라쏘(Lasso, L1)가 된다. 여기서는 강도 손잡이가 alpha이고 클수록 강하다. 로지스틱 회귀의 C와 방향이 반대다.
from sklearn.datasets import load_diabetesfrom sklearn.linear_model import LinearRegression, Ridge, Lasso
dia = load_diabetes()Xd = StandardScaler().fit_transform(dia.data) # 계수 크기만 비교하는 예라 전체로 표준화print("선형 회귀 |w|합", round(np.abs(LinearRegression().fit(Xd, dia.target).coef_).sum(), 1))for a in [0.1, 1, 10]: r, l = Ridge(alpha=a).fit(Xd, dia.target), Lasso(alpha=a).fit(Xd, dia.target) print(f"alpha {a:>4}: 릿지 |w|합 {np.abs(r.coef_).sum():6.1f} / 라쏘 0 아닌 계수 {np.count_nonzero(l.coef_)}개")선형 회귀 |w|합 164.6alpha 0.1: 릿지 |w|합 162.0 / 라쏘 0 아닌 계수 9개alpha 1: 릿지 |w|합 143.7 / 라쏘 0 아닌 계수 7개alpha 10: 릿지 |w|합 105.0 / 라쏘 0 아닌 계수 4개alpha를 키우면 릿지는 계수 크기를 전체적으로 줄이고, 라쏘는 0인 계수를 늘린다. 로지스틱 회귀의 L2·L1과 같은 모습이다.- 이 코드는 평가 없이 계수 모양만 보려고 전체 데이터로 표준화했다. 점수를 잴 때는 05장처럼 나눈 뒤 훈련 데이터로만
fit한다. - 이름 정리: “정규화 강도”를 sklearn은 로지스틱 회귀·SVM에서는
C(역수, 작을수록 강함), 릿지·라쏘에서는alpha(클수록 강함)로 받는다. 신경망에서도 계수(가중치)를 작게 누르는 가중치 감쇠(weight decay)를 쓴다(11장). 기본 경사하강법에서는 L2 벌점을 더하는 것과 같은 효과지만, AdamW 같은 일부 최적화 방법의 가중치 감쇠는 L2 벌점과 계산이 달라 구별한다.
잠깐 확인 (ch06-i12)
Ridge에서 alpha를 키우는 것은 LogisticRegression에서 C를 줄이는 것과 같은 방향, 즉 정규화를 강하게 하는 쪽이다.
O / X
6-10. 선형 분류를 언제 쓰나
섹션 제목: “6-10. 선형 분류를 언제 쓰나”| 상황 | 선형 분류(로지스틱 회귀) | 다른 선택 |
|---|---|---|
| 표 데이터, 처음 시작 | 기준선으로 먼저 세운다 | 7장 트리·앙상블과 비교 |
| 이유를 설명해야 한다(대출·의료) | 계수·오즈로 설명. L1로 특성을 줄이면 더 쉽다 | 트리 하나(7장) |
| 표본보다 특성이 많다(텍스트 단어 수만 개) | 정규화한 선형 모델이 강하다 | |
| 경계가 휘었다, 특성 사이 상호작용이 크다 | 특성을 직접 만들어야 한다(제곱·곱) | 트리·앙상블(7장), 신경망(10장) |
| 이미지·소리·문장 원본 | 원본 픽셀에는 약하다 | CNN·트랜스포머(12·14장). 사전학습 모델이 뽑은 특성 + 로지스틱 헤드(15장) |
| 잘 맞는 확률이 필요하다 | 로그 손실로 학습해 확률이 대체로 무난하다(검증에서 확인) |
15장에서 사전학습 모델이 뽑은 특성 위에 얹는 “가벼운 분류기”도 이 장의 로지스틱 회귀다.
6-11. 선택 기준표에 추가
섹션 제목: “6-11. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 표 데이터 분류를 시작한다 | make_pipeline(StandardScaler(), LogisticRegression())으로 기준선 |
빠르고 확률을 내며 계수로 설명할 수 있다. 더 복잡한 모델은 이 점수를 넘어야 한다 | 06 |
| 선형 모델에 정규화를 쓴다 | 먼저 스케일링(파이프라인 안), C·alpha는 로그 간격 후보를 교차검증으로 |
벌점이 단위를 타고, 강도는 10배 단위로 효과가 달라진다 | 06 |
| 특성이 많고 쓸모 있는 것은 일부다 | L1(l1_ratio=1) 또는 라쏘 |
쓸모 적은 계수를 0으로 만들어 특성을 고르고 해석을 쉽게 한다 | 06 |
| 경계가 직선이 아니다 | 특성 추가(제곱·곱) + 정규화, 또는 트리·신경망 | 선형 모델은 특성에 대해서만 선형이다 | 06 |
확인 문제
섹션 제목: “확인 문제”문제 1 (ch06-e01)
계수가 , 절편이 인 로지스틱 회귀에 을 넣는다. 아래 코드의 출력은?
import numpy as np
w, b = np.array([2.0, -1.0]), 0.5
x = np.array([1.0, 3.0])
z = x @ w + b
print(z, round(1 / (1 + np.exp(-z)), 3))
0.5 0.622
-1.5 0.182
-0.5 0.378
-0.5 0.622
문제 2 (ch06-e02)
표준화한 두 특성 A, B로 학습한 로지스틱 회귀의 계수가 A 1.2, B −0.3이다. 옳은 해석은?
B를 고정하고 A만 표준편차 1 늘리면 오즈가 약 3.3배가 된다
A만 표준편차 1 늘리면 1일 확률이 1.2배가 된다
B는 값이 클수록 1 쪽으로 민다
A와 B가 강하게 얽혀 있어도 계수의 부호는 그대로 믿을 수 있다
문제 3 (ch06-e03)
특성 2개 로지스틱 회귀의 계수가 , , 절편이 다. 임계값 0.5의 결정 경계가 인 세로축과 만나는 점의 값은 ____이다.
답: ________________
문제 4 (ch06-e04)
두 모델 A, B가 같은 표본들을 모두 맞혔다(정확도가 같다). 모든 표본에서 각각 A가 정답 쪽에 준 확률이 B보다 낮다면, A의 로그 손실이 B보다 크다.
O / X
문제 5 (ch06-e05)
시그모이드 출력으로 학습할 때 제곱 오차 대신 로그 손실을 쓰는 이유로 맞는 것은?
제곱 오차는 정답이 0과 1뿐인 데이터에는 계산할 수 없다
확신하고 틀린 표본에서 제곱 오차의 기울기는 거의 0이 되지만, 로그 손실의 기울기는 로 크게 남는다
로그 손실은 볼록이라 최솟값이 하나뿐이고, 유한한 계수에서 반드시 도달한다
로그 손실은 확률을 0과 1로 반올림한 뒤 계산해 학습이 안정된다
문제 6 (ch06-e06)
아래 코드의 출력은?
import numpy as np
y = np.array([1, 0, 1])
p = np.array([0.8, 0.4, 0.5])
lik = np.prod(np.where(y == 1, p, 1 - p))
print(round(lik, 3), round(-np.log(lik) / len(y), 3))
0.16 0.611
0.24 1.427
0.76 0.091
0.24 0.476
문제 7 (ch06-e07)
범주 3개 로지스틱 회귀가 한 표본에 낸 점수(decision_function)가 다. 옳은 것은?
예측은 두 번째 범주다
점수에 음수가 있으므로 소프트맥스 확률의 합은 1보다 작다
세 번째 범주의 확률은 정확히 0이다
첫째와 둘째 범주의 확률 비는 점수 비와 같은 1 대 2다
문제 8 (ch06-e08)
특성 30개 L2 로지스틱 회귀에서 C=1의 훈련·검증 로그 손실은 0.056·0.043, C=10000은 0.001·0.747이었다. 옳은 해석은?
C=10000은 정규화가 너무 강해서 생긴 과소적합이다훈련 손실이 가장 낮은
C=10000을 고른다C=10000은 정규화가 거의 없어 과적합이고, 검증 손실이 작은C=1근처가 낫다두 설정의 검증 정확도가 모두 0.9를 넘으므로 어느 쪽이든 상관없다
문제 9 (ch06-e09)
L1 정규화 로지스틱 회귀에서 0이 아닌 계수로 남은 특성들은 그 데이터의 "중요한 특성 목록"이라고 단정해도 된다.
O / X
문제 10 (ch06-e10)
아래 코드의 출력은? 둘째 열은 첫째 열의 단위만 100배 큰 단위로 바꾼 것이다.
import numpy as np
from sklearn.preprocessing import StandardScaler
a = np.array([[100.0], [200.0], [300.0]])
print(StandardScaler().fit_transform(a).ravel().round(3).tolist(),
      StandardScaler().fit_transform(a / 100).ravel().round(3).tolist())
[-1.225, 0.0, 1.225] [-1.225, 0.0, 1.225]
[-1.225, 0.0, 1.225] [-0.012, 0.0, 0.012]
[-1.0, 0.0, 1.0] [-1.0, 0.0, 1.0]
[-100.0, 0.0, 100.0] [-1.0, 0.0, 1.0]
문제 11 (ch06-e11)
고객 이탈 여부를 맞히는 표 데이터 분류를 새로 시작한다. 특성은 40개이고, 결과의 이유를 설명해야 한다. 첫 모델로 가장 알맞은 것은?
LogisticRegression(C=np.inf)로 정규화를 끄고, 원래 단위의 계수 크기를 서로 비교해 설명한다make_pipeline(StandardScaler(), LogisticRegression(l1_ratio=1, solver="liblinear"))의 남은 특성을 중요 특성으로 보고한다40개 특성의 제곱·곱 특성을 모두 더한 뒤 정규화 없이 학습해 휘어진 경계까지 잡는다
make_pipeline(StandardScaler(), LogisticRegression())으로 기준선을 세우고C를 교차검증으로 고른다
6-12. 실습과 문제
섹션 제목: “6-12. 실습과 문제”실습/문제/ch06_선형_분류와_정규화.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 시그모이드·로지스틱 회귀 참/거짓 |
| 2 | 코드 | 넘침 없는 시그모이드 |
| 3 | 코드 | coef_·intercept_로 predict_proba 직접 계산 |
| 4 | 코드 | 로그 손실 직접 계산(확률 자르기 포함) |
| 5 | 코드 | 경사하강법 로지스틱 회귀(L2 포함) |
| 6 | 코드 | 임계값별 결정 경계 직선 |
| 7 | 코드 | 교차검증으로 C 고르기 |
| 8 | 개념 | 정규화·스케일링 참/거짓 |
| 9 | 사례 | 계수 해석이 이상한 대출 모델 진단 |
| 10 | 사례 | 상황별 모델·설정 고르기 |
6-13. 공식 문서와 참고 자료
섹션 제목: “6-13. 공식 문서와 참고 자료”- 로지스틱 회귀(사용자 안내서): https://scikit-learn.org/stable/modules/linear_model.html#logistic-regression
LogisticRegression: https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LogisticRegression.htmlRidge: https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.Ridge.htmlLasso: https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.Lasso.htmllog_loss: https://scikit-learn.org/stable/modules/generated/sklearn.metrics.log_loss.html- L1 정규화 경로 예제: https://scikit-learn.org/stable/auto_examples/linear_model/plot_logistic_path.html
- 스케일링의 중요성: https://scikit-learn.org/stable/auto_examples/preprocessing/plot_scaling_importance.html
scipy.special.expit: https://docs.scipy.org/doc/scipy/reference/generated/scipy.special.expit.htmlmake_circles: https://scikit-learn.org/stable/modules/generated/sklearn.datasets.make_circles.html