실무 데이터는 대부분 표로 온다. 표는 열마다 이름과 자료형이 다르고, 빈칸이 있고, 도시 이름 같은 문자열이 섞여 있고, 정보가 여러 표에 나뉘어 있다. 이 장에서는 pandas로 표를 읽고, 고르고, 고치고, 합쳐서 02장의 (표본 수, 특성 수) 숫자 배열로 만드는 과정을 익힌다. 그 과정에서 오류 없이 틀린 답을 만드는 함정(위치와 이름표 혼동, 연쇄 대입, 처음 보는 범주, 키 중복 병합)을 하나씩 확인한다.
3-1. 이 장의 목표와 완료 기준
섹션 제목: “3-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 표의 구조를 읽는다 | shape·dtypes·isna().sum()으로 열마다 자료형과 결측 수를 확인한다 |
| index(이름표)와 위치를 구분한다 | 정렬·필터 뒤 loc·iloc·idxmax·argmax의 결과를 실행 전에 맞힌다 |
| 행을 고르고 값을 바꾼다 | 조건 여러 개로 행을 고르고, loc 한 번으로 값을 바꾼다(연쇄 대입을 쓰지 않는다) |
| 결측을 처리한다 | 삭제·대체·결측 표시 중에서 고르고, 대체값은 훈련 데이터에서만 구한다 |
| 기술 통계를 읽는다 | 평균·중앙값·표준편차·분위수를 구하고, 이상치가 각각에 주는 영향을 말한다 |
| 범주를 숫자로 바꾼다 | 원-핫과 정수 인코딩의 차이, 정수가 만드는 순서 가정, 처음 보는 범주 처리를 설명하고 코드로 쓴다 |
| 표를 묶고 합친다 | groupby로 집계하고, merge 전후 행 수·합계를 확인한다 |
| 그림으로 데이터를 본다 | 히스토그램·상자 그림·산점도로 분포·이상치·관계를 확인한다 |
| 선택 기준표에 줄을 더한다 | 결측·범주·병합 상황에서 고를 방법과 이유를 적는다 |
| 실습 노트북 03을 끝낸다 | 실습/문제/ch03_표_데이터_다루기_pandas.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
3-2. 왜 pandas인가
섹션 제목: “3-2. 왜 pandas인가”02장의 NumPy 배열은 원소 전체가 dtype 하나다. 그런데 고객 표에는 정수(방문 수), 실수(키), 문자열(도시)이 함께 있다. pandas의 DataFrame은 이런 표를 담는다.
- 열마다 이름과 자료형이 따로 있다.
- 행마다 index(이름표)가 붙는다. 정렬하거나 걸러도 이름표는 행을 따라간다.
- 결측 확인, 조건 필터, 그룹 집계, 표 합치기, 그림 그리기를 짧은 코드로 한다.
scikit-learn 모델도 DataFrame을 받지만, 결국 안에서는 숫자 배열로 계산한다. 그래서 이 장의 끝은 언제나 “숫자만 남은 (N, d) 표”다(3-10절).
3-3. DataFrame의 기본
섹션 제목: “3-3. DataFrame의 기본”이 장은 아래 고객 표 하나로 시작한다.
import numpy as npimport pandas as pd
customers = pd.DataFrame({ "고객ID": [101, 102, 103, 104, 105, 106], "도시": ["서울", "부산", "서울", "대구", "부산", "서울"], "등급": ["실버", "골드", "브론즈", "실버", "브론즈", "골드"], "나이": [34, None, 27, 45, 52, None], "방문수": [12, 30, 3, 8, 5, 41],})print(customers)print(customers.shape)print(customers.dtypes) 고객ID 도시 등급 나이 방문수0 101 서울 실버 34.0 121 102 부산 골드 NaN 302 103 서울 브론즈 27.0 33 104 대구 실버 45.0 84 105 부산 브론즈 52.0 55 106 서울 골드 NaN 41(6, 5)고객ID int64도시 str등급 str나이 float64방문수 int64dtype: object- 표의 한 줄이 표본(고객 한 명), 한 열이 특성이다.
shape는(행 수, 열 수)다. - 왼쪽 끝 0~5가 index다. 따로 정하지 않으면 0부터 붙는다.
나이는 정수를 넣었는데float64가 됐다. 비어 있는 값인 결측(missing value)None은NaN(Not a Number, 실수 값)으로 저장되므로 결측이 섞인 정수 열은 실수 열이 된다. 자료형을 정하지 않았을 때의 동작이고,dtype="Int64"처럼 결측을 담는 정수 자료형을 직접 지정할 수도 있다.- 문자열 열은
str이다. pandas 3부터 문자열 기본 자료형이str이고, 그 전(2.x)에는object로 표시됐다. 인터넷 예제의 문자열 열이object로 보이는 것은 이 때문이다. 다만object열에는 숫자와 문자열이 섞여 있을 수도 있으므로 실제 값을 확인한다.
열 하나는 Series(값 + index)다. 02장에서 X[:, 1]과 X[:, [1]]이 달랐던 것처럼, 대괄호 안에 이름 하나를 주면 Series, 리스트를 주면 DataFrame이 나온다.
print(type(customers["도시"]).__name__, customers["도시"].shape)print(type(customers[["도시"]]).__name__, customers[["도시"]].shape)print(customers["도시"].value_counts())print(customers.describe())Series (6,)DataFrame (6, 1)도시서울 3부산 2대구 1Name: count, dtype: int64 고객ID 나이 방문수count 6.000000 4.000000 6.000000mean 103.500000 39.500000 16.500000std 1.870829 11.150486 15.424007min 101.000000 27.000000 3.00000025% 102.250000 32.250000 5.75000050% 103.500000 39.500000 10.00000075% 104.750000 46.750000 25.500000max 106.000000 52.000000 41.000000value_counts(): 범주별 개수. 범주 열을 처음 볼 때 쓴다.describe(): 숫자 열의 요약 통계(3-7절).count가 행 수(6)보다 작으면 결측이 있다는 뜻이다.고객ID도 숫자라서 요약되지만 평균에 뜻이 없다. 숫자로 적힌 이름표일 뿐이다.
잠깐 확인 (ch03-i01)
아래 코드의 출력은?
import pandas as pd
s = pd.Series([3, None, 5])
print(s.dtype, s.count(), len(s))
int64 2 3
float64 3 3
float64 2 3
object 2 3
3-4. index와 위치
섹션 제목: “3-4. index와 위치”index는 이름표이고, 위치는 행이 지금 놓인 순번이다. 처음에는 둘이 같아 보이지만 정렬·필터를 하면 갈라진다.
| 방법 | 기준 | 슬라이스 1:3 |
|---|---|---|
df.loc[이름표, 열이름] |
index 이름표 | 지금 행 순서에서 이름표 1인 행부터 이름표 3까지, 끝 포함 |
df.iloc[위치, 열위치] |
0부터 센 위치 | 위치 1, 2, 끝 제외(파이썬과 같음) |
by_visit = customers.sort_values("방문수", ascending=False)print(by_visit[["고객ID", "방문수"]])print(by_visit.loc[0, "고객ID"], by_visit.iloc[0]["고객ID"])print(customers.loc[1:3, "고객ID"].tolist(), customers.iloc[1:3]["고객ID"].tolist()) 고객ID 방문수5 106 411 102 300 101 123 104 84 105 52 103 3101 106[102, 103, 104] [102, 103]loc 슬라이스는 숫자 범위가 아니라 현재 행 순서를 따른다. 정렬된 by_visit에서 loc[1:3]은 이름표 1, 0, 3인 행이다(이름표 2는 그 사이에 없다). 정렬 뒤 loc[0]은 “이름표가 0인 행”(고객 101)이고 iloc[0]은 “지금 맨 위 행”(고객 106)이다. “방문수 1등 고객”을 원했다면 iloc[0]이 맞다.
잠깐 확인 (ch03-i02)
아래 코드의 출력은?
import pandas as pd
df = pd.DataFrame({"점수": [70, 95, 80]}, index=[10, 20, 30])
s = df.sort_values("점수", ascending=False)
print(s.iloc[0]["점수"], s.loc[30, "점수"])
70 80
95 80
95 70
오류가 난다
idxmax와 argmax
섹션 제목: “idxmax와 argmax”최댓값의 이름표는 idxmax(), 위치는 argmax()가 준다. 걸러 낸 표에서는 둘이 다르다.
seoul = customers[customers["도시"] == "서울"]print(seoul[["고객ID", "방문수"]])i_label, i_pos = seoul["방문수"].idxmax(), seoul["방문수"].argmax()print(i_label, i_pos)print(seoul.loc[i_label, "고객ID"], seoul.iloc[i_pos]["고객ID"])print(seoul.loc[i_pos, "고객ID"]) # 위치를 loc에 넣음: 오류 없이 다른 고객 고객ID 방문수0 101 122 103 35 106 415 2106 106103마지막 줄이 함정이다. 위치 2를 이름표로 넣었더니 마침 이름표 2(고객 103)가 있어서 오류 없이 틀린 고객이 나왔다. 규칙: idxmax·idxmin은 loc와, argmax·argmin은 iloc와 짝을 맞춘다. 이 규칙은 이름표가 겹치지 않을 때 행 하나를 돌려준다. 이름표가 중복되면 loc가 여러 행을 내고, 최댓값이 여럿이면 처음 나온 것을 고르며, 모두 결측인 열에는 오류가 난다.
잠깐 확인 (ch03-i03)
서울 고객만 걸러 낸 seoul(이름표 0, 2, 5)에서 방문수가 가장 많은 고객의 행을 바르게 꺼내는 코드는?
seoul.loc[seoul["방문수"].argmax()]seoul.iloc[seoul["방문수"].idxmax()]customers.iloc[seoul["방문수"].argmax()]seoul.loc[seoul["방문수"].idxmax()]
이름표를 바꾸거나 다시 매기기
섹션 제목: “이름표를 바꾸거나 다시 매기기”by_id = customers.set_index("고객ID") # 고객ID를 이름표로print(by_id.loc[103, "도시"])print(seoul.reset_index(drop=True)[["고객ID", "방문수"]]) # 0부터 다시 매김, 옛 이름표는 버림서울 고객ID 방문수0 101 121 103 32 106 41set_index로 의미 있는 열을 이름표로 쓰면 loc[103]처럼 읽기 쉽다. 걸러 낸 뒤 0부터 다시 매기려면 reset_index(drop=True)를 쓴다(drop=True가 없으면 옛 이름표가 index 열로 남는다).
이름표는 계산에서도 쓰인다. Series끼리 계산하거나 Series를 열에 대입하면 위치가 아니라 같은 이름표끼리 맞춘다. 02장의 NumPy 배열과 다른 점이다.
a = pd.Series([1, 2], index=[0, 1])b = pd.Series([10, 20], index=[1, 0])print((a + b).tolist()) # 이름표 0: 1 + 20, 이름표 1: 2 + 10[21, 12]3-5. 선택·필터·대입
섹션 제목: “3-5. 선택·필터·대입”조건으로 행 고르기
섹션 제목: “조건으로 행 고르기”조건식은 행마다 참/거짓인 불리언 Series를 만든다. 02장의 불리언 마스크와 같다.
mask = (customers["도시"] == "서울") & (customers["방문수"] >= 10)print(mask.tolist())print(customers.loc[mask, ["고객ID", "방문수"]])print(customers[customers["등급"].isin(["골드", "실버"])]["고객ID"].tolist())print(customers[customers["방문수"].between(5, 12)]["고객ID"].tolist()) # 5 이상 12 이하print(customers[~(customers["도시"] == "서울")]["고객ID"].tolist()) # ~: 아닌 것[True, False, False, False, False, True] 고객ID 방문수0 101 125 106 41[101, 102, 104, 106][101, 104, 105][102, 104, 105]- 그리고
&, 또는|, 아님~. 파이썬의and·or·not은 Series에 쓸 수 없다. - 조건마다 괄호를 친다.
&가==·>=보다 먼저 계산되기 때문이다.
잠깐 확인 (ch03-i04)
부산 또는 대구 고객 가운데 방문수가 10 미만인 행을 고르는 코드로 옳은 것은?
customers[customers["도시"].isin(["부산", "대구"]) and customers["방문수"] < 10]customers[customers["도시"].isin(["부산", "대구"]) & customers["방문수"] < 10]customers[(customers["도시"].isin(["부산", "대구"])) & (customers["방문수"] < 10)]customers[(customers["도시"] == "부산" | "대구") & (customers["방문수"] < 10)]
try: customers[customers["도시"] == "서울" & customers["방문수"] >= 10]except TypeError: print("TypeError: 괄호 없이 쓰면 \"서울\" & customers[\"방문수\"]부터 계산된다")TypeError: 괄호 없이 쓰면 "서울" & customers["방문수"]부터 계산된다값 바꾸기: loc 한 번으로
섹션 제목: “값 바꾸기: loc 한 번으로”새 열은 이름에 대입하면 생긴다. 조건에 맞는 행만 바꿀 때는 df.loc[조건, 열] = 값을 한 번에 쓴다.
customers["쿠폰"] = 0customers.loc[customers["등급"] == "골드", "쿠폰"] = 3000print(customers[["고객ID", "등급", "쿠폰"]]) 고객ID 등급 쿠폰0 101 실버 01 102 골드 30002 103 브론즈 03 104 실버 04 105 브론즈 05 106 골드 3000대괄호를 두 번 이어 쓰는 연쇄 대입(chained assignment)은 원본을 바꾸지 않는다.
import warnings
with warnings.catch_warnings(record=True) as caught: warnings.simplefilter("always") customers[customers["도시"] == "부산"]["쿠폰"] = 9999 # 연쇄 대입print(customers["쿠폰"].tolist())print(type(caught[0].message).__name__)customers = customers.drop(columns="쿠폰") # 예제용 열 지우기[0, 3000, 0, 0, 0, 3000]ChainedAssignmentErrorcustomers[조건]이 먼저 새 표를 만들고, 그 새 표의 쿠폰을 바꾼 뒤 버리기 때문이다. pandas 3부터는 Copy-on-Write가 기본이라 이 규칙이 일정하다. 골라낸 표(seoul 같은)를 고쳐도 원본은 바뀌지 않고, 원본을 바꾸려면 원본에 loc로 대입한다. 노트북에서는 위 코드가 ChainedAssignmentError 경고를 띄운다(여기서는 경고를 잡아 이름만 출력했다). pandas 2.x 예제에서 보던 SettingWithCopyWarning도 같은 문제를 알리던 경고다.
잠깐 확인 (ch03-i05)
pandas 3에서 seoul = customers[customers["도시"] == "서울"]로 고른 뒤 seoul.loc[:, "방문수"] = 0을 실행하면, customers의 서울 고객 방문수도 0이 된다.
O / X
3-6. 결측 처리
섹션 제목: “3-6. 결측 처리”print(customers.isna().sum())print(customers["나이"].mean(), customers["나이"].count(), len(customers))고객ID 0도시 0등급 0나이 2방문수 0dtype: int6439.5 4 6count()는 결측을 뺀 개수이고, mean()은 결측을 건너뛰고 4명의 평균을 낸다. 결측은 세 가지로 다룬다.
| 방법 | 코드 | 언제 | 주의 |
|---|---|---|---|
| 행 삭제 | dropna(subset=[열]) |
결측 행이 아주 적고 무작위일 때 | 데이터가 준다. 테스트·제출 행은 지울 수 없다 |
| 값 대체 | fillna(값) |
숫자 열은 중앙값·평균, 범주 열은 최빈값이나 "없음" |
대체값은 훈련 데이터에서 구한다 |
| 결측 표시 열 | isna().astype(int) |
결측 자체가 정보일 수 있을 때(나이를 안 적은 고객) | 대체와 함께 쓴다 |
대체값을 훈련·테스트를 합친 데이터에서 구하면 테스트 정보가 훈련에 섞인다. 이것을 데이터 누수(data leakage)라 하고 5장에서 자세히 다룬다. 지금은 “값은 훈련 데이터에서 구하고, 같은 값을 테스트에 쓴다”만 기억한다.
train, test = customers.iloc[:4].copy(), customers.iloc[4:].copy()age_median = train["나이"].median() # 훈련 데이터 4명 중 결측 아닌 3명의 중앙값print("훈련 중앙값", age_median, "/ 테스트 중앙값", test["나이"].median())for part in (train, test): part["나이_결측"] = part["나이"].isna().astype(int) part["나이"] = part["나이"].fillna(age_median)print(pd.concat([train, test])[["고객ID", "나이", "나이_결측"]])훈련 중앙값 34.0 / 테스트 중앙값 52.0 고객ID 나이 나이_결측0 101 34.0 01 102 34.0 12 103 27.0 03 104 45.0 04 105 52.0 05 106 34.0 1테스트의 고객 106은 테스트 중앙값(52)이 아니라 훈련 중앙값(34)으로 채웠다. 이 과정을 sklearn에서는 SimpleImputer(strategy="median", add_indicator=True)가 fit(훈련 데이터에서 중앙값 계산)과 transform(같은 값으로 채우기)으로 나눠 해 준다(5·9장).
잠깐 확인 (ch03-i06)
아래 코드의 출력은?
import pandas as pd
train = pd.Series([10.0, None, 30.0, 20.0])
test = pd.Series([None, 100.0, 200.0])
print(test.fillna(train.median()).tolist())
[30.0, 100.0, 200.0]
[20.0, 100.0, 200.0]
[150.0, 100.0, 200.0]
[nan, 100.0, 200.0]
결측이 NaN이 아닌 모양으로 오는 경우도 많다. "-", 빈 문자열, -1, 999 같은 값이다. 숫자 열에 이런 문자가 섞이면 열이 문자열(또는 object)이 되므로 pd.to_numeric(..., errors="coerce")로 숫자로 바꾸고, 바꿀 수 없는 값은 NaN으로 만든다. -1·999처럼 숫자로 적힌 결측 표시는 숫자로 바뀐 채 남으므로, 데이터 설명에서 결측 표시라고 확인했다면 replace([-1, 999], np.nan)으로 따로 바꾼다.
raw = pd.Series(["34", "-", "27", "", "45"])age = pd.to_numeric(raw, errors="coerce")print(raw.dtype, "→", age.dtype, age.tolist())str → float64 [34.0, nan, 27.0, nan, 45.0]CSV 파일이면 처음부터 pd.read_csv(경로, na_values=["-", "없음"])처럼 결측 표시를 알려 준다.
잠깐 확인 (ch03-i07)
아래 코드의 출력은?
import pandas as pd
raw = pd.Series(["5", "없음", "7"])
print(pd.to_numeric(raw, errors="coerce").mean())
6.0
오류가 난다
nan
4.0
3-7. 기술 통계
섹션 제목: “3-7. 기술 통계”수학 상자: 평균·분산·표준편차·분위수
섹션 제목: “수학 상자: 평균·분산·표준편차·분위수”값 이 있을 때:
| 통계 | 뜻 | 식 | pandas |
|---|---|---|---|
| 평균(mean) | 값의 무게중심 | s.mean() |
|
| 분산(variance) | 평균에서 떨어진 정도. 표본 분산은 편차 제곱의 합을 로 나눈다 | s.var() |
|
| 표준편차(standard deviation) | 분산의 제곱근, 원래 단위 | s.std() |
|
| 중앙값(median) | 정렬했을 때 한가운데 값 | N이 짝수면 가운데 두 값의 평균 | s.median() |
| q 분위수(quantile) | 값을 정렬했을 때 비율 에 해당하는 위치의 값. 같은 값이 많으면 그보다 작은 값의 비율은 와 크게 다를 수 있다 | 0.5 분위수 = 중앙값 | s.quantile(q) |
| 사분위 범위(IQR) | 가운데 50%가 퍼진 폭 | (0.75 분위수 − 0.25 분위수) | s.quantile(.75) - s.quantile(.25) |
x = pd.Series([3, 5, 5, 6, 8, 9, 12])print(x.mean().round(3), x.median(), x.std().round(3), x.quantile([0.25, 0.75]).tolist())x_out = pd.Series([3, 5, 5, 6, 8, 9, 120]) # 마지막 값만 120으로print(x_out.mean().round(3), x_out.median(), x_out.std().round(3), x_out.quantile([0.25, 0.75]).tolist())6.857 6.0 3.024 [5.0, 8.5]22.286 6.0 43.134 [5.0, 8.5]값 하나가 커지자 평균과 표준편차는 크게 움직였지만 중앙값과 사분위수는 그대로다. 그래서 이상치가 있을 수 있는 열의 결측은 중앙값으로 채우는 경우가 많다(3-6절). 평균이 중앙값보다 훨씬 크면 큰 값 쪽으로 꼬리가 길거나 큰 이상치가 있다는 신호다.
잠깐 확인 (ch03-i08)
다섯 값 [3, 4, 4, 5, 64]의 평균·중앙값과 해석으로 옳은 것은?
평균 4, 중앙값 16. 작은 값 쪽 꼬리가 길다
평균 16, 중앙값 4. 큰 값 쪽에 동떨어진 값이 있다
평균 16, 중앙값 16. 분포가 대칭이다
평균 16, 중앙값 4. 값의 절반이 16보다 크다
분산의 분모 함정. pandas의 std()·var()는 N − 1로 나누고(표본 분산), NumPy의 np.std와 sklearn StandardScaler는 N으로 나눈다. std()는 그렇게 구한 분산의 제곱근이고, N은 결측을 뺀 개수다.
print(round(x.std(), 4), round(np.std(x.to_numpy()), 4), round(x.std(ddof=0), 4))3.0237 2.7994 2.7994ddof(자유도 보정)로 분모를 N − ddof로 정한다. 표본이 많으면 차이가 작지만, 직접 표준화한 값과 StandardScaler 결과를 비교할 때 맞지 않는 흔한 이유다. 분위수가 두 값 사이에 걸리면 pandas는 기본으로 두 값 사이를 직선으로 보간한다.
IQR 규칙: 보다 작거나 보다 큰 값을 이상치 후보로 본다. 상자 그림(3-9절)의 수염 밖 점이 이것이다. 후보일 뿐이므로 지우기 전에 입력 오류인지 실제 값인지 확인한다.
q1, q3 = x_out.quantile(0.25), x_out.quantile(0.75)iqr = q3 - q1print(q1, q3, iqr, x_out[(x_out < q1 - 1.5 * iqr) | (x_out > q3 + 1.5 * iqr)].tolist())5.0 8.5 3.5 [120]3-8. 범주를 숫자로: 인코딩
섹션 제목: “3-8. 범주를 숫자로: 인코딩”모델은 "서울"을 계산할 수 없다. 범주 열은 숫자로 바꿔야 하는데, 범주에는 두 종류가 있다.
- 명목형(nominal): 순서가 없다. 도시, 결제 수단, 색.
- 순서형(ordinal): 순서가 있다. 등급(브론즈 < 실버 < 골드), 옷 사이즈(S < M < L).
정수 인코딩과 순서 가정
섹션 제목: “정수 인코딩과 순서 가정”범주마다 정수 하나를 주는 것이 정수 인코딩이다. 짧고 열이 늘지 않지만 숫자의 크기와 간격이 생긴다.
codes, names = pd.factorize(customers["도시"], sort=True) # 가나다순으로 0, 1, 2print(list(names), codes.tolist())grade_order = {"브론즈": 0, "실버": 1, "골드": 2} # 순서를 사람이 정한다print(customers["등급"].map(grade_order).tolist())print(pd.factorize(customers["등급"], sort=True)[1].tolist()) # 자동(가나다순)은 순서가 틀린다['대구', '부산', '서울'] [2, 1, 2, 0, 1, 2][1, 2, 0, 1, 0, 2]['골드', '브론즈', '실버']- 도시를 대구 0, 부산 1, 서울 2로 바꾸면, 선형 모델(4·6장)은 “서울 − 부산 = 부산 − 대구”이고 “서울은 대구보다 2배 떨어져 있다”고 읽는다. 가나다순일 뿐인데 없는 순서와 간격을 가정한 것이다. 명목형 범주를 선형 모델에 넣을 때는 정수 인코딩을 쓰지 않는다.
- 등급처럼 순서가 실제로 있으면 순서를 직접 정한 매핑(
map)을 쓸 수 있다. 자동으로 매기면 가나다순이라골드 < 브론즈 < 실버가 된다. 다만 0, 1, 2를 선형 모델에 넣으면 “한 단계 오를 때마다 효과가 같다”(브론즈→실버와 실버→골드가 같은 차이)는 등간격 가정까지 들어간다. 단계마다 효과가 크게 다를 수 있으면 순서형이라도 원-핫이 더 맞을 수 있다. - 결정 트리(7장)는 “값이 1.5보다 작은가”처럼 기준을 나눠 가며 배우므로 정수 인코딩의 순서 가정에 덜 민감하다. 그래도 순서 없는 범주를 정수로 넣으면 나누는 횟수가 늘어날 수 있다.
잠깐 확인 (ch03-i09)
결제 수단 열(카드·현금·포인트, 순서 없음)을 선형 회귀에 넣으려 한다. 알맞은 인코딩은?
가나다순으로 정수 0, 1, 2를 준다
원-핫 인코딩
많이 쓰인 순서대로 정수 0, 1, 2를 준다
문자열 길이를 숫자로 쓴다
원-핫 인코딩
섹션 제목: “원-핫 인코딩”원-핫(one-hot)은 범주마다 열 하나를 만들고 해당 열만 1로 둔다. 02장 텍스트의 원-핫과 같은 생각이다. 순서와 간격이 생기지 않는다.
print(pd.get_dummies(customers["도시"], prefix="도시", dtype=int)) 도시_대구 도시_부산 도시_서울0 0 0 11 0 1 02 0 0 13 1 0 04 0 1 05 0 0 1처음 보는 범주
섹션 제목: “처음 보는 범주”훈련 데이터에서 범주 목록을 정한 뒤, 테스트에 훈련에 없던 범주가 나오면 문제가 된다. get_dummies를 훈련·테스트에 따로 쓰면 열이 달라진다.
city_train = pd.Series(["서울", "부산", "서울", "대구"], name="도시")city_test = pd.Series(["부산", "광주"], name="도시")print(pd.get_dummies(city_train, dtype=int).columns.tolist())print(pd.get_dummies(city_test, dtype=int).columns.tolist())['대구', '부산', '서울']['광주', '부산']훈련은 3열, 테스트는 2열이고 열의 뜻도 다르다. 모델은 열 순서로 값을 읽으므로 이대로 넣으면 엉뚱한 결과가 나오거나 열 수가 달라 오류가 난다. 열 목록을 훈련 데이터에서 정하고 테스트를 거기에 맞춘다.
train_cols = pd.get_dummies(city_train, dtype=int).columnstest_oh = pd.get_dummies(city_test, dtype=int).reindex(columns=train_cols, fill_value=0)print(test_oh) 대구 부산 서울0 0 1 01 0 0 0reindex는 훈련 열만 남기고(광주 열은 버림), 없는 열은 0으로 채운다. 그래서 광주 행은 모두 0이다. “아는 범주 어디에도 속하지 않음”이라는 뜻이다. sklearn OneHotEncoder는 이 일을 fit(훈련 범주 기억)과 transform으로 나눠 해 준다.
from sklearn.preprocessing import OneHotEncoder
enc = OneHotEncoder(handle_unknown="ignore", sparse_output=False)enc.fit(city_train.to_frame()) # 2차원 입력: (N, 1)print(enc.get_feature_names_out().tolist())print(enc.transform(city_test.to_frame()))try: OneHotEncoder(sparse_output=False).fit(city_train.to_frame()).transform(city_test.to_frame())except ValueError as e: print("기본값(handle_unknown='error'):", e)['도시_대구', '도시_부산', '도시_서울'][[0. 1. 0.] [0. 0. 0.]]기본값(handle_unknown='error'): Found unknown categories ['광주'] in column 0 during transformhandle_unknown="ignore": 처음 보는 범주를 모두 0으로 둔다. 기본값"error"는 오류를 낸다. 시험·제출처럼 테스트 행을 하나도 빼면 안 될 때는"ignore"를 쓴다.sparse_output=False: 결과를 보통 배열로. 기본값은 0이 아닌 값만 저장하는 희소 행렬이다.- 범주가 아주 많은 열(고객ID, 우편번호)을 원-핫하면 열이 수천 개가 된다. 표본마다 다른 ID는 새 고객에게 쓸모가 없으므로 특성에서 빼고, 드문 범주는
"기타"로 묶는다(OneHotEncoder(min_frequency=...)).
잠깐 확인 (ch03-i10)
아래 코드의 출력은?
import pandas as pd
train = pd.Series(["A", "B", "A"])
test = pd.Series(["C", "B"])
cols = pd.get_dummies(train, dtype=int).columns
print(pd.get_dummies(test, dtype=int).reindex(columns=cols, fill_value=0).to_numpy().tolist())
[[0, 1], [1, 0]]
[[1, 0], [0, 1]]
오류가 난다
[[0, 0], [0, 1]]
3-9. groupby·merge·시각화
섹션 제목: “3-9. groupby·merge·시각화”groupby: 나누고, 계산하고, 합치기
섹션 제목: “groupby: 나누고, 계산하고, 합치기”groupby는 열 값으로 행을 나누고, 그룹마다 계산하고, 결과를 표로 합친다.
print(customers.groupby("도시")["방문수"].mean())print(customers.groupby("도시")["나이"].agg(["size", "count", "mean"]))summary = customers.groupby("도시").agg(고객수=("고객ID", "size"), 평균방문=("방문수", "mean"))print(summary.sort_values("고객수", ascending=False))도시대구 8.000000부산 17.500000서울 18.666667Name: 방문수, dtype: float64 size count mean도시대구 1 1 45.0부산 2 1 52.0서울 3 2 30.5 고객수 평균방문도시서울 3 18.666667부산 2 17.500000대구 1 8.000000- 결과의 index는 그룹 값(도시)이다. 기본으로 가나다순 정렬된다.
size는 결측을 포함한 행 수,count는 결측을 뺀 개수다. 서울 고객 3명 중 나이 정보가 있는 고객은 2명이다.agg(새이름=(열, 함수))로 여러 집계에 이름을 붙인다.
그룹 결과를 원래 행마다 붙이려면 transform을 쓴다. 결과가 원래 표와 같은 index를 가진다.
city_mean = customers.groupby("도시")["방문수"].transform("mean")print(pd.DataFrame({"고객ID": customers["고객ID"], "도시평균": city_mean.round(1), "평균대비": (customers["방문수"] - city_mean).round(1)})) 고객ID 도시평균 평균대비0 101 18.7 -6.71 102 17.5 12.52 103 18.7 -15.73 104 8.0 0.04 105 17.5 -12.55 106 18.7 22.3“같은 도시 평균보다 얼마나 더 왔나” 같은 특성을 만들 때 쓴다(특성 공학, 9장).
merge: 두 표 합치기
섹션 제목: “merge: 두 표 합치기”주문 표에는 고객ID만 있고 도시는 고객 표에 있다. 공통 열(키)로 두 표를 합친다.
orders = pd.DataFrame({ "주문ID": [1, 2, 3, 4, 5, 6, 7, 8], "고객ID": [101, 103, 101, 106, 102, 107, 103, 106], "금액": [12000, 5000, 8000, 30000, 15000, 7000, 4000, 22000],})merged = orders.merge(customers[["고객ID", "도시"]], on="고객ID", how="left", validate="many_to_one", indicator=True)print(merged)print(len(orders), len(merged)) 주문ID 고객ID 금액 도시 _merge0 1 101 12000 서울 both1 2 103 5000 서울 both2 3 101 8000 서울 both3 4 106 30000 서울 both4 5 102 15000 부산 both5 6 107 7000 NaN left_only6 7 103 4000 서울 both7 8 106 22000 서울 both8 8how="left": 왼쪽(주문) 행을 모두 남긴다. 고객 표에 없는 107은 도시가NaN이다.how="inner"는 양쪽에 다 있는 키만 남겨 주문 6이 사라진다.indicator=True: 행마다 어느 쪽에서 왔는지(both,left_only) 알려 주는_merge열. 짝을 못 찾은 행을 찾을 때 쓴다.validate="many_to_one": “오른쪽 표의 키는 겹치지 않는다”를 확인한다. 주문은 한 고객이 여러 번 할 수 있으니 many, 고객 표는 한 고객이 한 줄이니 one이다.
키가 중복되면 행이 불어난다. 고객 표에 고객 103이 두 번 들어간 경우(주소 변경 때 새 줄을 추가했다든지)를 보자.
dup = pd.concat([customers, customers[customers["고객ID"] == 103]])bad = orders.merge(dup[["고객ID", "도시"]], on="고객ID", how="left")print(len(orders), len(bad), orders["금액"].sum(), bad["금액"].sum())try: orders.merge(dup[["고객ID", "도시"]], on="고객ID", how="left", validate="many_to_one")except pd.errors.MergeError as e: print("MergeError:", str(e).splitlines()[0])print(dup["고객ID"].duplicated().sum())8 10 103000 112000MergeError: Merge keys are not unique in right dataset; not a many-to-one merge1고객 103의 주문 2건이 각각 2줄이 되어 행이 8 → 10, 매출 합계가 9000원 늘었다. 오류는 나지 않는다. 그래서 합친 뒤에는 행 수와 합계를 확인하고, validate로 키 중복을 미리 막는다. 중복은 duplicated()로 찾고, 어느 줄을 남길지 정해 drop_duplicates("고객ID", keep="last")처럼 정리한다.
합친 표로 도시별 매출을 구하면 두 기능이 이어진다.
print(merged.groupby("도시", dropna=False)["금액"].sum())도시부산 15000서울 81000NaN 7000Name: 금액, dtype: int64dropna=False를 주지 않으면 도시가 NaN인 주문(고객 107)이 집계에서 조용히 빠진다.
잠깐 확인 (ch03-i11)
아래 코드의 출력은?
import pandas as pd
orders = pd.DataFrame({"고객ID": [1, 1, 2], "금액": [100, 200, 300]})
cust = pd.DataFrame({"고객ID": [1, 1, 2], "도시": ["서울", "서울", "부산"]})
m = orders.merge(cust, on="고객ID", how="left")
print(len(m), m["금액"].sum())
3 600
5 900
4 600
오류가 난다
시각화로 데이터 보기
섹션 제목: “시각화로 데이터 보기”숫자 요약만으로는 분포 모양과 관계를 놓치기 쉽다. 모델을 만들기 전에 세 가지 그림을 먼저 본다. sklearn에 들어 있는 당뇨병 데이터(환자 442명, 1년 뒤 병 진행 정도 target)로 그린다.
import matplotlib.pyplot as pltfrom sklearn.datasets import load_diabetes
dia = load_diabetes(as_frame=True, scaled=False).frameprint(dia.shape)print(dia[["age", "bmi", "target"]].describe().round(1))dia["bmi_구간"] = pd.cut(dia["bmi"], bins=[0, 25, 30, 100], labels=["25 이하", "25 초과~30 이하", "30 초과"])print(dia["bmi_구간"].value_counts(sort=False).tolist())print(dia.groupby("bmi_구간", observed=True)["target"].median().tolist())print(dia[["age", "bmi", "bp", "target"]].corr()["target"].round(2).tolist())(442, 11) age bmi targetcount 442.0 442.0 442.0mean 48.5 26.4 152.1std 13.1 4.4 77.1min 19.0 18.0 25.025% 38.2 23.2 87.050% 50.0 25.7 140.575% 59.0 29.3 211.5max 79.0 42.2 346.0[190, 157, 95][96.0, 172.0, 230.0][0.19, 0.59, 0.44, 1.0]pd.cut: 숫자를 구간 범주로 나눈다.bins=[0, 25, 30, 100]은 (0, 25], (25, 30], (30, 100] 세 구간이다(오른쪽 끝 포함).observed=True: 구간 범주로 묶을 때 실제로 있는 그룹만 결과에 넣는다.corr(): 두 열이 직선으로 함께 움직이는 정도인 상관계수(기본은 피어슨, −1~1). 양수면 같은 방향, 음수면 반대 방향이고 절댓값이 클수록 관계가 강하다. 0.59인bmi가target과 가장 같이 움직인다. 상관은 직선 관계만 보고, 원인을 뜻하지 않는다. 0에 가까워도 곡선 관계는 있을 수 있고, 값이 하나뿐인 열은NaN이 나온다.
plt.rcParams["font.family"] = "Malgun Gothic" # Windows 한글 글꼴(없으면 제목 한글이 네모로 나온다)plt.rcParams["axes.unicode_minus"] = Falsefig, axes = plt.subplots(1, 3, figsize=(12, 3.4))dia["target"].plot.hist(bins=30, ax=axes[0], title="target 분포 (히스토그램)")dia.boxplot(column="target", by="bmi_구간", ax=axes[1])axes[1].set_title("bmi 구간별 target (상자 그림)")dia.plot.scatter(x="bmi", y="target", s=8, alpha=0.5, ax=axes[2], title="bmi와 target (산점도)")fig.suptitle("")fig.tight_layout()print([ax.get_title() for ax in axes])plt.close(fig)['target 분포 (히스토그램)', 'bmi 구간별 target (상자 그림)', 'bmi와 target (산점도)']← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
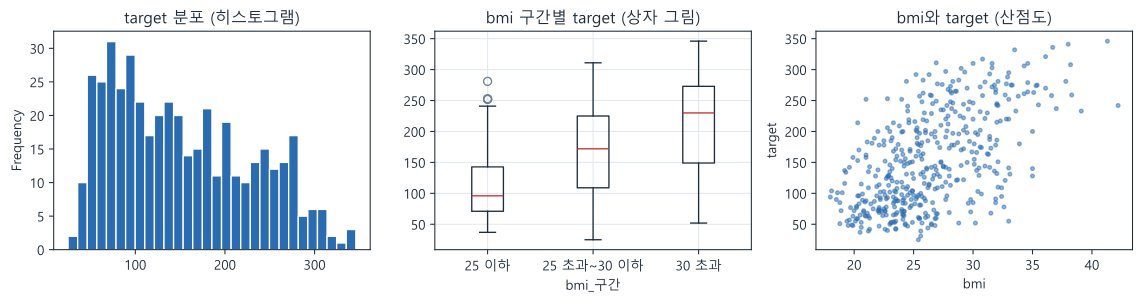
그림 설명. 세 그림이 나란히 있다. 왼쪽 히스토그램은 가로축이 target(25~346), 세로축이 구간별 환자 수(Frequency)이고, 50~100 사이에 많이 몰리며(가장 높은 막대는 약 68~79 구간, 31명) 오른쪽으로 꼬리가 길다. 가운데 상자 그림은 가로축이 bmi 구간 세 개(25 이하 190명, 25 초과~30 이하 157명, 30 초과 95명), 세로축이 target이고, 상자 안 중앙값 선이 96 → 172 → 230으로 오른다. 25 이하 구간에는 수염 위쪽에 이상치 후보 점이 몇 개 있다. 오른쪽 산점도는 가로축이 bmi(18~42), 세로축이 target이고, 점들이 오른쪽 위로 퍼진 띠를 이룬다(상관계수 0.59).
| 그림 | 보는 것 | 위 그림에서 |
|---|---|---|
| 히스토그램(histogram) | 값 하나의 분포: 모양, 치우침, 동떨어진 값 | 왼쪽에 몰리고 오른쪽 꼬리가 길다. 평균(152.1)이 중앙값(140.5)보다 크다 |
| 상자 그림(box plot) | 그룹별 중앙값·사분위 범위·이상치 후보 비교 | bmi 구간이 올라갈수록 target 중앙값이 오른다 |
| 산점도(scatter plot) | 두 숫자 열의 관계 | 오른쪽 위로 퍼진 띠. 관계는 있지만 흩어짐이 크다 |
상자 그림의 상자는 Q1~Q3, 가운데 선은 중앙값, 수염은 1.5×IQR 안의 가장 먼 값, 수염 밖 점은 이상치 후보다(3-7절). 노트북에서는 plt.close(fig) 대신 셀 끝에 fig를 두거나 plt.show()로 그림을 본다.
3-10. 표에서 모델 입력까지
섹션 제목: “3-10. 표에서 모델 입력까지”이 장의 도구를 모으면 문자열·결측이 섞인 표를 02장의 (N, d) 숫자 배열로 만들 수 있다.
X = customers[["도시", "등급", "나이", "방문수"]].copy()X["나이_결측"] = X["나이"].isna().astype(int)X["나이"] = X["나이"].fillna(X["나이"].median()) # 실제로는 훈련 데이터의 중앙값(3-6절)X["등급"] = X["등급"].map(grade_order) # 순서형: 직접 정한 정수X = pd.get_dummies(X, columns=["도시"], dtype=int) # 명목형: 원-핫print(X)arr = X.to_numpy(dtype=float)print(arr.shape, arr.dtype, X.columns.tolist()) 등급 나이 방문수 나이_결측 도시_대구 도시_부산 도시_서울0 1 34.0 12 0 0 0 11 2 39.5 30 1 0 1 02 0 27.0 3 0 0 0 13 1 45.0 8 0 1 0 04 0 52.0 5 0 0 1 05 2 39.5 41 1 0 0 1(6, 7) float64 ['등급', '나이', '방문수', '나이_결측', '도시_대구', '도시_부산', '도시_서울']고객ID는 특성에서 뺐다. 고객마다 다른 이름표라 크기에 뜻이 없고, 처음 보는 고객에게 쓸 수 없기 때문이다. to_numpy()가 02장의 배열을 돌려준다. 열 이름은 배열에 없으므로 X.columns를 함께 남겨 둔다. 이 과정을 훈련·테스트에 같은 규칙으로 적용하는 방법(ColumnTransformer, Pipeline)은 9장에서 묶는다.
잠깐 확인 (ch03-i12)
3-10절에서 모델 입력을 만들 때 고객ID 열을 특성에서 뺐다. 그 이유로 가장 알맞은 것은?
정수 열이라 원-핫이 필요한데, 원-핫하면 열이 하나만 생기기 때문이다
고객마다 다른 이름표라 크기에 뜻이 없고, 처음 보는 고객에게 쓸 수 없기 때문이다
숫자 열 중 평균이 가장 커서 다른 특성보다 모델에 큰 영향을 주기 때문이다
결측이 있는 열이라 중앙값으로 채울 수 없기 때문이다
3-11. 선택 기준표에 추가
섹션 제목: “3-11. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 숫자 열에 결측이 있다 | 훈련 데이터의 중앙값으로 채우고, 결측 자체가 정보일 수 있으면 결측 표시 열을 더한다 | 행 삭제는 데이터를 줄이고 테스트·제출 행에는 쓸 수 없다. 중앙값은 이상치에 덜 흔들린다 | 03 |
| 순서 없는 범주(도시·결제 수단)를 모델에 넣는다 | 원-핫. 범주 목록은 훈련 데이터에서 정하고 처음 보는 범주는 모두 0(handle_unknown="ignore") |
정수 인코딩은 없는 순서·간격을 만든다(트리 모델은 덜 민감, 07장) | 03 |
| 순서 있는 범주(등급·사이즈), 단계마다 효과가 비슷하다고 볼 수 있다 | 순서를 직접 정한 정수 매핑(map). 단계별 효과가 크게 다를 수 있으면 원-핫 |
자동 매기기는 가나다순이라 순서가 틀린다. 정수는 선형 모델에 등간격을 가정시킨다 | 03 |
| 범주 종류가 아주 많다(ID·우편번호) | 표본마다 다른 ID는 특성에서 빼고, 드문 범주는 “기타”로 묶는다 | 원-핫 열이 폭발하고, ID는 새 표본에 일반화되지 않는다 | 03 |
| 두 표를 합친다 | merge(validate=...) + 전후 행 수·합계 확인 |
키가 중복되면 오류 없이 행이 불어난다 | 03 |
확인 문제
섹션 제목: “확인 문제”문제 1 (ch03-e01)
customers 표에서 도시 열 하나를 shape (6, 1)인 2차원 표로 꺼내려면 customers[____]의 빈칸에 무엇을 쓰는가?
답: ________________
문제 2 (ch03-e02)
아래 코드의 출력은?
import pandas as pd
df = pd.DataFrame({"x": [5, 6, 7, 8]})
print(df.loc[1:2, "x"].tolist(), df.iloc[1:2]["x"].tolist())
[6, 7] [6]
[6] [6]
[6, 7] [6, 7]
[6] [6, 7]
문제 3 (ch03-e03)
pandas 3에서 customers[customers["등급"] == "골드"]["쿠폰"] = 3000을 실행하면 골드 고객의 쿠폰 열이 3000으로 바뀐다.
O / X
문제 4 (ch03-e04)
제출할 테스트 데이터의 소득 열에 결측이 있다. 소득에는 아주 큰 값이 가끔 있고, 소득을 적지 않은 것 자체가 신호일 수 있다. 어떻게 처리하는가?
결측이 있는 테스트 행을 지운다
훈련 데이터의 중앙값으로 채우고, 결측 표시 열을 더한다
테스트 데이터의 평균으로 채운다
훈련·테스트를 합친 데이터의 중앙값으로 채운다
문제 5 (ch03-e05)
아래 코드의 출력은?
import numpy as np
import pandas as pd
s = pd.Series([2.0, 4.0, 6.0])
print(s.std(), np.std(s.to_numpy()).round(3))
1.633 2.0
2.0 1.633
2.0 2.0
1.633 1.633
문제 6 (ch03-e06)
어떤 열의 Q1이 10, Q3이 20이다. IQR 규칙으로 이상치 후보가 되는 값은?
0
-4
34
36
문제 7 (ch03-e07)
옷 사이즈 열(S·M·L)을 pd.factorize(..., sort=True)로 자동 정수화하면 S < M < L 순서의 정수가 붙는다.
O / X
문제 8 (ch03-e08)
아래 코드의 출력은?
import pandas as pd
df = pd.DataFrame({"팀": ["A", "A", "A", "B"], "점수": [10, None, 30, 5]})
r = df.groupby("팀")["점수"].agg(["size", "count", "mean"])
print(r.loc["A"].tolist())
[3.0, 3.0, 13.333333333333334]
[2.0, 2.0, 20.0]
[3.0, 2.0, 20.0]
[3.0, 2.0, 13.333333333333334]
문제 9 (ch03-e09)
bmi 구간 세 개(그룹)마다 target의 중앙값·퍼짐·이상치 후보를 한눈에 비교하려면 어떤 그림을 그리는가?
산점도
상자 그림
히스토그램
선 그래프
문제 10 (ch03-e10)
당뇨병 데이터에서 bmi와 target의 상관계수가 0.59이므로, bmi가 높아지면 target이 높아진다는 원인 관계가 확인됐다.
O / X
문제 11 (ch03-e11)
주문 표의 우편번호 열에 6천 종류가 있고 대부분 한두 번만 나온다. 선택 기준표에 따르면 어떻게 하는가?
6천 개 열로 원-핫 인코딩한다
가나다순 정수 인코딩으로 열 하나에 담는다
드문 우편번호는 "기타"로 묶은 뒤 원-핫한다
결측 표시 열만 남긴다
3-12. 실습과 문제
섹션 제목: “3-12. 실습과 문제”실습/문제/ch03_표_데이터_다루기_pandas.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 정렬 뒤 loc·iloc·idxmin·argmin 결과 예측 |
| 2 | 코드 | 조건 필터와 loc 대입(연쇄 대입 피하기) |
| 3 | 코드 | 훈련 중앙값으로 결측 채우기 + 결측 표시 열 |
| 4 | 개념 | 기술 통계 참/거짓(이상치, 분모, 결측) |
| 5 | 코드 | 훈련 범주 기준 원-핫, 처음 보는 범주 |
| 6 | 코드 | groupby 집계와 transform |
| 7 | 코드 | 중복 키 정리 후 merge, 행 수·합계 확인 |
| 8 | 코드 | IQR 규칙으로 이상치 후보 찾기 + 상자 그림 |
| 9 | 사례 | 병합 뒤 매출이 부푼 원인 진단 |
| 10 | 사례 | 열마다 인코딩 방법 고르기 |
3-13. 공식 문서와 참고 자료
섹션 제목: “3-13. 공식 문서와 참고 자료”- pandas 10분 입문: https://pandas.pydata.org/docs/user_guide/10min.html
- 인덱싱과 선택(
loc·iloc): https://pandas.pydata.org/docs/user_guide/indexing.html - Copy-on-Write: https://pandas.pydata.org/docs/user_guide/copy_on_write.html
- 결측 데이터: https://pandas.pydata.org/docs/user_guide/missing_data.html
- group by: https://pandas.pydata.org/docs/user_guide/groupby.html
- merge·join·concat: https://pandas.pydata.org/docs/user_guide/merging.html
- 시각화: https://pandas.pydata.org/docs/user_guide/visualization.html
pandas.Series.std: https://pandas.pydata.org/docs/reference/api/pandas.Series.std.htmlpandas.get_dummies: https://pandas.pydata.org/docs/reference/api/pandas.get_dummies.html- scikit-learn 범주 인코딩: https://scikit-learn.org/stable/modules/preprocessing.html#encoding-categorical-features
- scikit-learn
SimpleImputer: https://scikit-learn.org/stable/modules/generated/sklearn.impute.SimpleImputer.html - 당뇨병 데이터
load_diabetes: https://scikit-learn.org/stable/modules/generated/sklearn.datasets.load_diabetes.html