01장에서 붓꽃 표와 손글씨 이미지를 모델에 넣었다. 그때 모델이 받은 것은 모두 NumPy 배열이었다. 모델은 숫자만 받는다. 표·사진·글은 모두 숫자 배열로 바뀐 뒤 모델에 들어간다. 이 장에서는 그 배열을 다루는 라이브러리 NumPy의 핵심 규칙 세 가지, 모양(shape)과 축(axis), 브로드캐스팅(broadcasting), 벡터화(vectorization)를 익히고, 표·이미지·텍스트가 각각 어떤 모양의 배열이 되는지 살펴본다.
2-1. 이 장의 목표와 완료 기준
섹션 제목: “2-1. 이 장의 목표와 완료 기준”| 목표 | 완료 기준 |
|---|---|
| 배열의 shape·축·dtype을 읽는다 | sum(axis=…), 인덱싱, reshape의 결과 shape를 실행 전에 맞힌다 |
| 브로드캐스팅 규칙을 쓴다 | 두 shape가 계산되는지, 결과 shape가 무엇인지 판단하고, 열별 표준화·행별 비율을 루프 없이 쓴다 |
| 반복 계산을 벡터화한다 | 거리·내적·코사인 유사도를 루프 대신 브로드캐스팅과 행렬곱으로 계산한다 |
| 데이터가 배열이 되는 방식을 안다 | 표·흑백/컬러 이미지·텍스트의 배열 모양을 말하고, 축 순서((H, W, C) ↔ (C, H, W))를 바꾼다 |
| 선택 기준표에 줄을 더한다 | 데이터 종류별로 어떤 배열 표현을 쓰고 무엇을 확인할지 고른다 |
| 실습 노트북 02를 끝낸다 | 실습/문제/ch02_데이터를_숫자로_NumPy.ipynb의 점검 셀이 모두 “통과”를 출력한다 |
예상 시간: 원고 1시간 30분, 실습 1시간 30분.
2-2. 왜 NumPy인가
섹션 제목: “2-2. 왜 NumPy인가”- scikit-learn 모델은 NumPy 배열을 입력으로 받고 배열을 돌려준다.
- PyTorch의 텐서(10장)는 shape·축·브로드캐스팅 규칙이 NumPy와 거의 같다. 이 장의 규칙은 딥러닝·LLM 장까지 그대로 쓰인다.
- 모델이 틀린 답을 낼 때 원인이 모양인 경우가 많다. 축을 잘못 골라도 오류 없이 엉뚱한 숫자가 나오기 때문이다. 이 장에서 “실행 전에 shape를 예측하고, 실행 후 확인하는” 습관을 들인다.
파이썬 리스트와 NumPy 배열은 같은 연산자에 다르게 반응한다.
import numpy as np
lst = [1, 2, 3]arr = np.array([1, 2, 3])print(lst * 2, arr * 2)print(lst + [10], arr + 10)[1, 2, 3, 1, 2, 3] [2 4 6][1, 2, 3, 10] [11 12 13]리스트의 *·+는 이어 붙이기이고, 배열에서는 원소마다 따로 계산한다.
잠깐 확인 (ch02-i01)
아래 코드의 출력은?
import numpy as np
print([1, 2] * 2, np.array([1, 2]) * 2)
[2, 4] [2 4]
[1, 2, 1, 2] [2 4]
[1, 2, 1, 2] [1 2 1 2]
오류가 난다
2-3. 배열의 기본: shape·dtype
섹션 제목: “2-3. 배열의 기본: shape·dtype”| 용어 | 뜻 | 확인 |
|---|---|---|
| 배열(ndarray) | 같은 dtype 값이 격자 모양으로 놓인 묶음 | type(a) |
| 차원 수(ndim) | 축의 개수 | a.ndim |
| 모양(shape) | 축마다 길이를 적은 튜플 | a.shape |
| 크기(size) | 전체 원소 수 = shape의 곱 | a.size |
| 자료형(dtype) | 원소의 종류(int64, float32, uint8 등) |
a.dtype |
a = np.array([[1, 2, 3], [4, 5, 6]])print(a)print("shape", a.shape, "ndim", a.ndim, "size", a.size, "dtype", a.dtype)print(np.zeros((2, 3)))print(np.arange(0, 10, 3), np.linspace(0, 1, 5))rng = np.random.default_rng(0) # 난수 생성기. 같은 시드면 같은 수print(rng.normal(size=(2, 3)).round(2))[[1 2 3] [4 5 6]]shape (2, 3) ndim 2 size 6 dtype int64[[0. 0. 0.] [0. 0. 0.]][0 3 6 9] [0. 0.25 0.5 0.75 1. ][[ 0.13 -0.13 0.64] [ 0.1 -0.54 0.36]]np.zeros(shape): 0으로 채운 배열(기본 dtypefloat64).np.arange(시작, 끝, 간격): 파이썬range처럼 끝값은 빼고 간격만큼 증가.np.linspace(시작, 끝, 개수): 끝값을 포함해 같은 간격으로개수개.rng.normal(size=...): 평균 0, 표준편차 1인 정규분포에서 뽑은 난수. 시드(default_rng(0)의 0)가 같으면 매번 같은 수가 나온다.
shape (2, 3)은 “축 0의 길이 2, 축 1의 길이 3”이다. 2차원이면 축 0이 행, 축 1이 열이다.
dtype 함정
섹션 제목: “dtype 함정”x = np.array([1, 2, 3])x[0] = 2.7print(x) # 정수 배열에 실수를 넣으면 소수점이 잘린다pix = np.array([200, 250], dtype=np.uint8) # 이미지 픽셀에 흔한 0~255 정수print(pix + 100) # 255를 넘으면 256으로 나눈 나머지가 된다print(pix.astype(np.float32) / 255) # 실수로 바꾼 뒤 계산[2 2 3][44 94][0.78431374 0.98039216]uint8은 부호 없는 8비트 정수로 0~255만 담는다. 200+100이 44가 되어도 오류도 경고도 나지 않는다. 이미지 밝기를 바꾸거나 평균을 낼 때는 먼저 astype(np.float32)로 바꾼다.
잠깐 확인 (ch02-i02)
아래 코드의 출력은? (NumPy 2.x)
import numpy as np
a = np.array([250, 10], dtype=np.uint8)
print(a + 10)
[260 20]
[255 20]
[ 4 20]
오류가 난다
2-4. shape와 축
섹션 제목: “2-4. shape와 축”← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
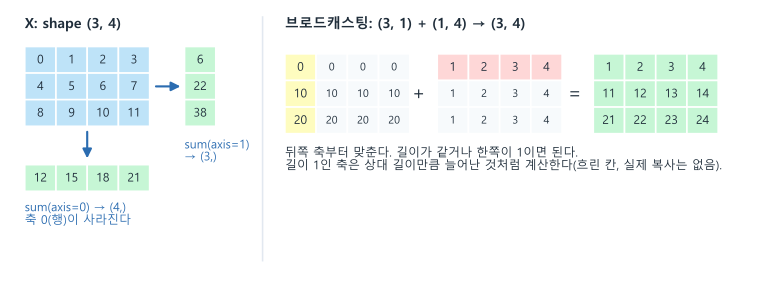
그림 설명. 왼쪽은 0~11이 든 (3, 4) 배열 X다. 아래로 합친 sum(axis=0)은 열마다 하나씩 [12, 15, 18, 21] (4,)이 되어 축 0(행)이 사라진다. 옆으로 합친 sum(axis=1)은 행마다 하나씩 [6, 22, 38] (3,)이다. 오른쪽은 (3, 1)인 [0, 10, 20] 열과 (1, 4)인 [1, 2, 3, 4] 행을 더하는 브로드캐스팅이다. 흐린 칸은 길이 1인 축이 상대 길이만큼 늘어난 것처럼 계산되는 자리이고(실제 복사는 없다), 결과는 (3, 4) 배열 [[1, 2, 3, 4], [11, 12, 13, 14], [21, 22, 23, 24]]이다.
인덱싱과 슬라이싱
섹션 제목: “인덱싱과 슬라이싱”X = np.arange(12).reshape(3, 4)print(X)print(X[1], X[:, 1], X[1, 2])print(X[0:2, 1:3].shape, X[:, 1].shape, X[:, [1]].shape)print(X[X % 2 == 0]) # 불리언 마스크: 조건에 맞는 원소만 1차원으로print(X[[0, 2]]) # 정수 리스트: 0행과 2행[[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]][4 5 6 7] [1 5 9] 6(2, 2) (3,) (3, 1)[ 0 2 4 6 8 10][[ 0 1 2 3] [ 8 9 10 11]]X[:, 1]은 열 하나를 1차원 (3,)으로 꺼내고, X[:, [1]]은 2차원 (3, 1)을 유지한다. 정수 하나로 고른 축은 사라지고, 슬라이스나 리스트로 고른 축은 남는다.
축을 따라 집계하기
섹션 제목: “축을 따라 집계하기”axis=k로 집계하면 k번 축이 사라진다. 2차원에서 axis=0은 “행들을 위아래로 합쳐 열마다 하나”, axis=1은 “열들을 옆으로 합쳐 행마다 하나”다.
print(X.sum(axis=0), X.sum(axis=0).shape)print(X.sum(axis=1), X.sum(axis=1).shape)print(X.sum(axis=1, keepdims=True).shape) # 사라질 축을 길이 1로 남긴다imgs = np.zeros((10, 8, 8)) # 8×8 흑백 이미지 10장print(imgs.mean(axis=0).shape, imgs.mean(axis=(1, 2)).shape)[12 15 18 21] (4,)[ 6 22 38] (3,)(3, 1)(8, 8) (10,)imgs.mean(axis=0)은 10장을 겹친 평균 이미지 (8, 8)이고, imgs.mean(axis=(1, 2))는 이미지마다 평균 밝기 (10,)이다. 같은 mean이라도 축에 따라 뜻이 전혀 다르다.
잠깐 확인 (ch02-i03)
컬러 동영상 30프레임이 frames에 shape (30, 64, 64, 3)(프레임, 높이, 너비, 채널 RGB)으로 들어 있다. 채널마다 전체 평균(빨강·초록·파랑 평균 3개, 결과 shape (3,))을 구하는 코드는?
frames.mean(axis=3)frames.mean(axis=(0, 1, 2))frames.mean(axis=(1, 2))frames.mean(axis=0)
reshape와 transpose는 다르다
섹션 제목: “reshape와 transpose는 다르다”print(X.reshape(4, 3))print(X.T)print(np.array_equal(X.reshape(4, 3), X.T))print(X.reshape(-1).shape, X.reshape(2, -1).shape) # -1: 나머지로 계산[[ 0 1 2] [ 3 4 5] [ 6 7 8] [ 9 10 11]][[ 0 4 8] [ 1 5 9] [ 2 6 10] [ 3 7 11]]False(12,) (2, 6)둘 다 (4, 3)이지만 내용이 다르다. reshape는 원소를 읽는 순서(행 우선)를 그대로 둔 채 다시 자르고, transpose(.T)는 축을 맞바꾼다. 이미지 축 순서를 바꿀 때 reshape를 쓰면 오류 없이 그림이 뒤섞인다(2-7절). reshape 전후의 전체 원소 수는 같아야 하고(12개를 (5, 3)으로는 못 자른다), -1은 한 축에만 쓸 수 있다.
뷰와 복사
섹션 제목: “뷰와 복사”Y = np.arange(6).reshape(2, 3)row = Y[0]row[0] = 100print(Y) # 슬라이스는 뷰: 원본도 바뀐다safe = Y[1].copy()safe[0] = -1print(Y) # copy()는 따로 복사[[100 1 2] [ 3 4 5]][[100 1 2] [ 3 4 5]]슬라이스는 원본 메모리를 함께 쓰는 뷰(view)다. 원본을 지켜야 하면 .copy()를 쓴다. 불리언 마스크·정수 리스트 인덱싱은 항상 복사본을 만든다.
잠깐 확인 (ch02-i04)
아래 코드의 출력은?
import numpy as np
A = np.zeros(3)
B = A[:2]
B[0] = 5
print(A)
[0. 0. 0.]
[5. 5. 0.]
[5. 0. 0.]
오류가 난다
2-5. 브로드캐스팅
섹션 제목: “2-5. 브로드캐스팅”모양이 다른 두 배열을 계산할 때 NumPy는 아래 규칙으로 맞춘다.
- 두 shape를 뒤쪽 축부터 짝지어 본다. 축 수가 적은 쪽은 앞에 길이 1인 축이 있다고 본다.
- 짝지은 축마다 길이가 같거나, 한쪽이 1이면 된다. 아니면 오류다.
- 길이 1인 축은 상대 길이만큼 늘어난 것처럼 계산한다(실제로 복사하지는 않는다).
| 왼쪽 | 오른쪽 | 결과 |
|---|---|---|
(3, 4) |
(4,) |
(3, 4): 행마다 같은 벡터를 더함 |
(3, 4) |
(3, 1) |
(3, 4): 열마다 같은 벡터를 더함 |
(3, 4) |
(3,) |
오류: 뒤쪽 축 4와 3 |
(3, 1) |
(1, 4) |
(3, 4): 양쪽 다 늘어남 |
(2, 1, 5) |
(3, 1) |
(2, 3, 5) |
열별 표준화: (N, d)와 (d,)
섹션 제목: “열별 표준화: (N, d)와 (d,)”특성마다 단위가 다르면(키 cm와 연봉 원) 열마다 평균을 빼고 표준편차로 나눠 크기를 맞춘다. 이것을 표준화(standardization)라 한다(학습에 주는 영향은 4장).
X = np.array([[1., 200.], [2., 300.], [3., 400.]]) # 표본 3개, 특성 2개mean, std = X.mean(axis=0), X.std(axis=0)print(mean, std, mean.shape)Z = (X - mean) / std # (3, 2)와 (2,) → 열마다 같은 값을 쓴다print(Z.round(3))print(Z.mean(axis=0).round(3), Z.std(axis=0).round(3))[ 2. 300.] [ 0.81649658 81.64965809] (2,)[[-1.225 -1.225] [ 0. 0. ] [ 1.225 1.225]][0. 0.] [1. 1.]값이 모두 같은 열은 표준편차가 0이라 그대로 나누면 nan이 된다. sklearn의 StandardScaler는 이런 열의 나누는 값을 1로 두어 평균을 뺀 0을 그대로 남긴다.
행별 비율: keepdims가 필요한 경우
섹션 제목: “행별 비율: keepdims가 필요한 경우”행마다 합이 1이 되게 나누려면 행 합 (N,)을 (N, 1)로 만들어야 한다. 개수처럼 음수가 없는 값에서 쓰는 계산이고, 행 합이 0인 행은 나눌 수 없으므로(nan) 따로 처리한다.
counts = np.array([[2, 1, 1], [0, 3, 1]]) # (2, 3)try: counts / counts.sum(axis=1) # (2, 3)과 (2,): 뒤쪽 축 3과 2except ValueError as e: print("오류:", e)print(counts / counts.sum(axis=1, keepdims=True)) # (2, 3)과 (2, 1)오류: operands could not be broadcast together with shapes (2,3) (2,)[[0.5 0.25 0.25] [0. 0.75 0.25]]더 위험한 것은 정사각 행렬이다. 축 길이가 우연히 같으면 오류 없이 틀린 답이 나온다.
sq = np.array([[1., 3.], [2., 6.]]) # 행 합 4, 8wrong = sq / sq.sum(axis=1) # 오류 없음. [4, 8]이 열마다 나누는 값으로 쓰였다right = sq / sq.sum(axis=1, keepdims=True) # (2, 1): 행마다 자기 합으로 나눔print(wrong, "행 합", wrong.sum(axis=1))print(right, "행 합", right.sum(axis=1))[[0.25 0.375] [0.5 0.75 ]] 행 합 [0.625 1.25 ][[0.25 0.75] [0.25 0.75]] 행 합 [1. 1.]계산 뒤에는 “행 합이 정말 1인가”처럼 결과의 성질을 한 줄로 확인한다.
잠깐 확인 (ch02-i05)
다음 중 브로드캐스팅으로 계산되지 않고 오류가 나는 짝은?
(4, 3)과(3,)(4, 3)과(4, 1)(4, 3)과(4,)(1, 3)과(4, 1)
거리 행렬: 새 축을 넣어 모든 쌍 계산
섹션 제목: “거리 행렬: 새 축을 넣어 모든 쌍 계산”None(= np.newaxis)을 인덱스에 넣으면 그 자리에 길이 1인 축이 생긴다. 질의 점 Q (m, d)와 데이터 점 P (n, d)의 모든 쌍 거리를 루프 없이 구한다.
P = np.array([[0., 0.], [3., 4.], [1., 1.]]) # 데이터 점 3개 (n=3, d=2)Q = np.array([[0., 1.], [3., 3.]]) # 질의 점 2개 (m=2)diff = Q[:, None, :] - P[None, :, :] # (2, 1, 2) - (1, 3, 2) → (2, 3, 2)D = np.sqrt((diff ** 2).sum(axis=-1)) # 마지막 축(좌표)을 합침 → (2, 3)print(diff.shape, D.shape)print(D.round(3))print(D.argmin(axis=1)) # 질의마다 가장 가까운 점의 번호(2, 3, 2) (2, 3)[[1. 4.243 1. ] [4.243 1. 2.828]][0 1]D[i, j]는 질의 i와 점 j의 거리다. 첫 질의는 점 0과 점 2까지 거리가 똑같이 1인데, argmin은 최솟값이 여럿이면 먼저 나온 번호(0)를 돌려준다. 이것이 k-최근접 이웃(kNN, 8장)의 핵심 계산이다. 중간 배열 diff는 m×n×d개 원소를 담으므로, m·n이 크면 메모리가 부족해진다. 그때는 질의를 몇 묶음으로 나눠 계산한다.
잠깐 확인 (ch02-i06)
행마다 합이 1이 되게 나누려고 아래 코드를 썼다. 출력은?
import numpy as np
sq = np.array([[1., 1.], [2., 6.]])
r = sq / sq.sum(axis=1)
print(r.sum(axis=1))
[1. 1.]
오류가 난다
[2. 8.]
[0.625 1.75 ]
2-6. 벡터화와 행렬곱
섹션 제목: “2-6. 벡터화와 행렬곱”루프 vs 벡터화
섹션 제목: “루프 vs 벡터화”같은 계산을 원소마다 파이썬 루프로 돌리는 것과, 배열 연산 한 번으로 하는 것을 비교한다.
import time
data = np.random.default_rng(0).normal(size=1_000_000)t0 = time.perf_counter()total = 0.0for v in data: total += v * vt_loop = time.perf_counter() - t0t0 = time.perf_counter()total_vec = (data * data).sum()t_vec = time.perf_counter() - t0print(f"루프 {t_loop:.3f}초, 벡터화 {t_vec:.4f}초, 약 {t_loop / t_vec:.0f}배")루프 0.217초, 벡터화 0.0026초, 약 83배print(np.isclose(total, total_vec)) # 결과는 같다(부동소수점 오차 범위)True벡터화된 연산은 반복을 C로 작성된 NumPy 내부에서 처리한다. 숫자는 PC마다 다르지만 이 PC에서는 수십 배 이상 차이가 났다. 원소 수와 반복 횟수가 커질수록(학습은 같은 계산을 수천 번 반복한다) 이 차이가 누적된다.
수학 상자: 벡터·행렬·내적·노름
섹션 제목: “수학 상자: 벡터·행렬·내적·노름”| 개념 | 식 | NumPy | 어디에 쓰나 |
|---|---|---|---|
| 벡터 | 숫자 d개를 나열한 것, 표본 하나 = 특성 벡터 | shape (d,) |
표본, 가중치, 임베딩 |
| 내적(dot product) | a @ b |
선형 모델의 예측(4·6장) | |
| 노름(norm, 길이) | np.linalg.norm(a) |
거리, 정규화(6장) | |
| 코사인 유사도 | , −1~1 (두 벡터 모두 영벡터가 아닐 때) | 정규화 후 내적 | 임베딩 검색(17장) |
| 행렬곱 | @ → , 결과 = A의 행과 B의 열의 내적 | A @ B |
신경망 층(10장), 어텐션(14장) |
a = np.array([1., 2., 2.])b = np.array([2., 0., 1.])print(a @ b, np.linalg.norm(a), np.sqrt(a @ a))print(round((a @ b) / (np.linalg.norm(a) * np.linalg.norm(b)), 3))4.0 3.0 3.00.596선형 모델의 예측은 행렬곱 한 번에 절편을 더한 것이다. 표본 N개의 특성 X (N, d)와 가중치 w (d,)를 곱하면 표본마다 가중합 하나가 나오고, 여기에 모든 표본에 공통인 절편 b를 더한다(4장).
X = np.array([[1., 2.], [3., 4.], [5., 6.]]) # (3, 2): 표본 3개, 특성 2개w = np.array([0.5, -1.0]) # (2,)b = 2.0print(X @ w + b) # (3, 2) @ (2,) → (3,)W = np.array([[1., 0., -1.], [0., 1., 1.]]) # (2, 3): 출력 3개짜리 층print((X @ W).shape) # (3, 2) @ (2, 3) → (3, 3)[ 0.5 -0.5 -1.5](3, 3)행렬곱은 안쪽 두 길이가 같아야 한다((3, 2) @ (2, 3)의 2). 결과 shape는 바깥쪽 두 길이다. 이것은 두 입력이 모두 2차원일 때의 규칙이다. 1차원 벡터끼리 (d,) @ (d,)는 내적 숫자 하나, (N, d) @ (d,)는 행마다 내적한 (N,)이다.
잠깐 확인 (ch02-i07)
특성 X가 (100, 4), 가중치 w가 (4,), 절편 b가 숫자 하나일 때 X @ w + b의 shape는?
(4,)(100, 4)오류가 난다
(100,)
코사인 유사도 검색: 각 행을 자기 노름으로 나눠 길이를 1로 맞춘 뒤 행렬곱 한 번이면 모든 쌍의 유사도가 나온다. 코사인 유사도는 두 벡터가 모두 영벡터가 아닐 때만 정의된다. 영벡터 행은 노름이 0이라 나누면 nan이 되므로 미리 빼거나 유사도를 0으로 둔다.
docs = np.array([[1., 0., 1.], [0., 2., 0.], [1., 1., 1.]]) # 문서 벡터 3개query = np.array([[2., 0., 2.]]) # 질의 1개dn = docs / np.linalg.norm(docs, axis=1, keepdims=True)qn = query / np.linalg.norm(query, axis=1, keepdims=True)sim = qn @ dn.T # (1, 3) @ (3, 3) → (1, 3)print(sim.round(3))print(np.argsort(-sim[0])) # 유사도 높은 순 문서 번호[[1. 0. 0.816]][0 2 1]질의는 문서 0과 방향이 같아 유사도 1이다. 길이(크기)는 달라도 방향이 같으면 1이 된다. 이것이 거리 대신 코사인을 쓰는 이유다(17장).
잠깐 확인 (ch02-i08)
영벡터가 아닌 두 벡터 a와 b의 코사인 유사도는, a 대신 3 * a를 넣어도 변하지 않는다.
O / X
2-7. 표·이미지·텍스트가 배열이 되는 방식
섹션 제목: “2-7. 표·이미지·텍스트가 배열이 되는 방식”← 좌우로 밀거나, 그림을 누른 뒤 ← → 키로 옮겨 전체를 본다
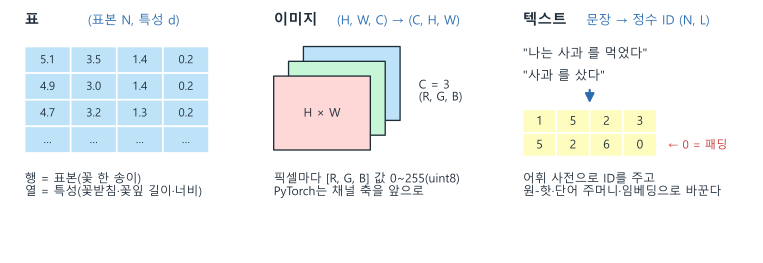
그림 설명. 세 칸이 나란히 있다. 표는 행이 표본(꽃 한 송이), 열이 특성(꽃받침·꽃잎 길이·너비)인 (N, d) 배열이다. 이미지는 높이 H × 너비 W 격자가 빨강·초록·파랑 세 장 겹친 (H, W, C) 배열로, 픽셀마다 0~255 값이 있고 PyTorch는 채널 축을 앞으로 옮긴 (C, H, W)를 쓴다. 텍스트는 “나는 사과 를 먹었다”, “사과 를 샀다”가 어휘 사전으로 정수 ID [1, 5, 2, 3], [5, 2, 6, 0]이 된 (N, L) 배열이고, 짧은 문장 끝의 0은 패딩이다. 이 ID를 원-핫·단어 주머니·임베딩으로 바꿔 모델에 넣는다.
표: (표본 수, 특성 수)
섹션 제목: “표: (표본 수, 특성 수)”from sklearn.datasets import load_iris, load_digits
iris = load_iris()print(iris.data.shape, iris.data.dtype)print(iris.data[:2])(150, 4) float64[[5.1 3.5 1.4 0.2] [4.9 3. 1.4 0.2]]행이 표본, 열이 특성이다. sklearn 모델은 이 2차원 모양을 받는다. 표본 하나만 예측할 때도 x.reshape(1, -1)로 (1, 특성 수)를 만들어 넣는다. 이 자료에서 쓰는 대부분의 모델에는 문자열 범주(도시 이름 등)를 숫자로 바꿔 넣는다(03장). 범주형 열을 직접 받는 모델도 일부 있다.
이미지: 흑백 (H, W), 컬러 (H, W, C)
섹션 제목: “이미지: 흑백 (H, W), 컬러 (H, W, C)”흑백 이미지는 높이 H × 너비 W 격자에 밝기를 담은 2차원 배열이다. 1장에서 본 손글씨 숫자가 그렇다.
digits = load_digits()print(digits.images.shape, digits.images.dtype, digits.images.min(), digits.images.max())flat = digits.images.reshape(len(digits.images), -1) # (N, 8, 8) → (N, 64)print(flat.shape, np.array_equal(flat, digits.data))(1797, 8, 8) float64 0.0 16.0(1797, 64) True(N, 8, 8)을 (N, 64)로 펴면 픽셀 하나가 특성 하나인 표가 된다. 1장의 로지스틱 회귀가 이렇게 받은 입력이다. 편 배열도 너비를 알면 원래 위치로 되돌릴 수 있지만, 이 표를 받는 선형 모델은 “어느 픽셀이 위아래로 이웃인가”를 따로 쓰지 않는다. 이웃 관계를 구조로 쓰는 모델은 12장 CNN이다.
컬러 이미지는 픽셀마다 빨강·초록·파랑(RGB) 세 값이 있어 채널(channel) 축 C가 하나 더 생긴다. 축을 놓는 순서는 라이브러리마다 다르다.
| 쓰는 곳 | 한 장 | 묶음(배치) | 값 |
|---|---|---|---|
Pillow RGB 이미지 → np.asarray |
(H, W, C) |
(N, H, W, C) |
uint8 0~255 |
PyTorch 모델 입력 (torchvision ToTensor에 uint8 (H, W, C)를 넣은 결과) |
(C, H, W) |
(N, C, H, W) |
float32 0~1 |
같은 (H, W, C)라도 읽는 방법마다 dtype·값 범위가 다르다. 예를 들어 matplotlib imread는 PNG를 float32 0~1로 읽는다. 그래서 읽은 직후 shape·dtype·min()·max()를 출력해 확인한다.
img = np.zeros((4, 6, 3), dtype=np.uint8) # 높이 4, 너비 6, 채널 3(RGB)img[:, :3, 0] = 255 # 왼쪽 절반: 빨강 채널 최대img[:, 3:, 2] = 255 # 오른쪽 절반: 파랑 채널 최대print(img.shape, img[0, 0], img[0, 5]) # 픽셀 하나 = [R, G, B]chw = img.transpose(2, 0, 1) # (H, W, C) → (C, H, W)print(chw.shape)print(chw[0]) # 빨강 채널 한 장print(np.array_equal(img.reshape(3, 4, 6)[0], chw[0])) # reshape로는 채널이 분리되지 않는다batch = np.stack([img, img[:, ::-1]]) # 원본과 좌우 뒤집은 것 2장 → 새 축print(batch.shape)(4, 6, 3) [255 0 0] [ 0 0 255](3, 4, 6)[[255 255 255 0 0 0] [255 255 255 0 0 0] [255 255 255 0 0 0] [255 255 255 0 0 0]]False(2, 4, 6, 3)transpose(2, 0, 1)은 “새 축 0 = 옛 축 2(C), 새 축 1 = 옛 축 0(H), 새 축 2 = 옛 축 1(W)“이다. np.stack은 같은 모양 배열들을 새 축으로 쌓아 배치를 만든다(이미 있는 축으로 이어 붙이는 것은 np.concatenate).
잠깐 확인 (ch02-i09)
아래 코드의 출력은?
import numpy as np
img = np.zeros((32, 48, 3))
print(img.transpose(2, 0, 1).shape)
(3, 48, 32)
(48, 3, 32)
(3, 32, 48)
(32, 3, 48)
텍스트: 단어 → 정수 ID → 배열
섹션 제목: “텍스트: 단어 → 정수 ID → 배열”글은 먼저 단위(여기서는 띄어쓰기로 나눈 단어, 16장에서는 토큰)로 자르고, 어휘 사전(vocabulary)으로 각 단어에 정수 ID를 준다. 문장마다 길이가 다르므로 짧은 문장 뒤를 패딩(padding) ID로 채워 (N, L) 배열을 만든다.
sentences = ["나는 사과 를 먹었다", "나는 바나나 를 샀다", "사과 를 샀다"]vocab = sorted({w for s in sentences for w in s.split()})word_to_id = {w: i + 1 for i, w in enumerate(vocab)} # 0은 패딩용으로 비워 둔다print(word_to_id)ids = [[word_to_id[w] for w in s.split()] for s in sentences]L = max(len(seq) for seq in ids)padded = np.zeros((len(ids), L), dtype=np.int64)for i, seq in enumerate(ids): padded[i, :len(seq)] = seqprint(padded){'나는': 1, '를': 2, '먹었다': 3, '바나나': 4, '사과': 5, '샀다': 6}[[1 5 2 3] [1 4 2 6] [5 2 6 0]]정수 ID는 이름표일 뿐 크기에 뜻이 없다(ID 5인 “사과”가 ID 2인 “를”보다 큰 것이 아니다). 그래서 모델에 넣을 때는 두 가지 방법을 쓴다.
- 원-핫(one-hot): 길이 V(어휘 수)짜리 0 벡터에서 ID 위치만 1. 대각선만 1이고 나머지가 0인 단위행렬
np.eye(V)의 행을 ID로 고르면 된다. ID 하나가 길이 V인 행 하나로 바뀌므로(N, L)ID 배열은(N, L, V)가 된다. - 단어 주머니(bag of words): 문장의 원-핫을 모두 더한 단어 개수 벡터. 문장 하나가
(V,), 묶음이(N, V)표가 된다.
V = len(vocab) + 1 # 패딩 0 포함onehot = np.eye(V, dtype=int)[padded] # (3, 4) 정수 배열로 행을 고름 → (3, 4, 7)print(onehot.shape)print(onehot[2]) # 세 번째 문장: 마지막 줄은 패딩(ID 0)bow = onehot.sum(axis=1) # 단어 축을 합침 → (3, 7)bow[:, 0] = 0 # 패딩 개수는 지운다print(bow)(3, 4, 7)[[0 0 0 0 0 1 0] [0 0 1 0 0 0 0] [0 0 0 0 0 0 1] [1 0 0 0 0 0 0]][[0 1 1 1 0 1 0] [0 1 1 0 1 0 1] [0 0 1 0 0 1 1]]이 방법은 작은 어휘에서 원리를 보기 위한 것이다. 어휘가 5만 개면 np.eye(V)만으로 약 20GB(int64)이므로, 실제로는 단어 개수를 바로 세거나 0이 대부분인 표를 압축해 담는 희소 행렬을 쓴다. 단어 주머니는 순서를 버린다. 순서만 다른 두 문장은 같은 벡터가 된다.
a = "철수 가 영희 를 도왔다".split()b = "영희 가 철수 를 도왔다".split()print(sorted(a) == sorted(b)) # 단어 개수가 같으면 단어 주머니도 같다True주제 분류처럼 “어떤 단어가 나왔나”가 중요한 과제에는 단어 주머니 + 고전 머신러닝이 빠르고 쓸 만한 기준선이다. 누가 누구를 도왔는지처럼 순서가 뜻을 바꾸는 과제에는 순서를 다루는 모델(13장 RNN, 14장 트랜스포머)과 단어마다 학습된 벡터인 임베딩(13·17장)을 쓴다.
잠깐 확인 (ch02-i10)
띄어쓰기로 나눈 단어로 단어 주머니를 만들 때, 같은 벡터가 되는 두 문장은?
"개 가 고양이 를 쫓았다" / "고양이 가 개 를 쫓았다"
"나는 밥 을 먹었다" / "나는 밥 을 먹는다"
"비 가 온다" / "비 가 많이 온다"
"사과 를 샀다" / "사과 를 팔았다"
2-8. 선택 기준표에 추가
섹션 제목: “2-8. 선택 기준표에 추가”| 상황 | 고를 것 | 이유 | 장 |
|---|---|---|---|
| 표 데이터를 모델에 넣는다 | (표본 수, 특성 수) 2차원 숫자 배열 |
sklearn 모델이 받는 모양. 표본 하나도 (1, 특성 수). 문자열 범주는 숫자로 바꾼다(03장) |
02 |
| 이미지를 모델에 넣는다 | 라이브러리가 기대하는 축 순서·dtype·값 범위부터 확인 | Pillow RGB 이미지를 np.asarray로 바꾸면 (H, W, 3) uint8 0~255, PyTorch는 (N, C, H, W) float. 축 순서는 transpose로 바꾼다(reshape 아님) |
02 |
| 글을 분류하는데 단어 순서는 크게 중요하지 않다 | 단어 주머니(단어 개수 벡터) + 고전 머신러닝 | 만들기 쉽고 빠른 기준선. 순서가 뜻을 바꾸면 시퀀스 모델·임베딩(13~17장) | 02 |
| 표본마다 같은 계산을 반복한다 | 파이썬 루프 대신 벡터화(브로드캐스팅·행렬곱) | 훨씬 빠르고 코드가 짧다. 중간 배열이 너무 크면 묶음으로 나눠 계산 | 02 |
확인 문제
섹션 제목: “확인 문제”문제 1 (ch02-e01)
np.arange(2, 20, 5)의 마지막 원소는 ____이다.
답: ________________
문제 2 (ch02-e02)
아래 코드의 출력은?
import numpy as np
X = np.arange(12).reshape(3, 4)
print(X[:, 2].shape, X[:, [2]].shape, X[1:, 2:].shape)
(3,) (3, 1) (2, 2)
(3, 1) (3, 1) (2, 2)
(3,) (3,) (2, 2)
(3,) (3, 1) (1, 2)
문제 3 (ch02-e03)
X = np.arange(24).reshape(4, 6)일 때 X.reshape(6, 4)와 X.T를 비교한 설명으로 옳은 것은?
둘은 shape도 내용도 같다
shape는 다르지만 내용(원소 순서)은 같다
둘 다 원소를 행 우선 순서로 읽어 다시 자른다
shape는
(6, 4)로 같지만,X.T만 행과 열을 맞바꾼 것이다
문제 4 (ch02-e04)
shape (5, 1, 4)인 배열과 (3, 1)인 배열을 더한 결과의 shape는?
(5, 1, 4)
(3, 5, 4)
(5, 3, 4)
오류가 난다
문제 5 (ch02-e05)
행마다 합이 1이 되게 하려고 M / M.sum(axis=1)을 썼다. 오류가 나지 않았다면 결과는 맞다.
O / X
문제 6 (ch02-e06)
질의 점 Q (1000, 64)와 데이터 점 P (5000, 64)의 모든 쌍 거리를 구하려고, 먼저 diff = Q[:, None, :] - P[None, :, :]로 좌표 차이를 만든다. 중간 배열 diff의 원소 수는?
1000 × 5000
1000 × 5000 × 64
1000 × 64 + 5000 × 64
64
문제 7 (ch02-e07)
float64 난수 100만 개의 제곱합을 파이썬 for 루프로 구한 total과 (data * data).sum()으로 구한 total_vec이 같은지 확인할 때는, total == total_vec보다 np.isclose(total, total_vec)가 알맞다.
O / X
문제 8 (ch02-e08)
아래 코드의 출력은?
import numpy as np
a = np.array([3., 4.])
print(np.linalg.norm(a), a @ a)
25.0 5.0
5.0 25.0
7.0 25.0
5.0 7.0
문제 9 (ch02-e09)
Pillow로 읽은 RGB 이미지 묶음 batch가 shape (N, H, W, 3), dtype uint8(0~255)이다. PyTorch 모델 입력 형식 (N, C, H, W), float32 0~1로 바꾸는 코드는?
batch.reshape(N, 3, H, W) / 255batch.astype(np.float32) / 255batch.transpose(0, 3, 1, 2)batch.transpose(0, 3, 1, 2).astype(np.float32) / 255
문제 10 (ch02-e10)
뉴스 기사 1만 건을 스포츠·경제·정치로 분류하는 첫 기준선을 빨리 만들려고 한다. 어떤 단어가 나왔는지가 주로 중요하다. 선택 기준표에 따르면?
기사마다 패딩한 정수 ID 배열
(N, L)을 그대로 특성으로 넣는다단어 주머니(단어 개수 벡터) + 고전 머신러닝
순서를 다루는 시퀀스 모델(RNN·트랜스포머)부터 만든다
원-핫 배열
(N, L, V)를 그대로 sklearn 모델에 넣는다
문제 11 (ch02-e11)
특성 4개로 학습한 sklearn 모델에 꽃 한 송이를 예측할 때는 shape (4,)인 배열을 그대로 넣는다.
O / X
2-9. 실습과 문제
섹션 제목: “2-9. 실습과 문제”실습/문제/ch02_데이터를_숫자로_NumPy.ipynb를 .venv 커널로 열고 위에서부터 푼다. 내려받기가 없고 CPU로 1분 안에 끝난다. 다 푼 뒤 해설 노트북과 비교한다.
| 번호 | 유형 | 내용 |
|---|---|---|
| 1 | 개념 | 집계·인덱싱·reshape 결과 shape 예측 |
| 2 | 개념 | 브로드캐스팅 가능 여부 판단 |
| 3 | 코드 | 열별 표준화(sklearn StandardScaler와 비교) |
| 4 | 코드 | 행별 비율(keepdims) |
| 5 | 코드 | 브로드캐스팅으로 최근접 점 찾기 → 붓꽃 1-최근접 이웃 분류 |
| 6 | 코드 | 코사인 유사도 행렬 → 손글씨 숫자 유사 이미지 검색 |
| 7 | 코드 | 이미지 배치를 모델 입력 (N, C, H, W) float로 변환 |
| 8 | 코드 | 패딩된 ID 배열에서 단어 주머니 만들기 |
| 9 | 사례 | 오류 없이 엉뚱한 예측을 내는 이미지 전처리 진단 |
| 10 | 사례 | 단어 주머니로 충분한 과제와 순서가 필요한 과제 |
2-10. 공식 문서와 참고 자료
섹션 제목: “2-10. 공식 문서와 참고 자료”- NumPy 입문(절대 기초): https://numpy.org/doc/stable/user/absolute_beginners.html
- NumPy 빠른 시작: https://numpy.org/doc/stable/user/quickstart.html
- 브로드캐스팅: https://numpy.org/doc/stable/user/basics.broadcasting.html
- 인덱싱: https://numpy.org/doc/stable/user/basics.indexing.html
- 뷰와 복사: https://numpy.org/doc/stable/user/basics.copies.html
- 자료형(dtype): https://numpy.org/doc/stable/user/basics.types.html
numpy.linalg.norm: https://numpy.org/doc/stable/reference/generated/numpy.linalg.norm.htmlnumpy.matmul(@): https://numpy.org/doc/stable/reference/generated/numpy.matmul.html- torchvision
ToTensor: https://docs.pytorch.org/vision/stable/generated/torchvision.transforms.ToTensor.html - scikit-learn
StandardScaler: https://scikit-learn.org/stable/modules/generated/sklearn.preprocessing.StandardScaler.html